Clay AI Claygent: zo bouwen wij er slimme workflows mee (notities van een Clay Solutions Partner)

In this post:
Vroeger omschreven we de Clay AI Claygent als een AI-agent voor research en scraping binnen Clay, die voor jou het web afzoekt. Er zit alleen zoveel meer in dat die definitie hem tekortdoet.
De Clay AI Claygent is de laag die een Clay-tabel verandert van een statisch enrichment-raster in een workflow met oordeelsvermogen. Wie hem behandelt als de ChatGPT van Clay, gebruikt hem twee keer en laat hem dan liggen. Dat is precies wat de meeste teams doen.
Het is meer dan een simpele AI-feature. GTM-teams zetten er een team van kleine, gespecialiseerde AI-workers mee in, die ze op elk moment kunnen inschakelen voor klussen die geen enkele enrichment-provider ter wereld kan doen.
Het idee is dat je er meerdere van maakt in je Clay-tabellen, elk voor een eigen klus.
Je kunt een Claygent hebben die leads kwalificeert op je rommelige criteria die in geen enkel Apollo-filter passen.
Een andere gaat op zoek naar koopsignalen in persberichten, vacaturepagina's en logomuren met klanten.
Je kunt er zelfs nog een inzetten als lookalike-finder, die bedrijven scrapet die de enrichment-providers niet in hun catalogus hebben.
Je snapt het idee.
Dit artikel is dus geen uitleg van "wat is Claygent". De docs van Clay doen dat goed, en we gaan je tijd niet verspillen aan wat daar al staat. Hier lees je hoe we Claygent bij Nebor gebruiken.
Laten we beginnen.
Let op: het onderzoek dat je reps elke ochtend met de hand doen, is precies wat een Clay AI-agent 's nachts zou moeten doen.
Checken of een bedrijf in je ICP past, de site lezen, uitzoeken wie je moet benaderen en waarom juist nu. Claygent kan dat allemaal, en in de meeste workspaces doet hij er niets van, omdat niemand tijd had om de keten te ontwerpen.
Bij Nebor zijn we Clay Solutions Partner, en de meeste bouwtijd gaat bij ons naar Claygent. We koppelen agents aan elkaar: de ene kwalificeert het account, een andere let op een trigger waar je iets mee moet en weer een andere schrijft de opener. Ze schrijven allemaal terug naar dezelfde tabel, zodat je rep een rij opent waar het antwoord al in staat.
Plan een call van 15 minuten en laten we het over je Clay-setup hebben.
Wat Claygent echt is, en waarin het verschilt van een chat-AI die kan browsen
Claygent beschrijf je het helderst door te beginnen bij de technische werking van de tool, in plaats van bij de marketingtaal.
Claygent is een agent. Daarmee bedoelen we een proces met een doel, een browser, een set tools en een vaste vorm voor de output.
Hij stippelt een researchroute over het web uit, navigeert tussen pagina's, beoordeelt of elke pagina de data bevat die hij zoekt en besluit of hij verder moet.
Het onderscheid dat je scherp moet hebben: een agent en een LLM zijn twee verschillende dingen, ook al gebruiken de meeste mensen de termen door elkaar.
Claude en ChatGPT zijn taalmodellen, en de huidige topmodellen (GPT-5.5 en Claude Opus 4.7) kunnen allebei het web op, externe tools gebruiken en zelfstandig onderzoek in meerdere stappen doen. De nieuwste versies doen in een losse chatsessie al veel van wat Claygent doet.
Claygent verdient zijn plek doordat hij voor één specifieke klus is gebouwd: een agent op schaal loslaten op elke rij van een Clay-tabel, gestructureerde output teruggeven in getypeerde kolommen en die output doorgeven aan de volgende stap in een workflow.
Dat klinkt beperkt, al is het precies de vorm van bijna elk echt GTM-dataprobleem.
Vraag je GPT-5.5 of Claude Opus 4.8 “zoek het prijsmodel van dit bedrijf”, dan krijg je een alinea tekst. Vraag je Claygent hetzelfde voor 500 bedrijven in een Clay-tabel, dan krijg je 500 getypeerde cellen waarop je kunt sorteren, filteren en vertakken, en die je verder kunt doorgeven.
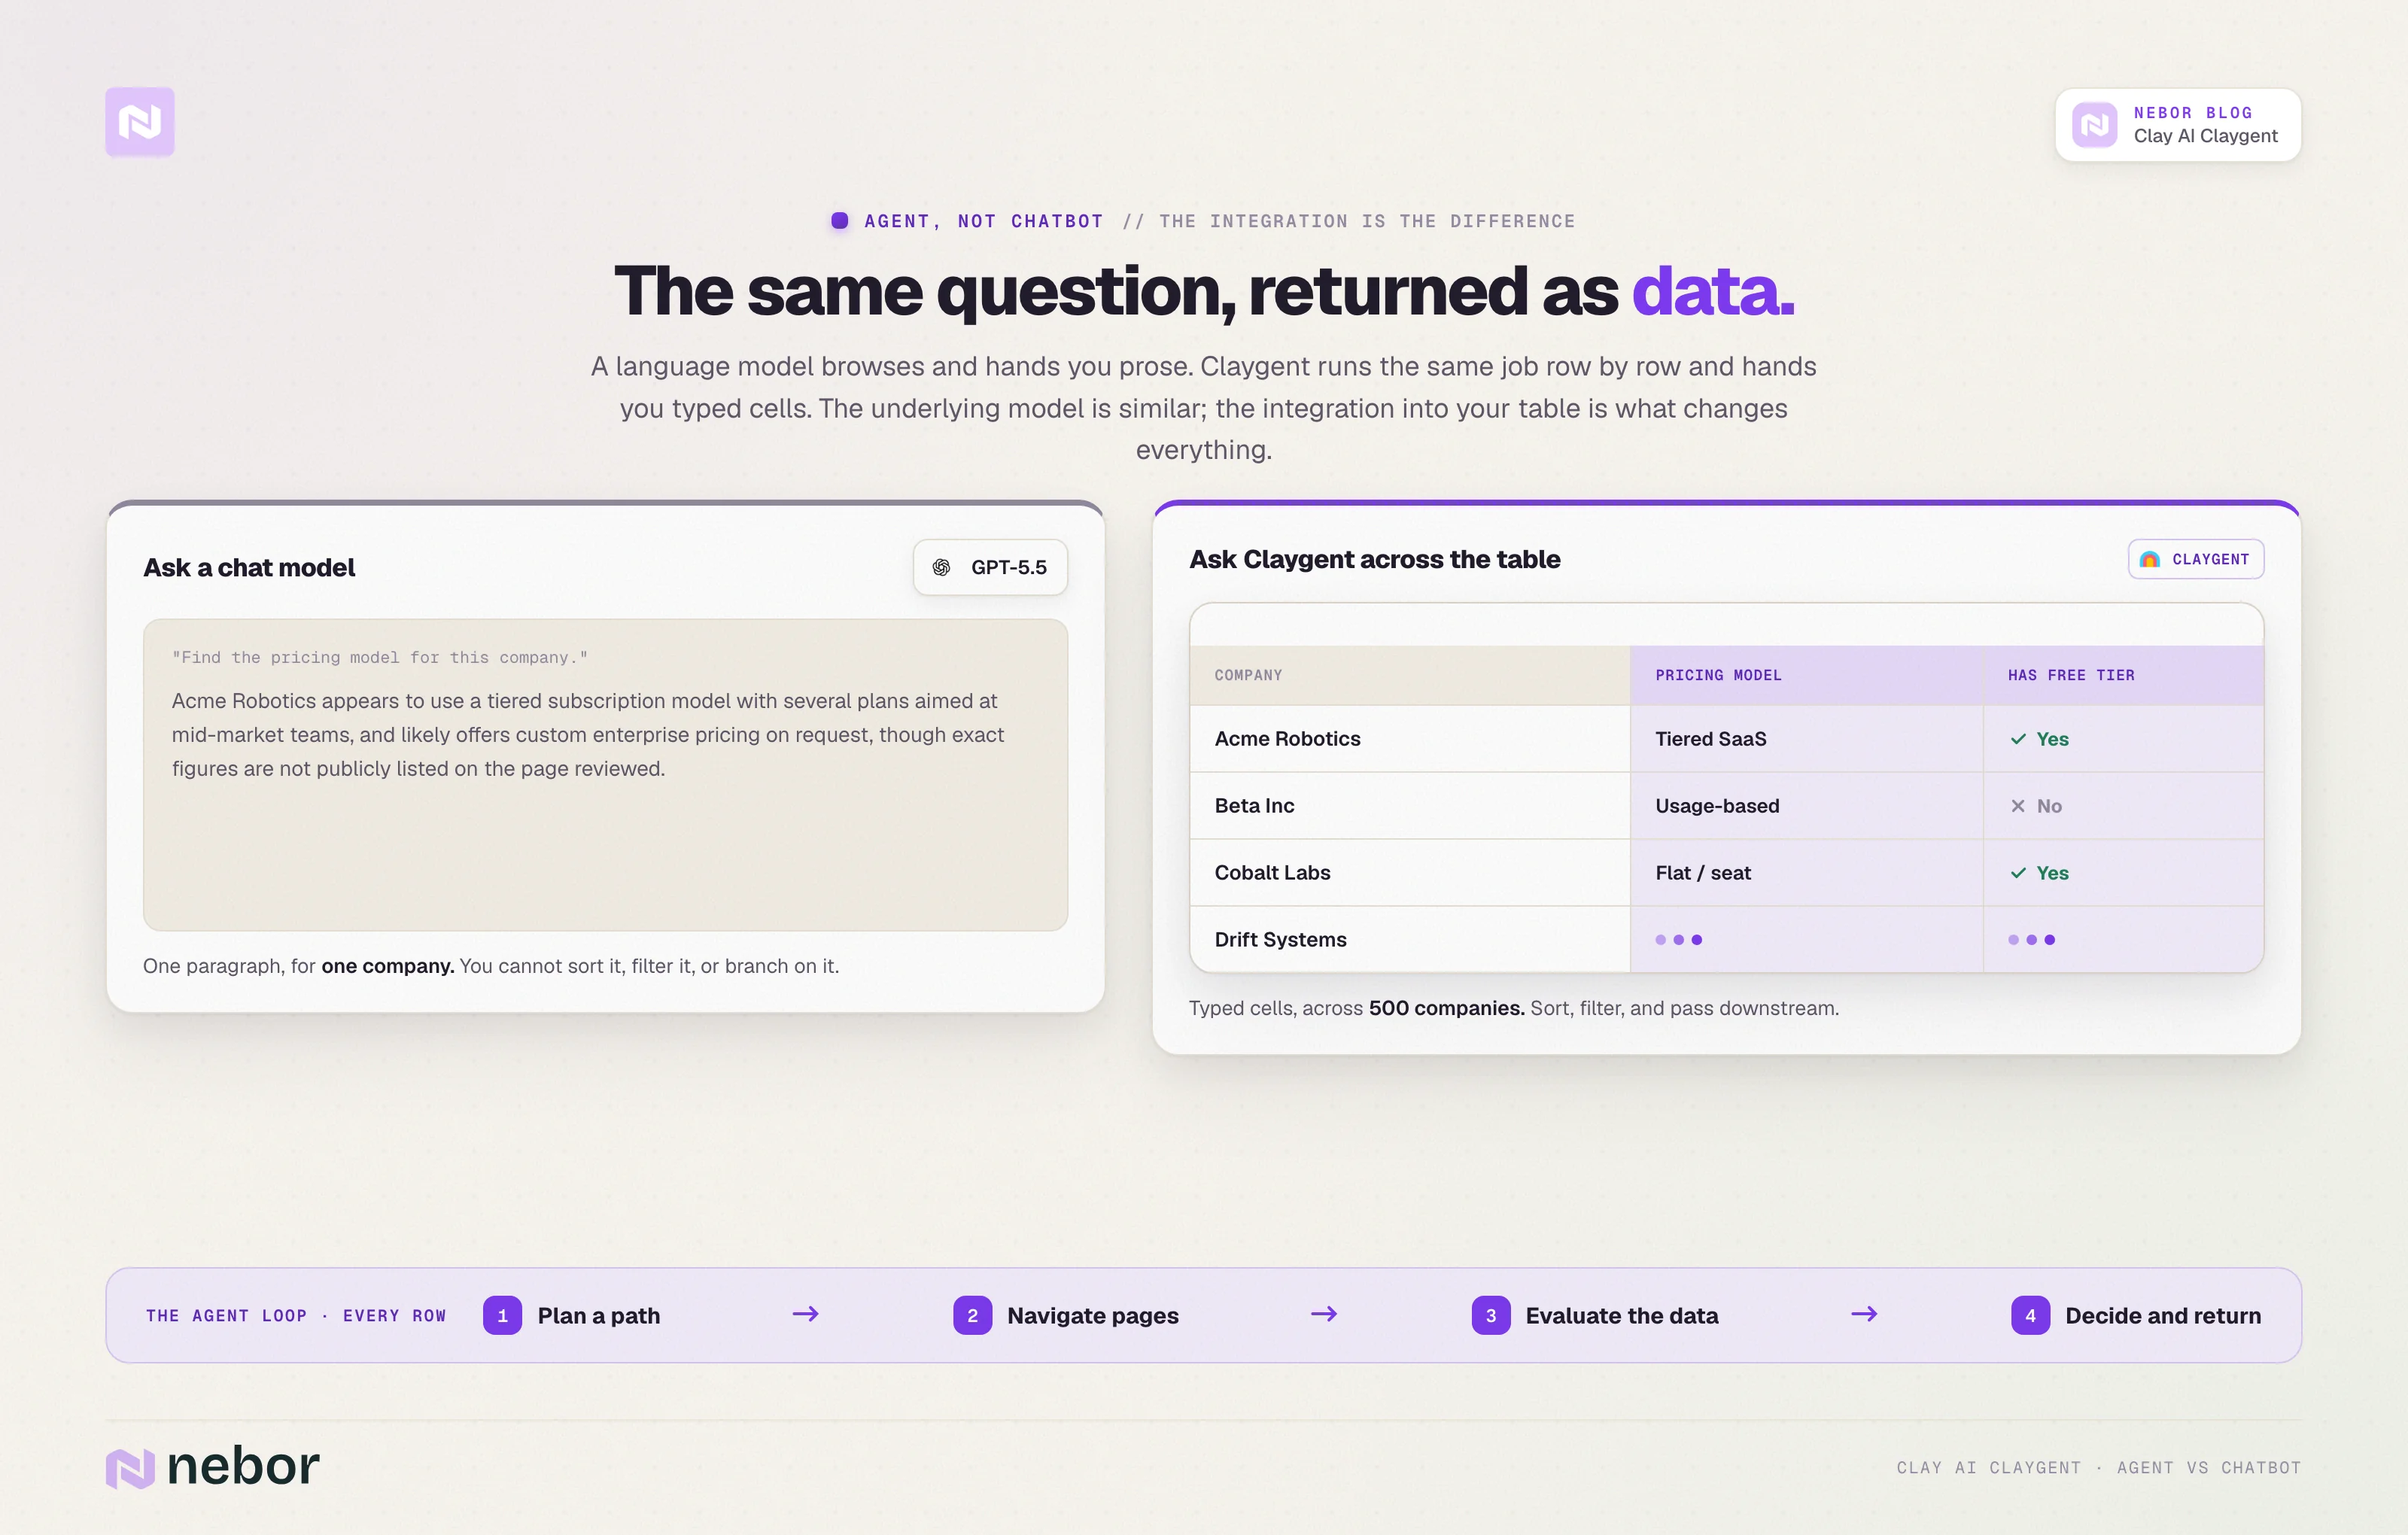
De onderliggende capaciteit is bij alle drie vergelijkbaar. Het verschil zit in de integratie. Claygent werkt rij voor rij, geeft getypeerde cellen terug en voedt automatisch de volgende stap.
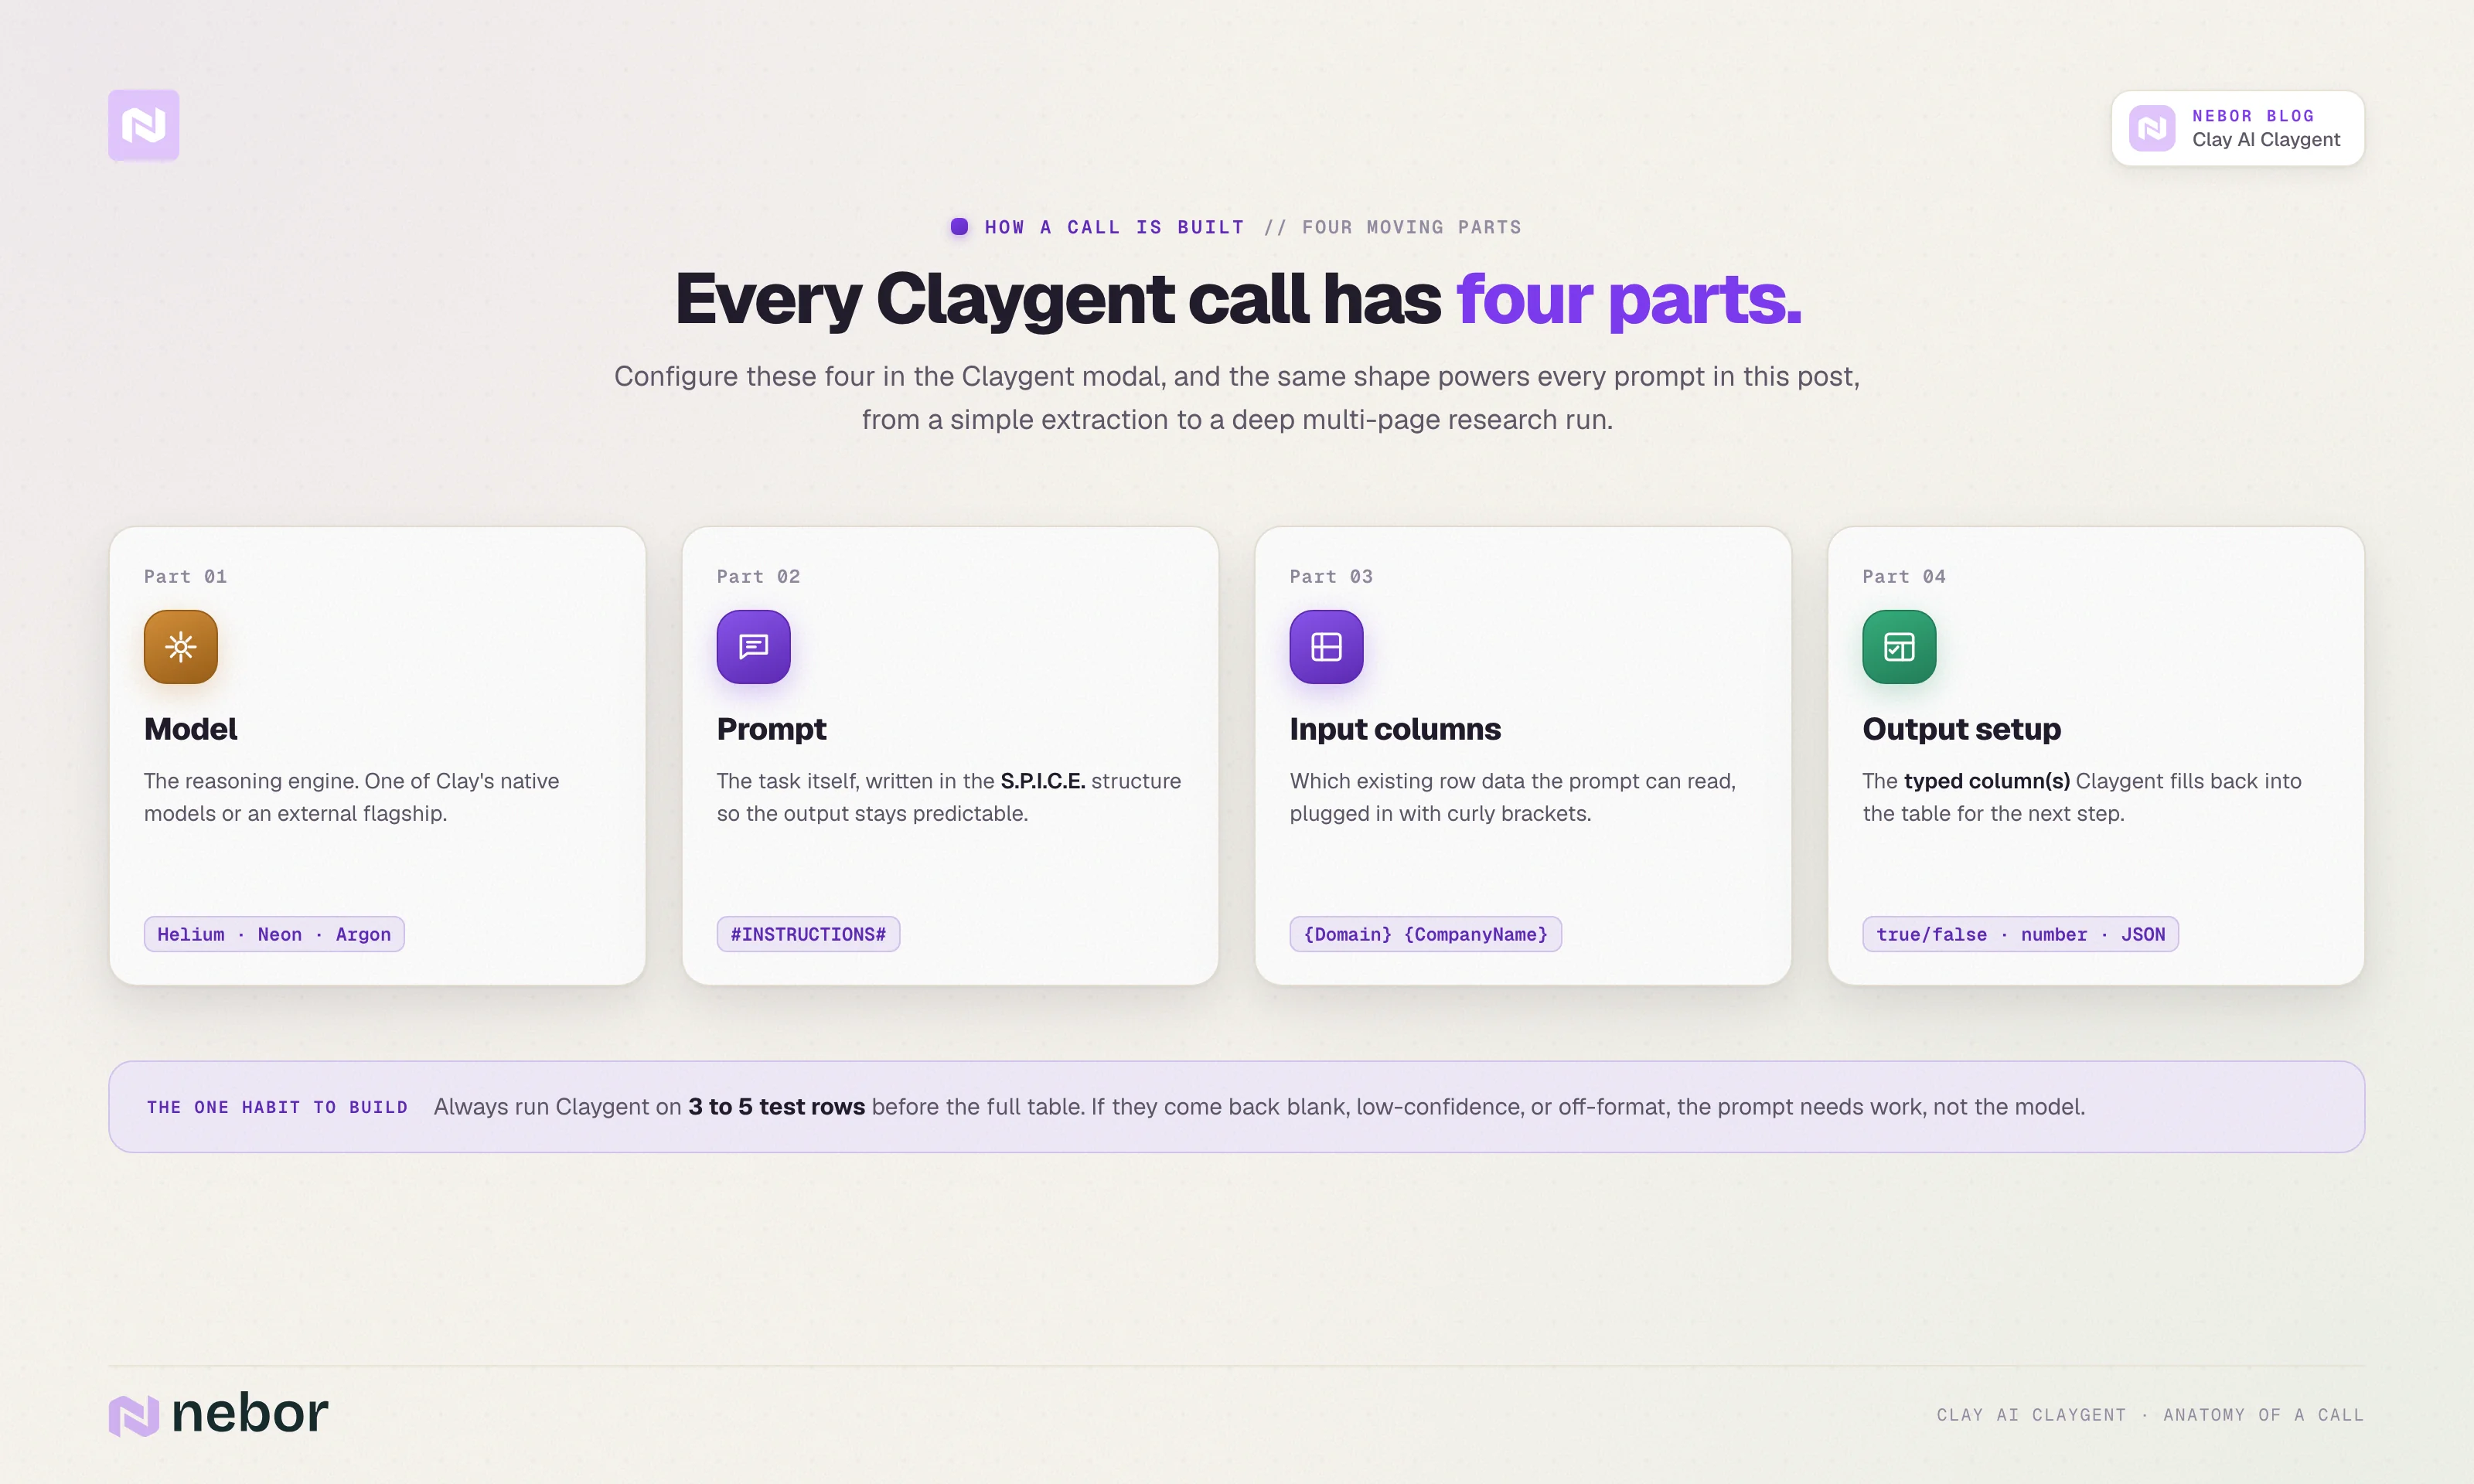
In de praktijk heeft elke Claygent-call vier bewegende onderdelen.
Het eerste is het model dat het denkwerk doet. Dat kan een van de drie eigen opties van Clay zijn (Helium, Neon of Argon) of een extern model van OpenAI, Anthropic of Google. Op het moment van schrijven zijn GPT-5.5 en Claude Opus 4.7 de externe topkeuzes.
Het tweede is de prompt die de klus omschrijft. Het derde is de set inputkolommen waar de prompt naar kan verwijzen, meestal de data die al in de rij staat.
Het vierde is de getypeerde output die terugstroomt naar een of meer Clay-kolommen, klaar voor de volgende stap in de tabel.
In de volgende secties komen we op alle vier terug. Voor nu is het uitgangspunt simpel.
Claygent is een agent-runner met een vaste integratie in de plek waar je GTM-data al staat, en die integratie maakt de rest van dit artikel mogelijk.
Zo vind en configureer je Claygent in Clay
Claygent zit in het enrichment-paneel van Clay, tussen alle andere connectors. In een nieuwe tabel vind je hem het snelst door op “Add enrichment” te klikken, “Web Research” in de zoekbalk te typen en de Claygent-optie in de AI-sectie te kiezen.
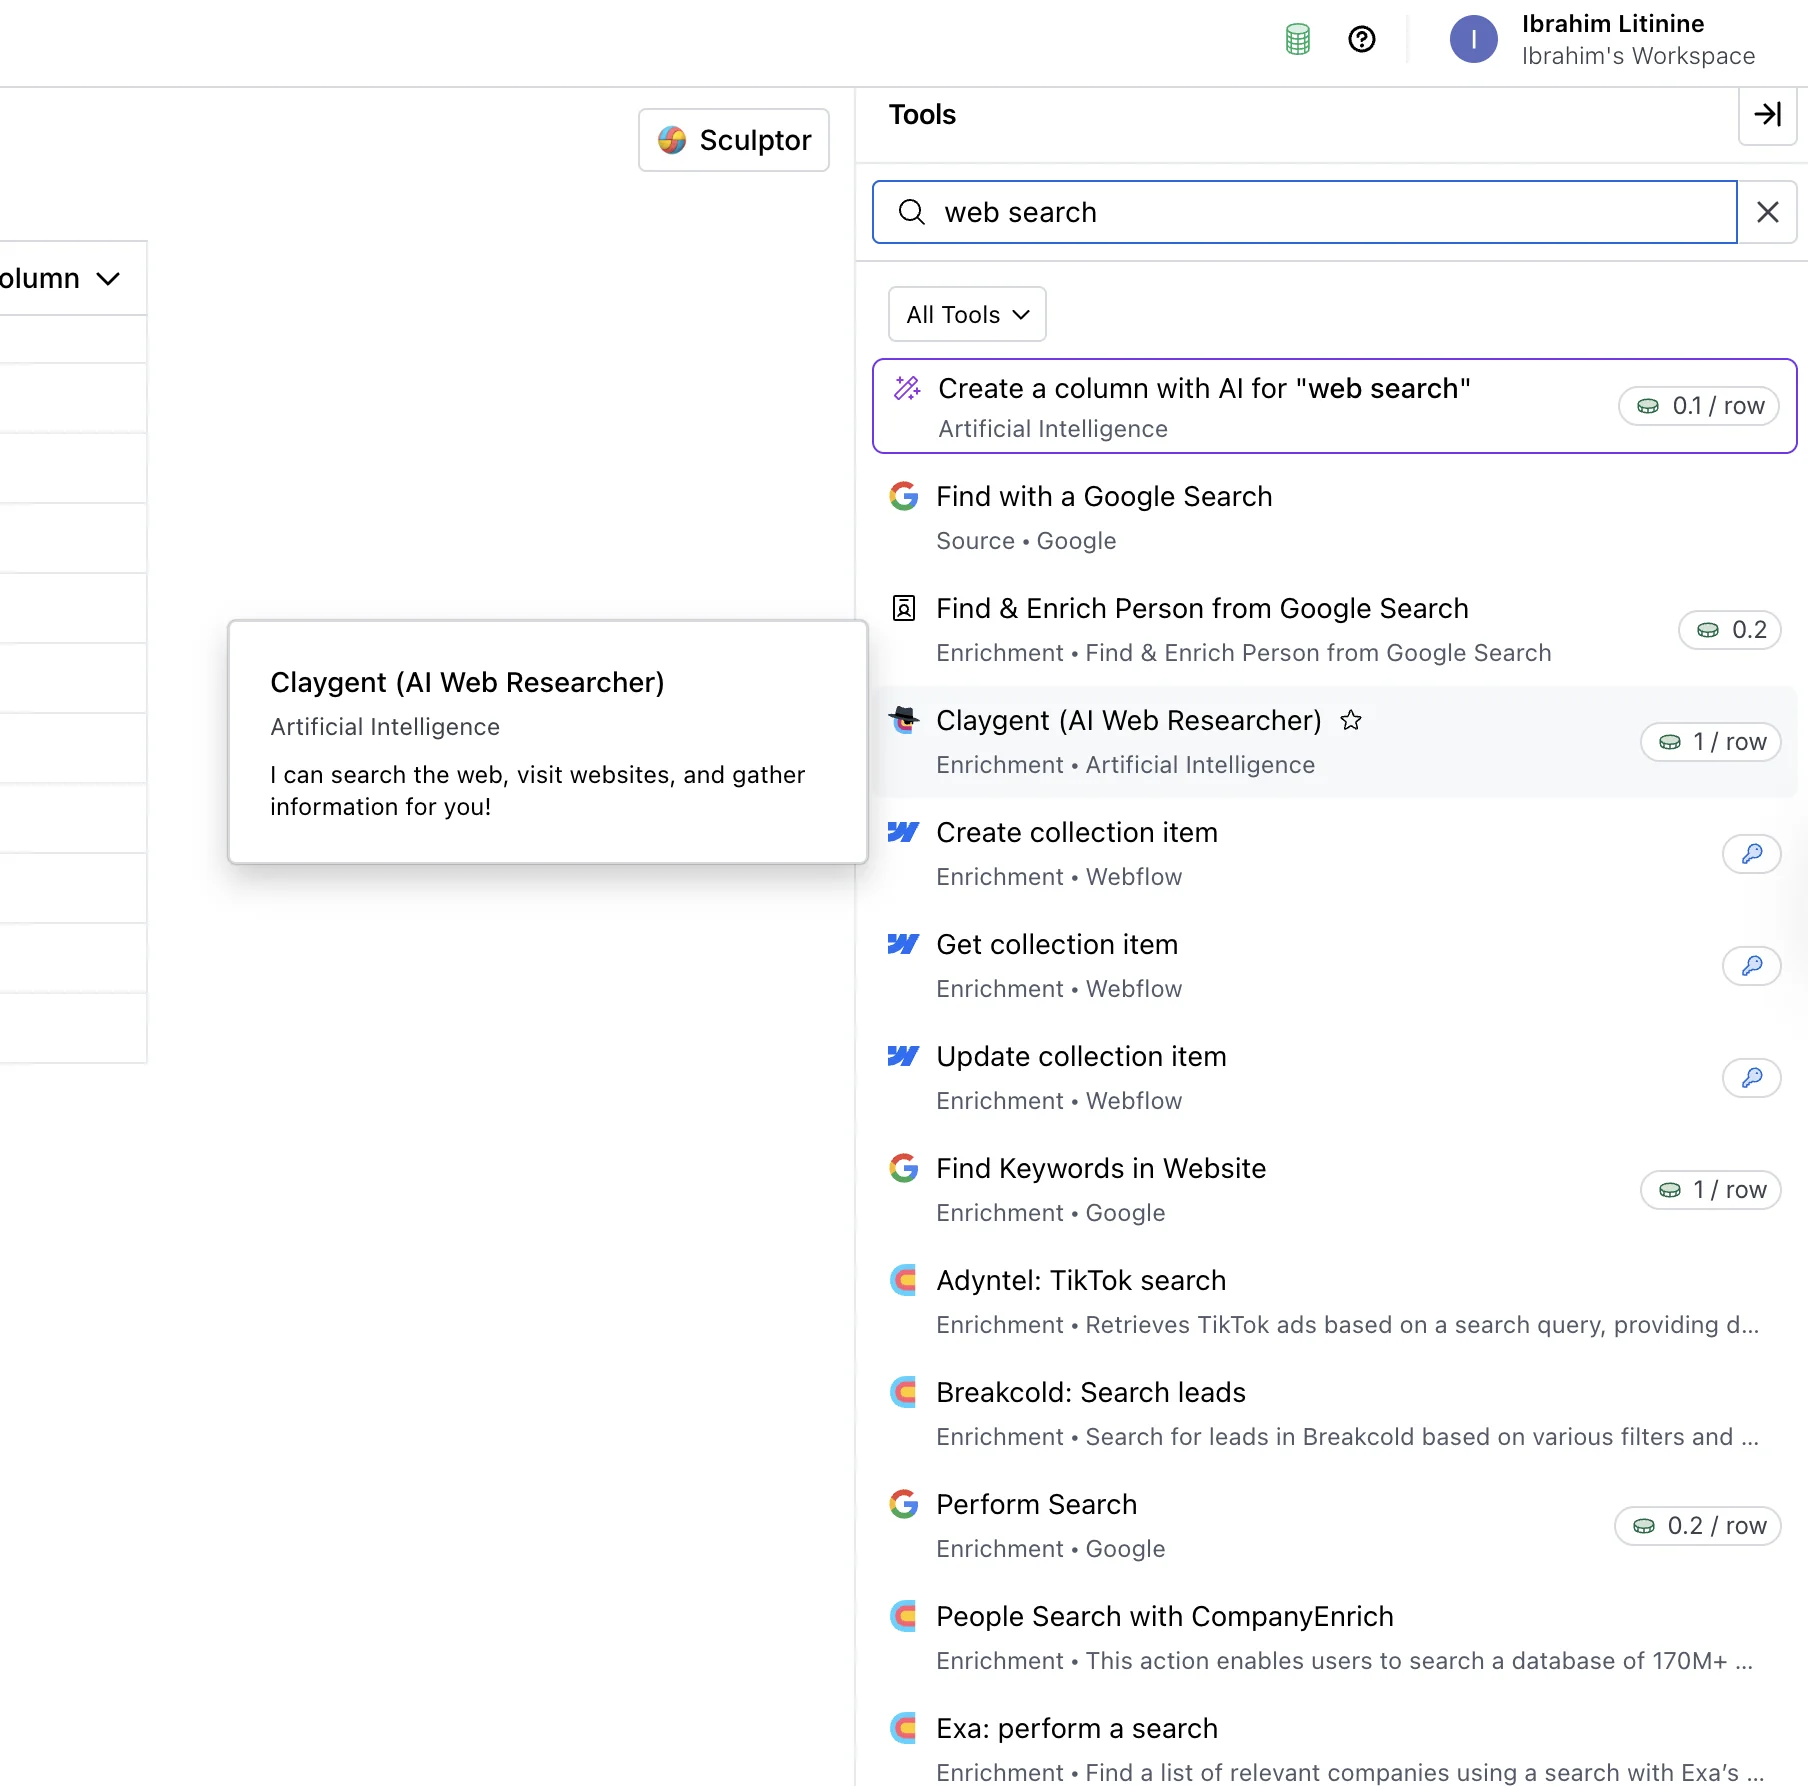
En zo ziet het eruit nadat je hem hebt gekozen.
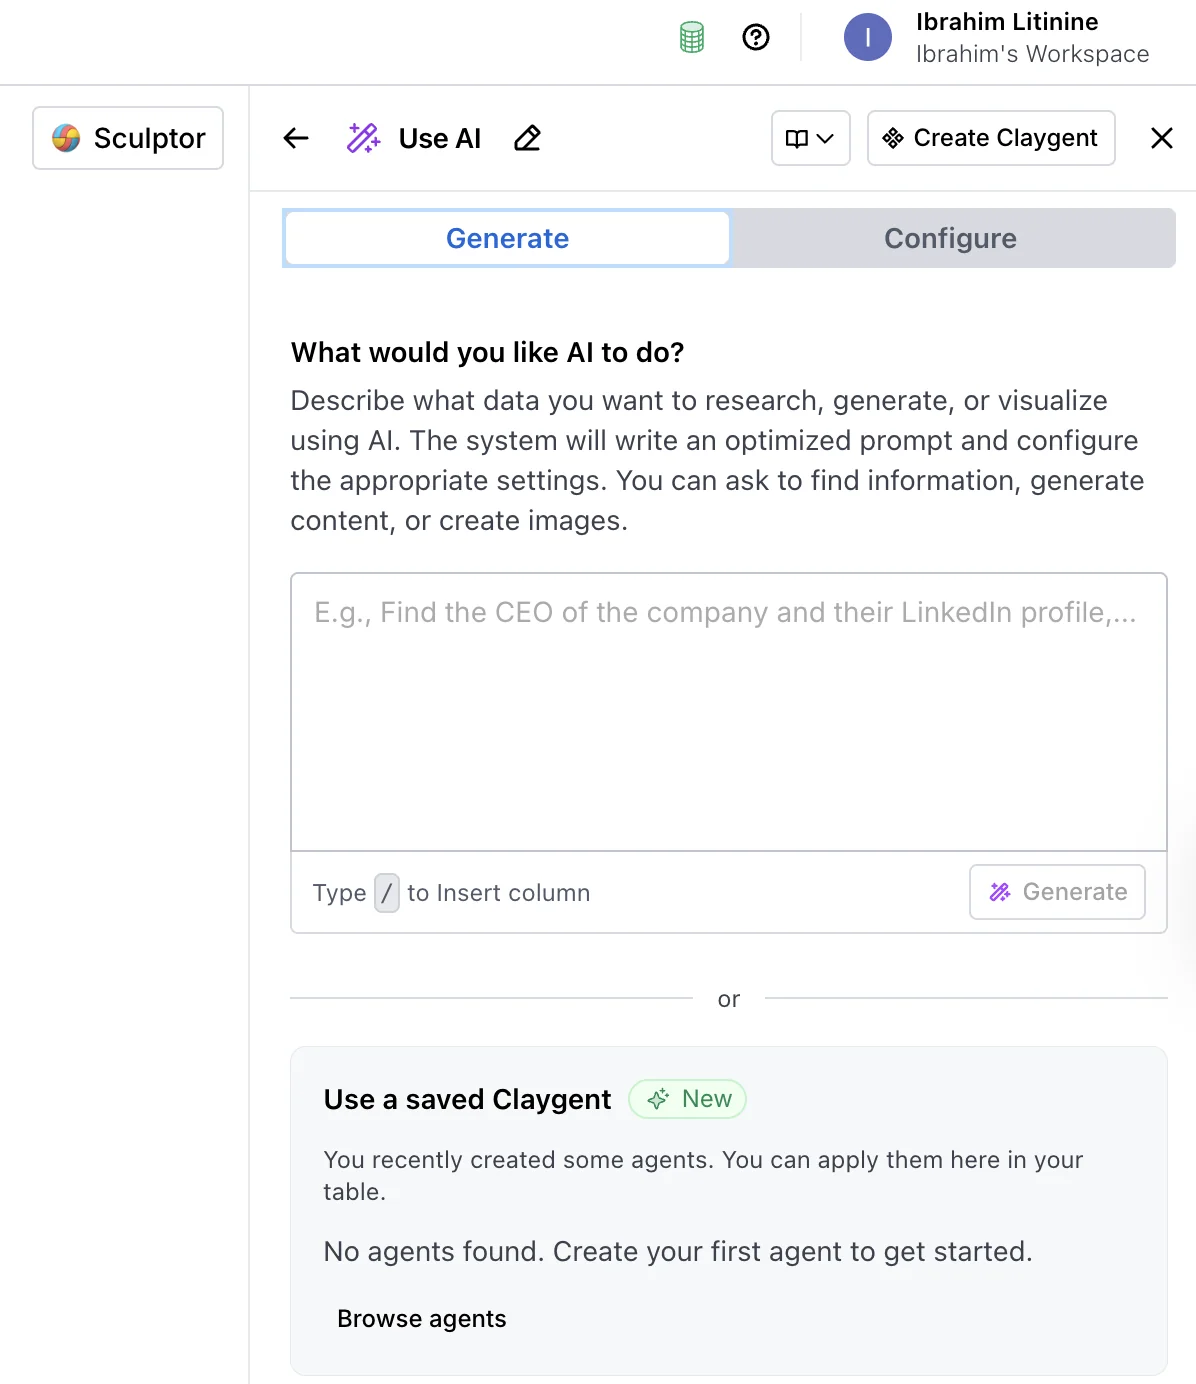
Voordat dit iets oplevert, heb je een tabel met rijen nodig om Claygent op los te laten. Heb je die nog niet, maak dan een workbook aan, klik daarin op “+ Add” en kies Company Table, People Table of Custom Table, afhankelijk van wat je onderzoekt.
Vul de tabel met minstens een handvol rijen die je wilt verrijken.
Zodra je Claygent kiest, opent er een venster met vier configuratieonderdelen. Bovenaan staat de modelkiezer, in het midden het promptveld, daaronder de selectie van inputkolommen en onderaan de instellingen voor de outputkolommen.
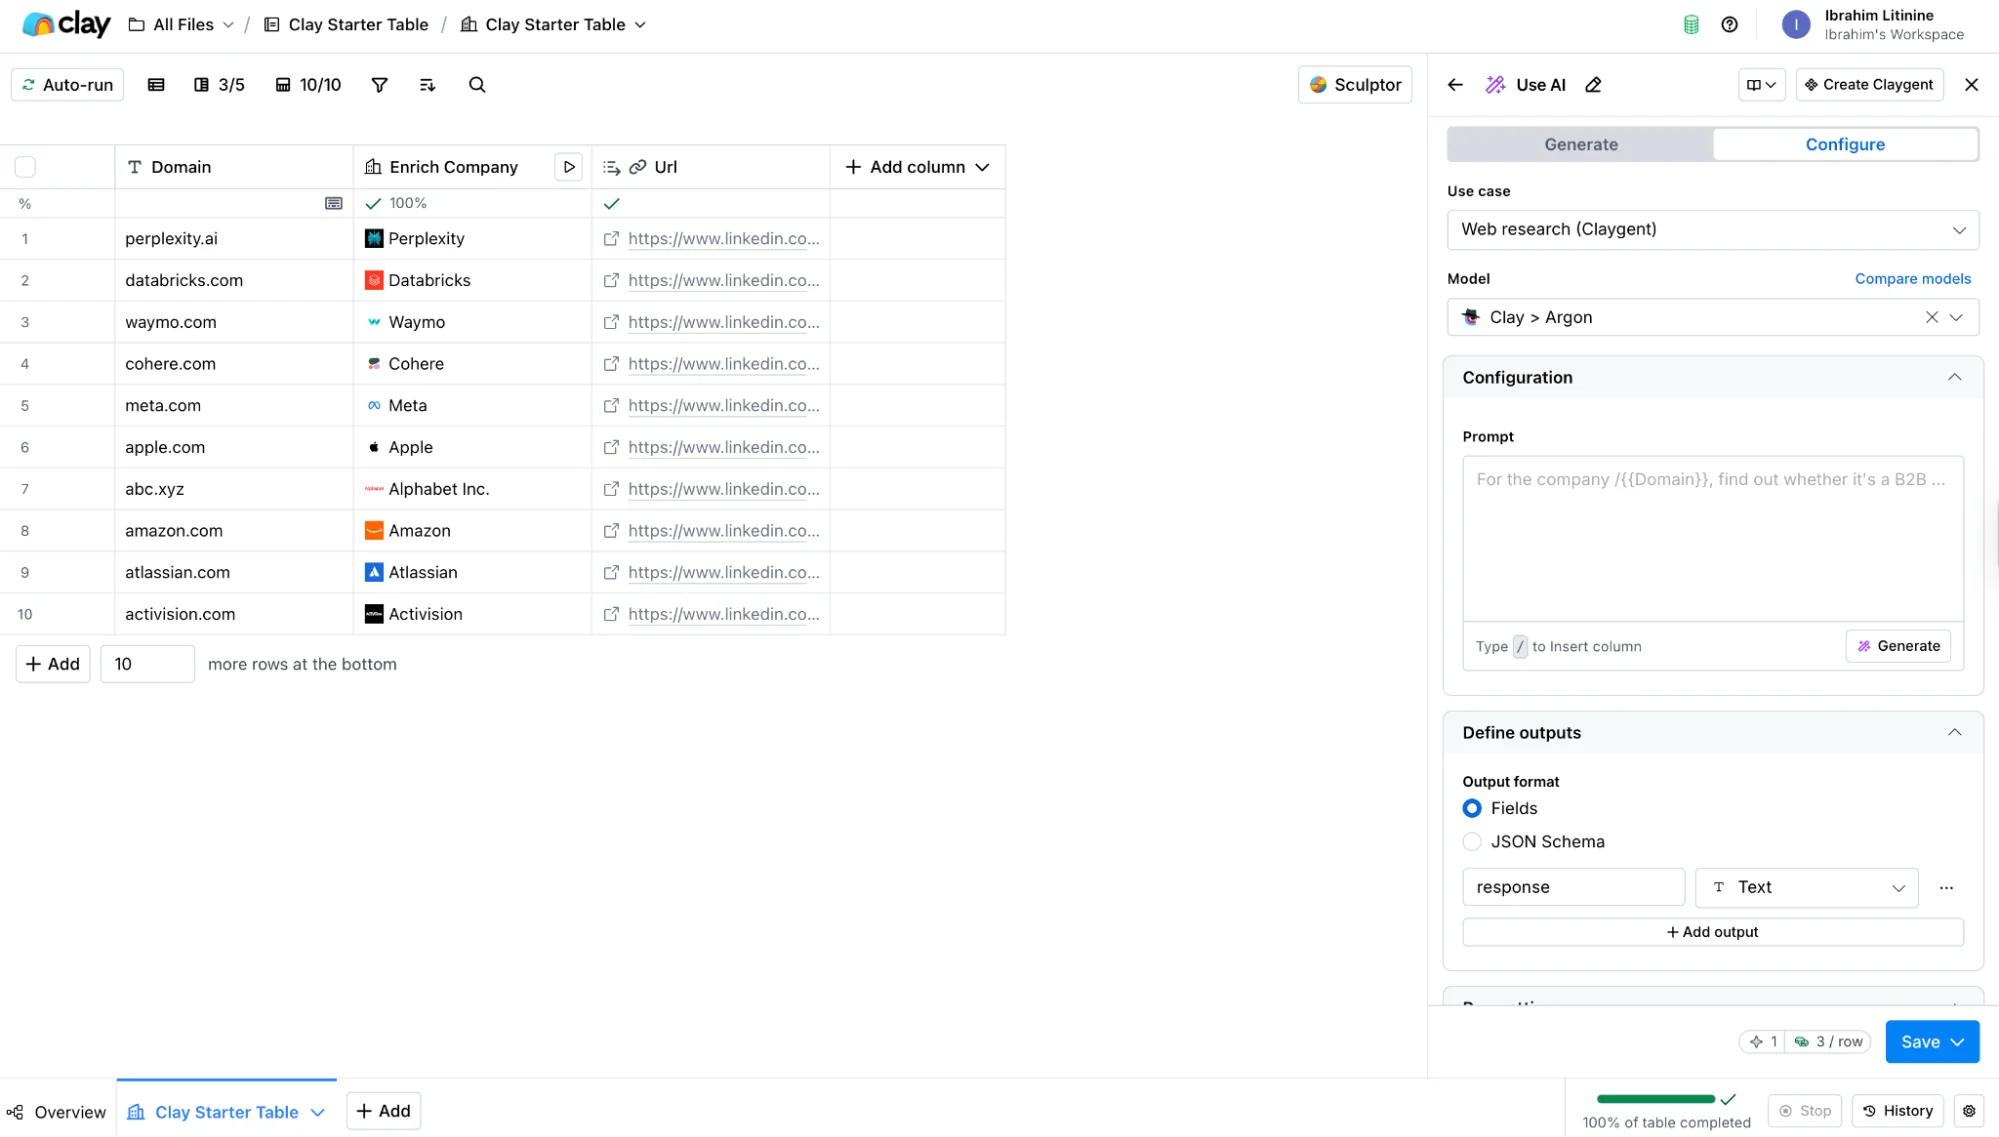
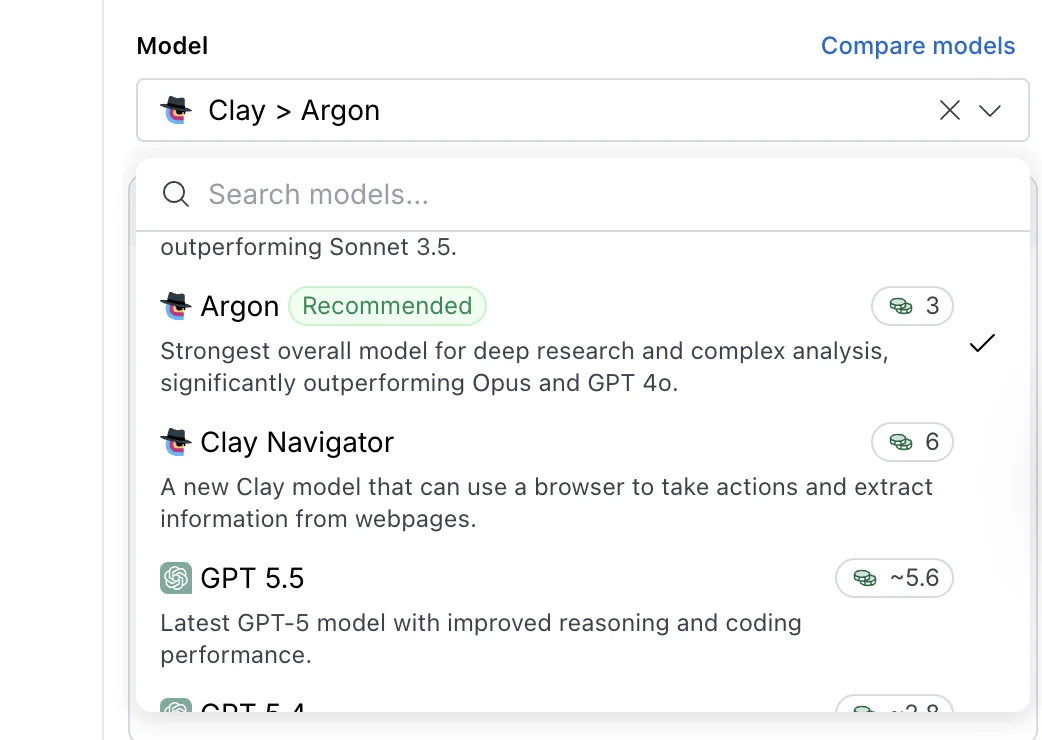
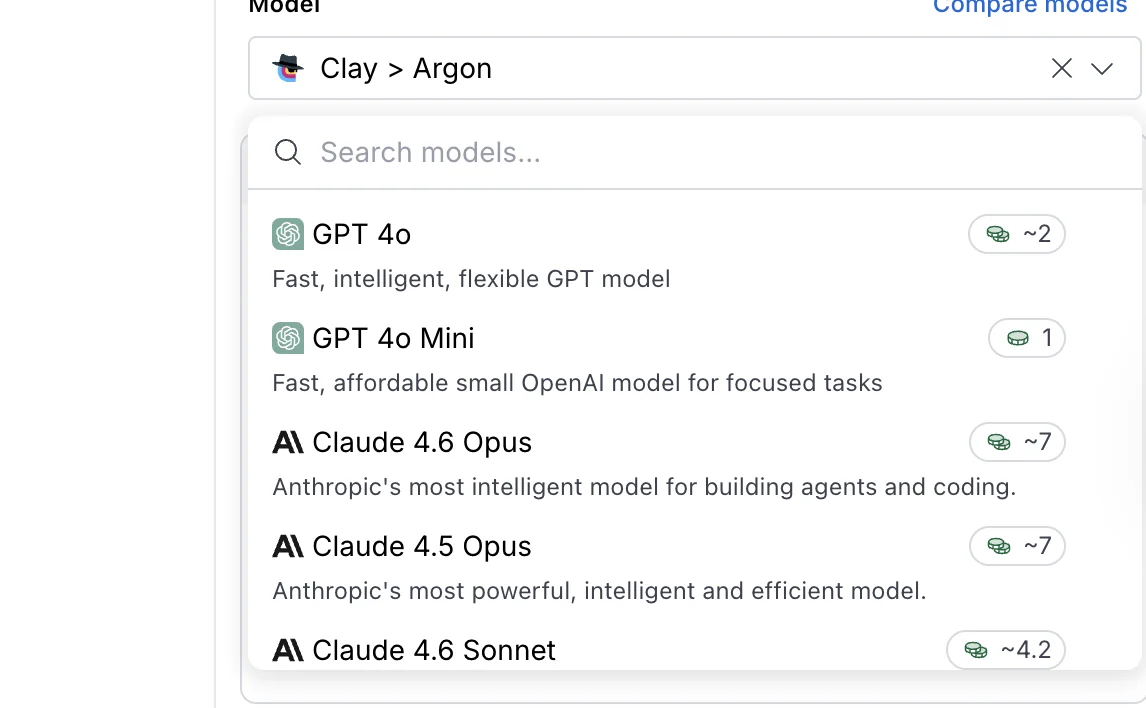
In de modelkiezer kies je Helium, Neon, Argon of een van de externe opties (OpenAI, Anthropic of Gemini). In het promptveld schrijf je de briefing.
De inputselectie vertelt Claygent naar welke bestaande kolommen in de rij hij in de prompt mag verwijzen (meestal Domain, Company Name of LinkedIn URL). De outputinstellingen bepalen welke kolom of kolommen Claygent in de tabel invult.
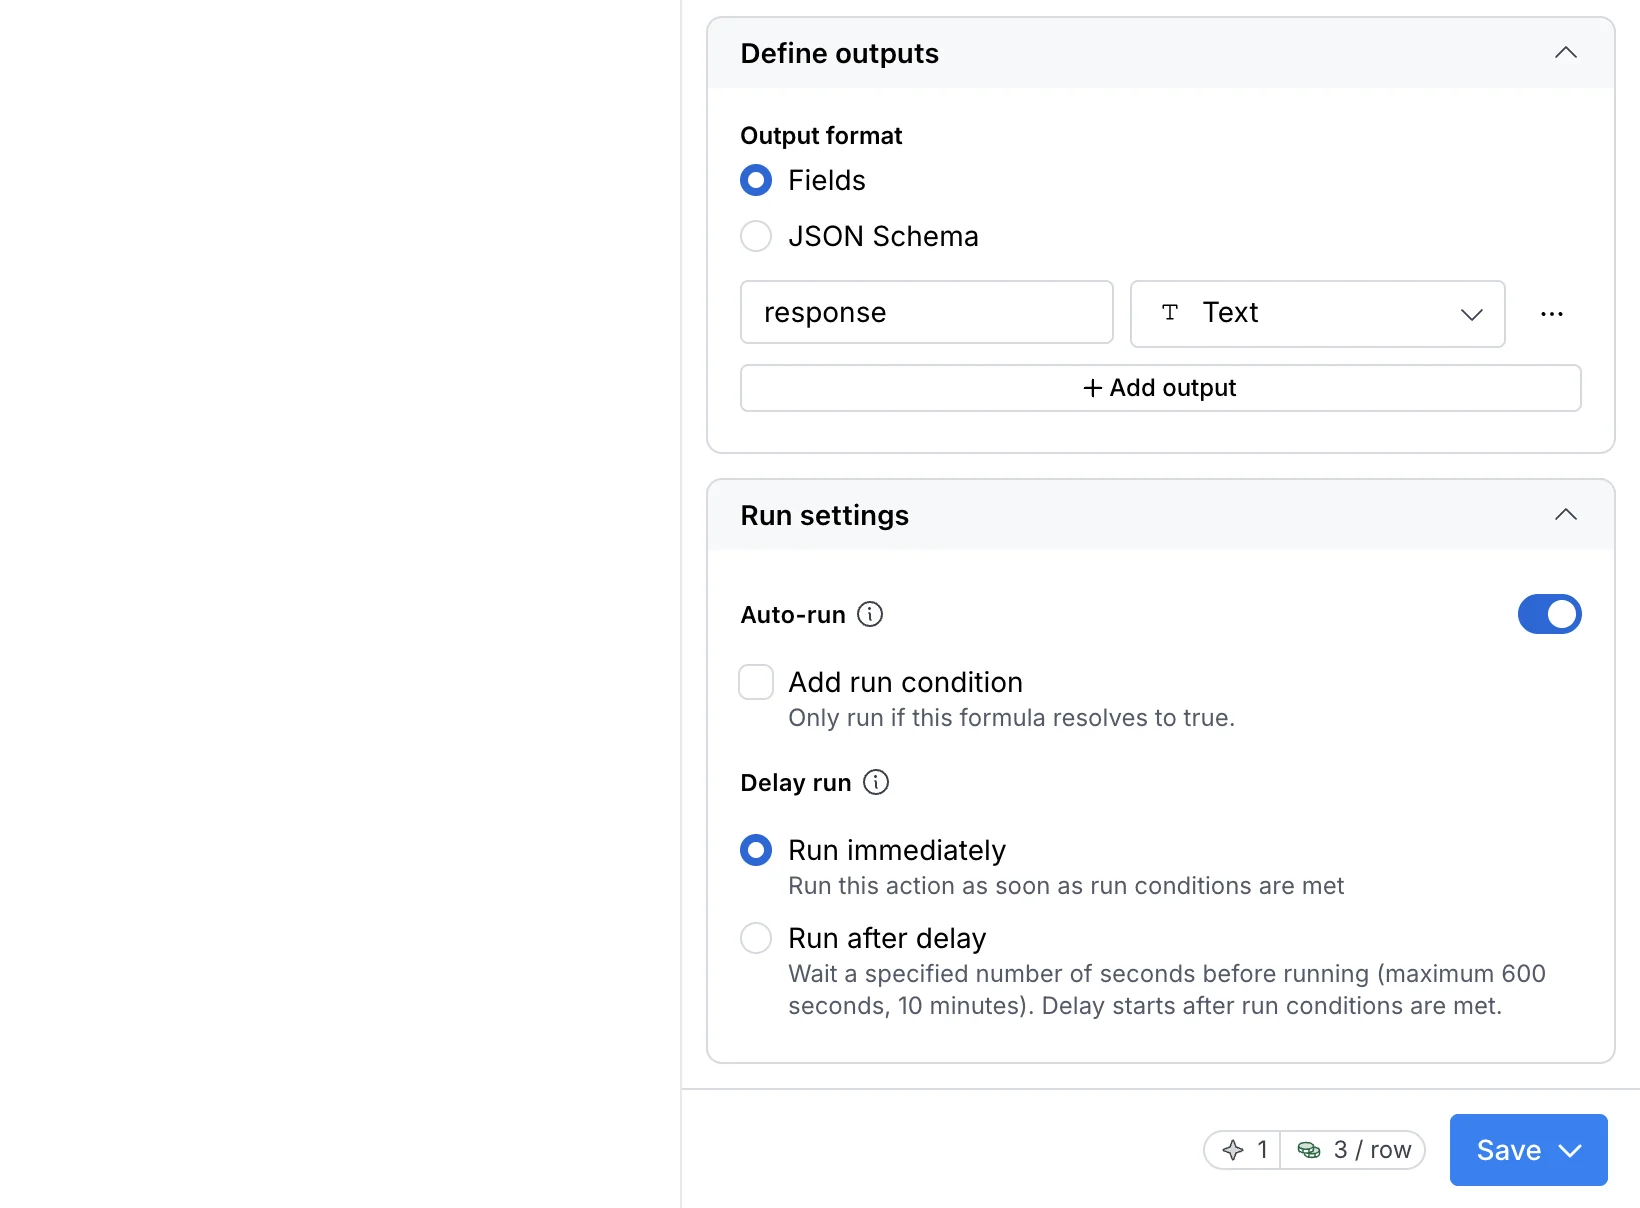
Er is één werkgewoonte die je vanaf dag één moet aanleren, en die is simpel. Test Claygent altijd op drie tot vijf testrijen voordat je hem op de hele tabel loslaat.
Die eerste ronde laat zien of de prompt echt de structuur teruggeeft die je verwachtte, en of het gekozen model zwaar genoeg is voor je vraag.
Komen de testrijen leeg terug, met lage zekerheid of in een ander formaat dan je verwachtte, dan moet de prompt beter. Over twee secties gaan we uitgebreid in op de opbouw van prompts.
Zo kies je het juiste Clay AI Claygent-model voor de klus
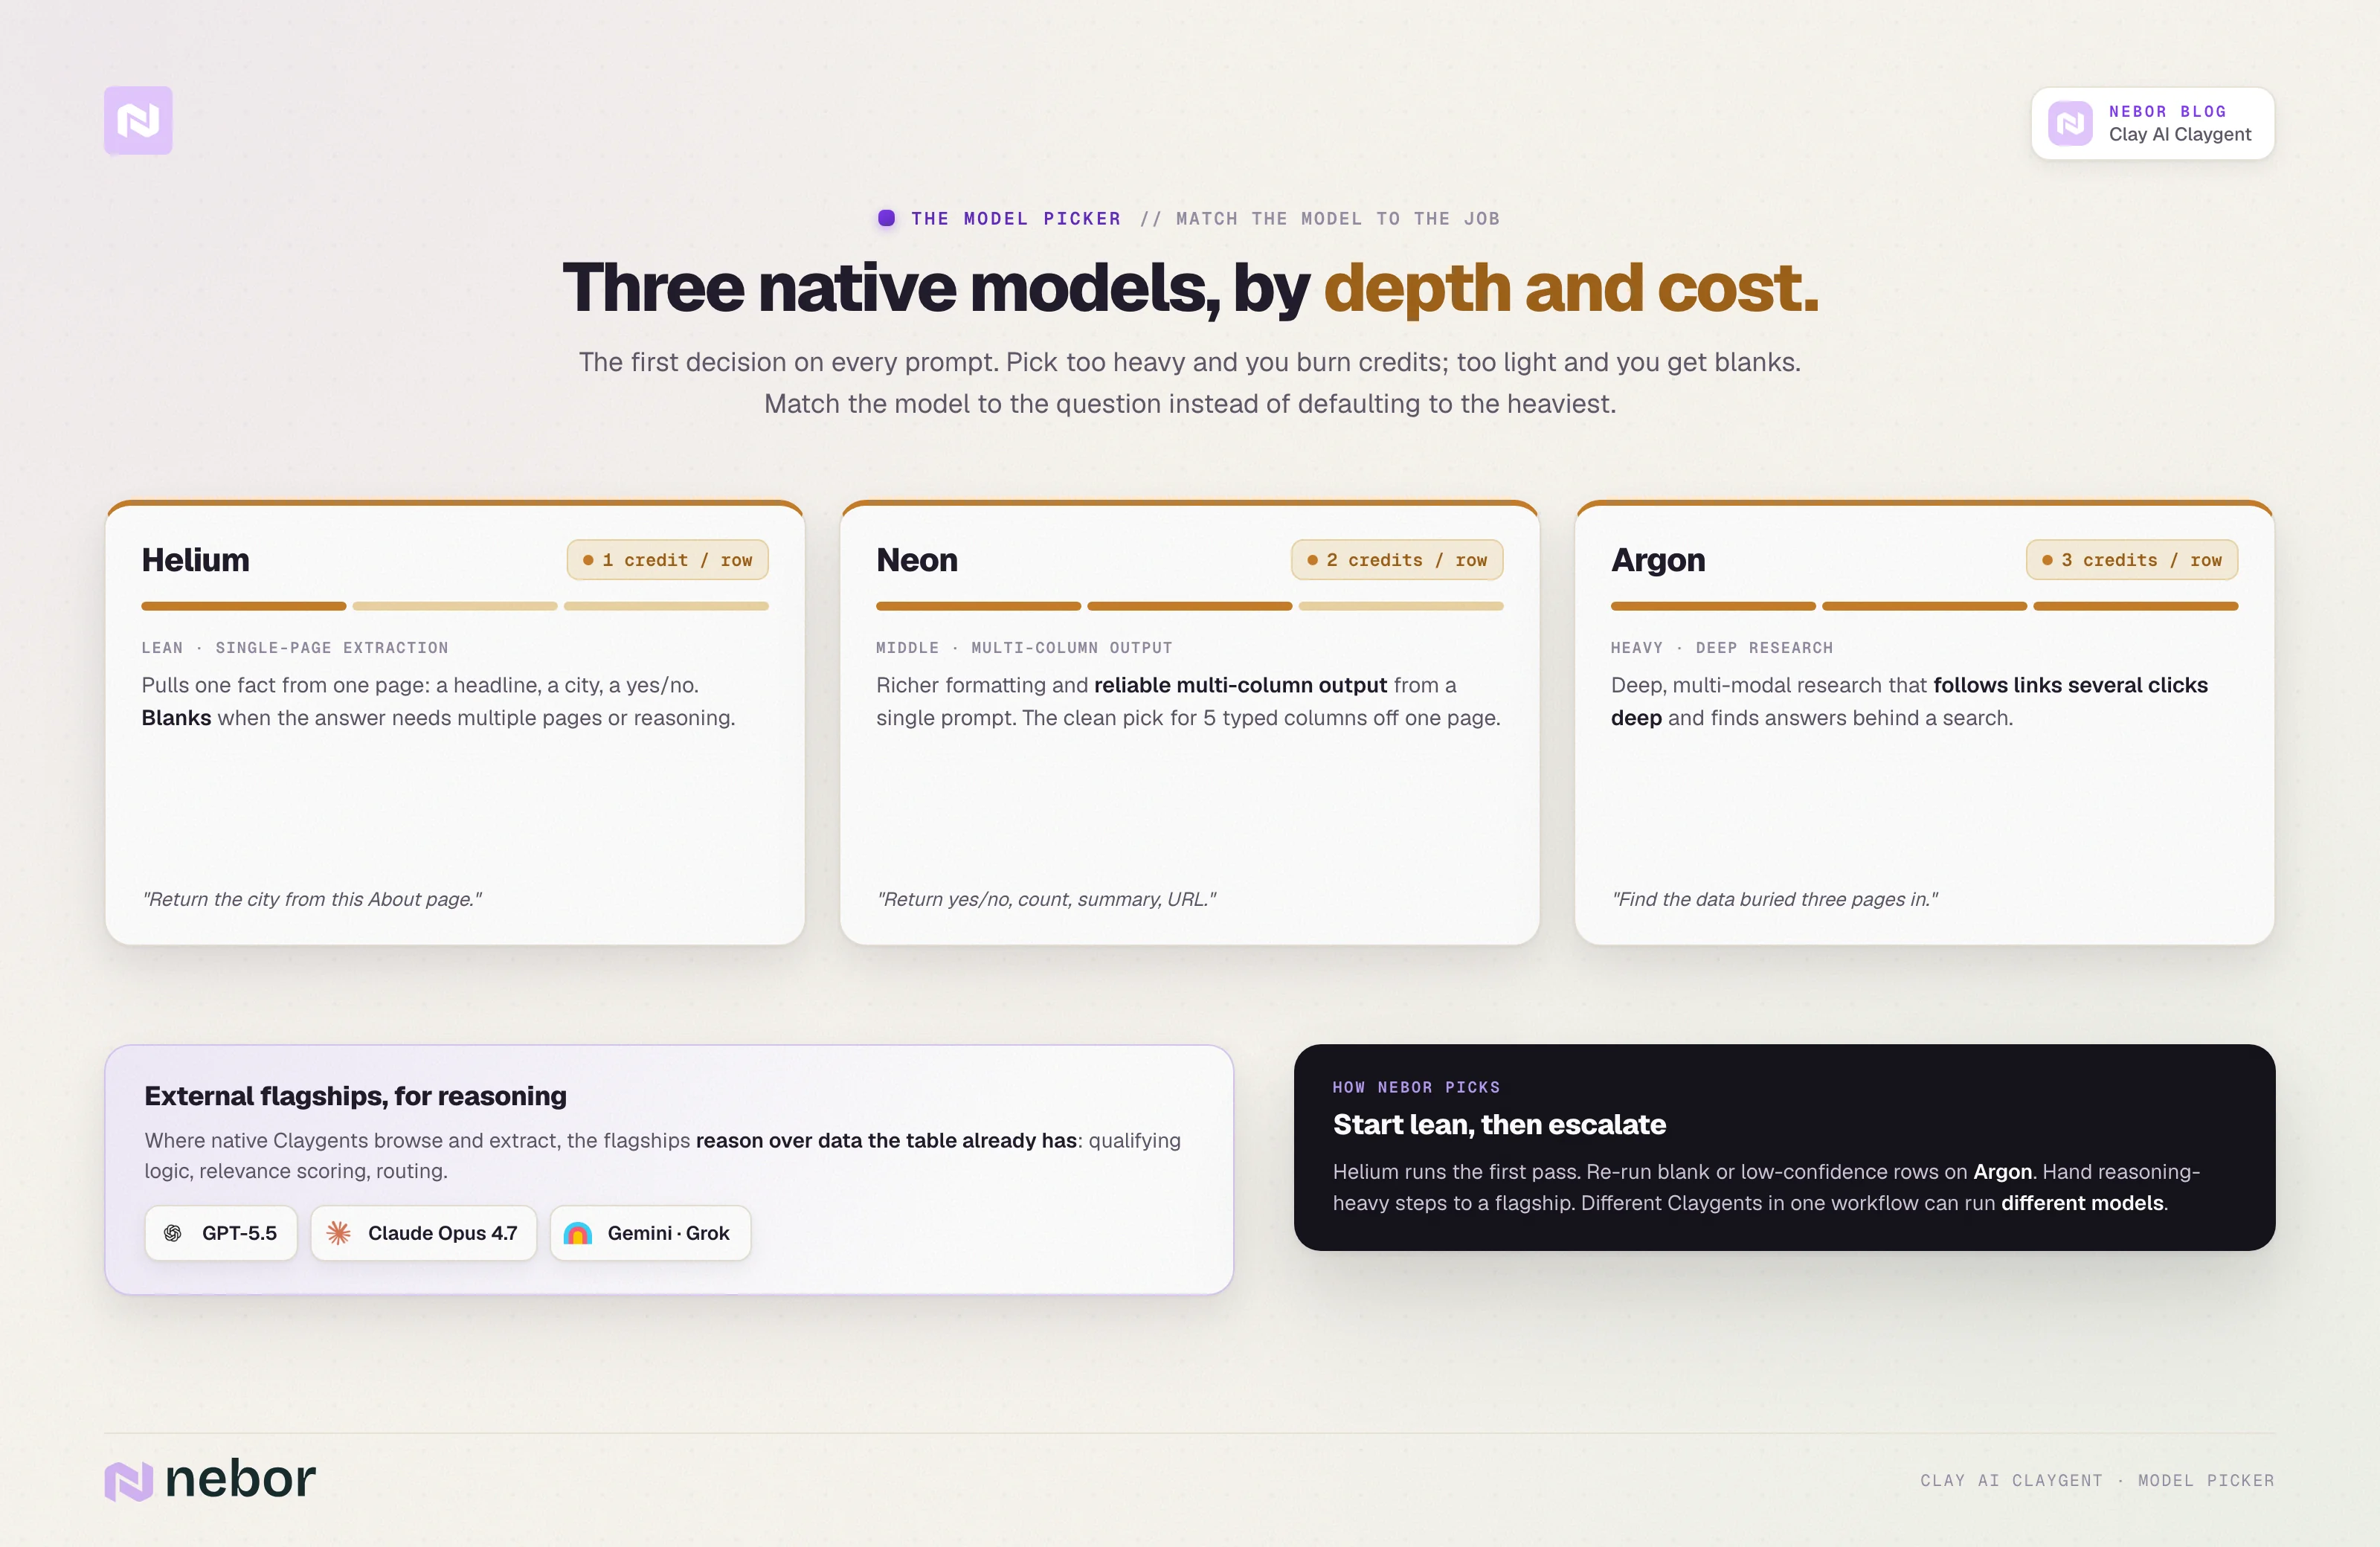
In het Claygent-venster is de modelkiezer de eerste keuze die je bij elke prompt maakt. Kies je hier verkeerd, dan betaal je credits die niet nodig waren, of krijg je een antwoord dat het goedkopere model ook had kunnen geven.
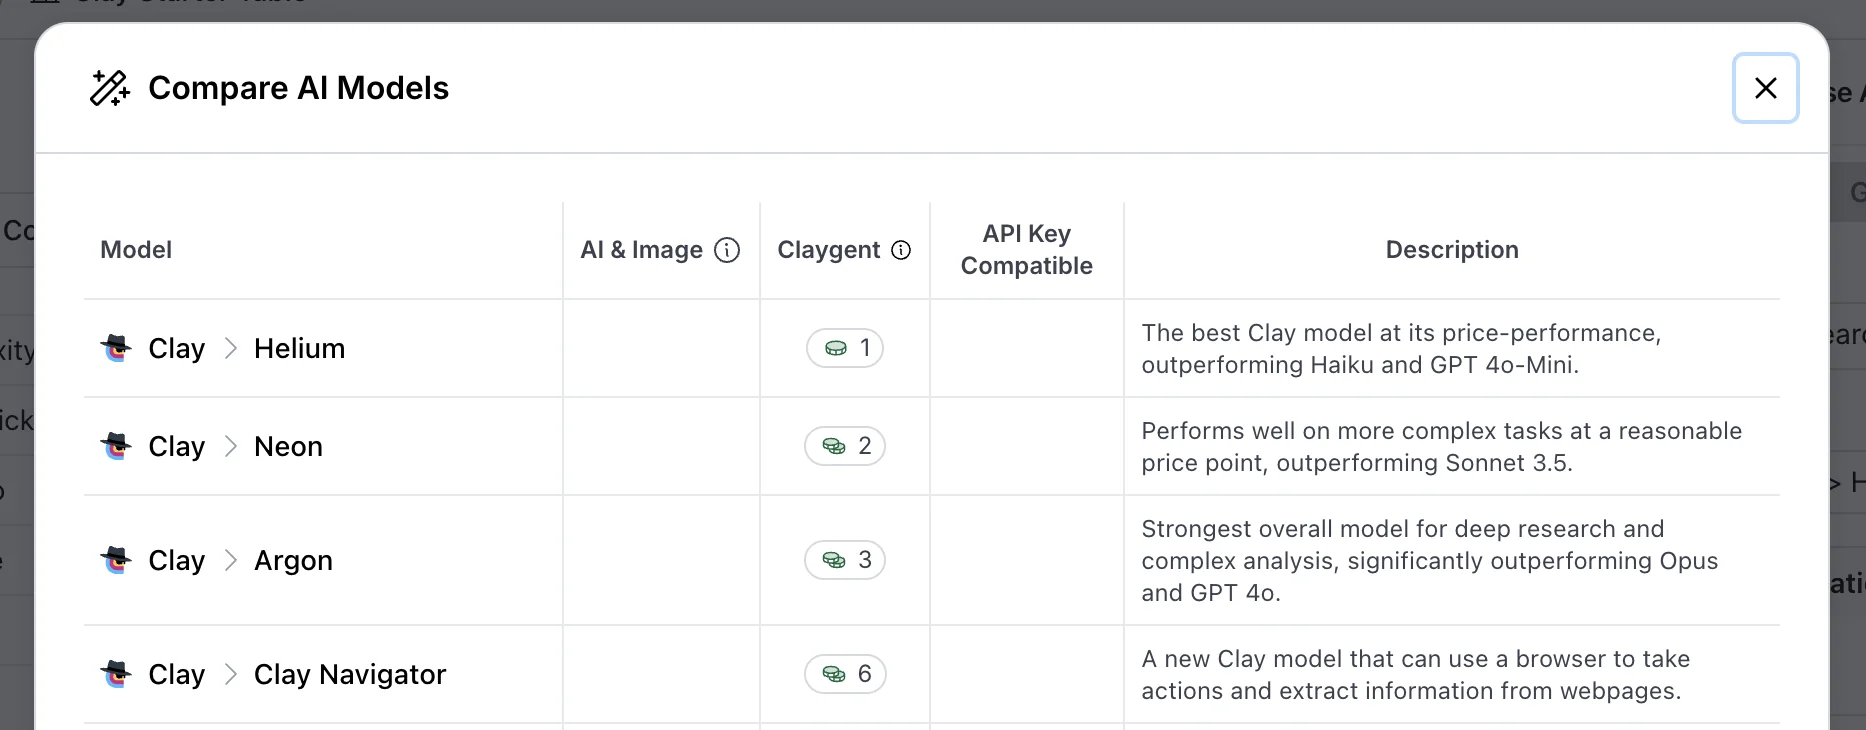
Clay levert drie eigen Claygent-modellen. Als de klus erom vraagt, zetten we de externe opties daar bovenop.
Claygent Helium
Helium is de goedkope standaard, voor één credit per rij. Hij is snel, doet opzoekwerk op één pagina goed en is de juiste keuze voor elke prompt waarbij de data op één pagina staat en er geen diep denkwerk nodig is.
Denk aan "zoek de LinkedIn-URL van dit bedrijf", "haal de kop van deze homepage" of "geef de stad van deze About-pagina".
Helium geeft lege cellen terug als het model voor het antwoord meerdere gelinkte pagina's moet lezen, in meerdere stappen moet redeneren of dubbelzinnige content moet interpreteren. Dan schaal je op naar een zwaarder model.
Claygent Neon
Neon zit in de middelste laag, voor twee credits per rij. Twee dingen kan Neon die Helium niet kan: rijker opgemaakte antwoorden en betrouwbaardere output in meerdere kolommen vanuit één prompt.
Vraagt je prompt om vijf getypeerde kolommen van één pagina (ja/nee, getal, tekst, URL, samenvatting), dan is Neon het beste model voor de klus. Bij een prompt met meerdere vragen tegelijk levert hij een consistentere outputstructuur dan Helium.
Claygent Argon
Argon is het zware werk, voor drie credits per rij. Hij kan diep onderzoek aan, multimodale content en prompts waarbij de agent links een paar klikken diep in een site moet volgen voordat hij het antwoord vindt.
We pakken Argon als het antwoord achter een zoekstap zit, als de opbouw van de pagina onvoorspelbaar is of als een lichter model op de testrijen een dubbelzinnig resultaat gaf.
Externe modellen van OpenAI, Anthropic, Google en Grok
De externe modellen in het dropdownmenu van Clay staan naast de drie eigen modellen en zijn handig voor net ander werk.
De eigen Claygents zijn geoptimaliseerd voor browsen en extraheren. De externe topmodellen blinken uit in redeneren over data die de workflow al in de tabel heeft gezet. Dit zijn de OpenAI-modellen die je krijgt:
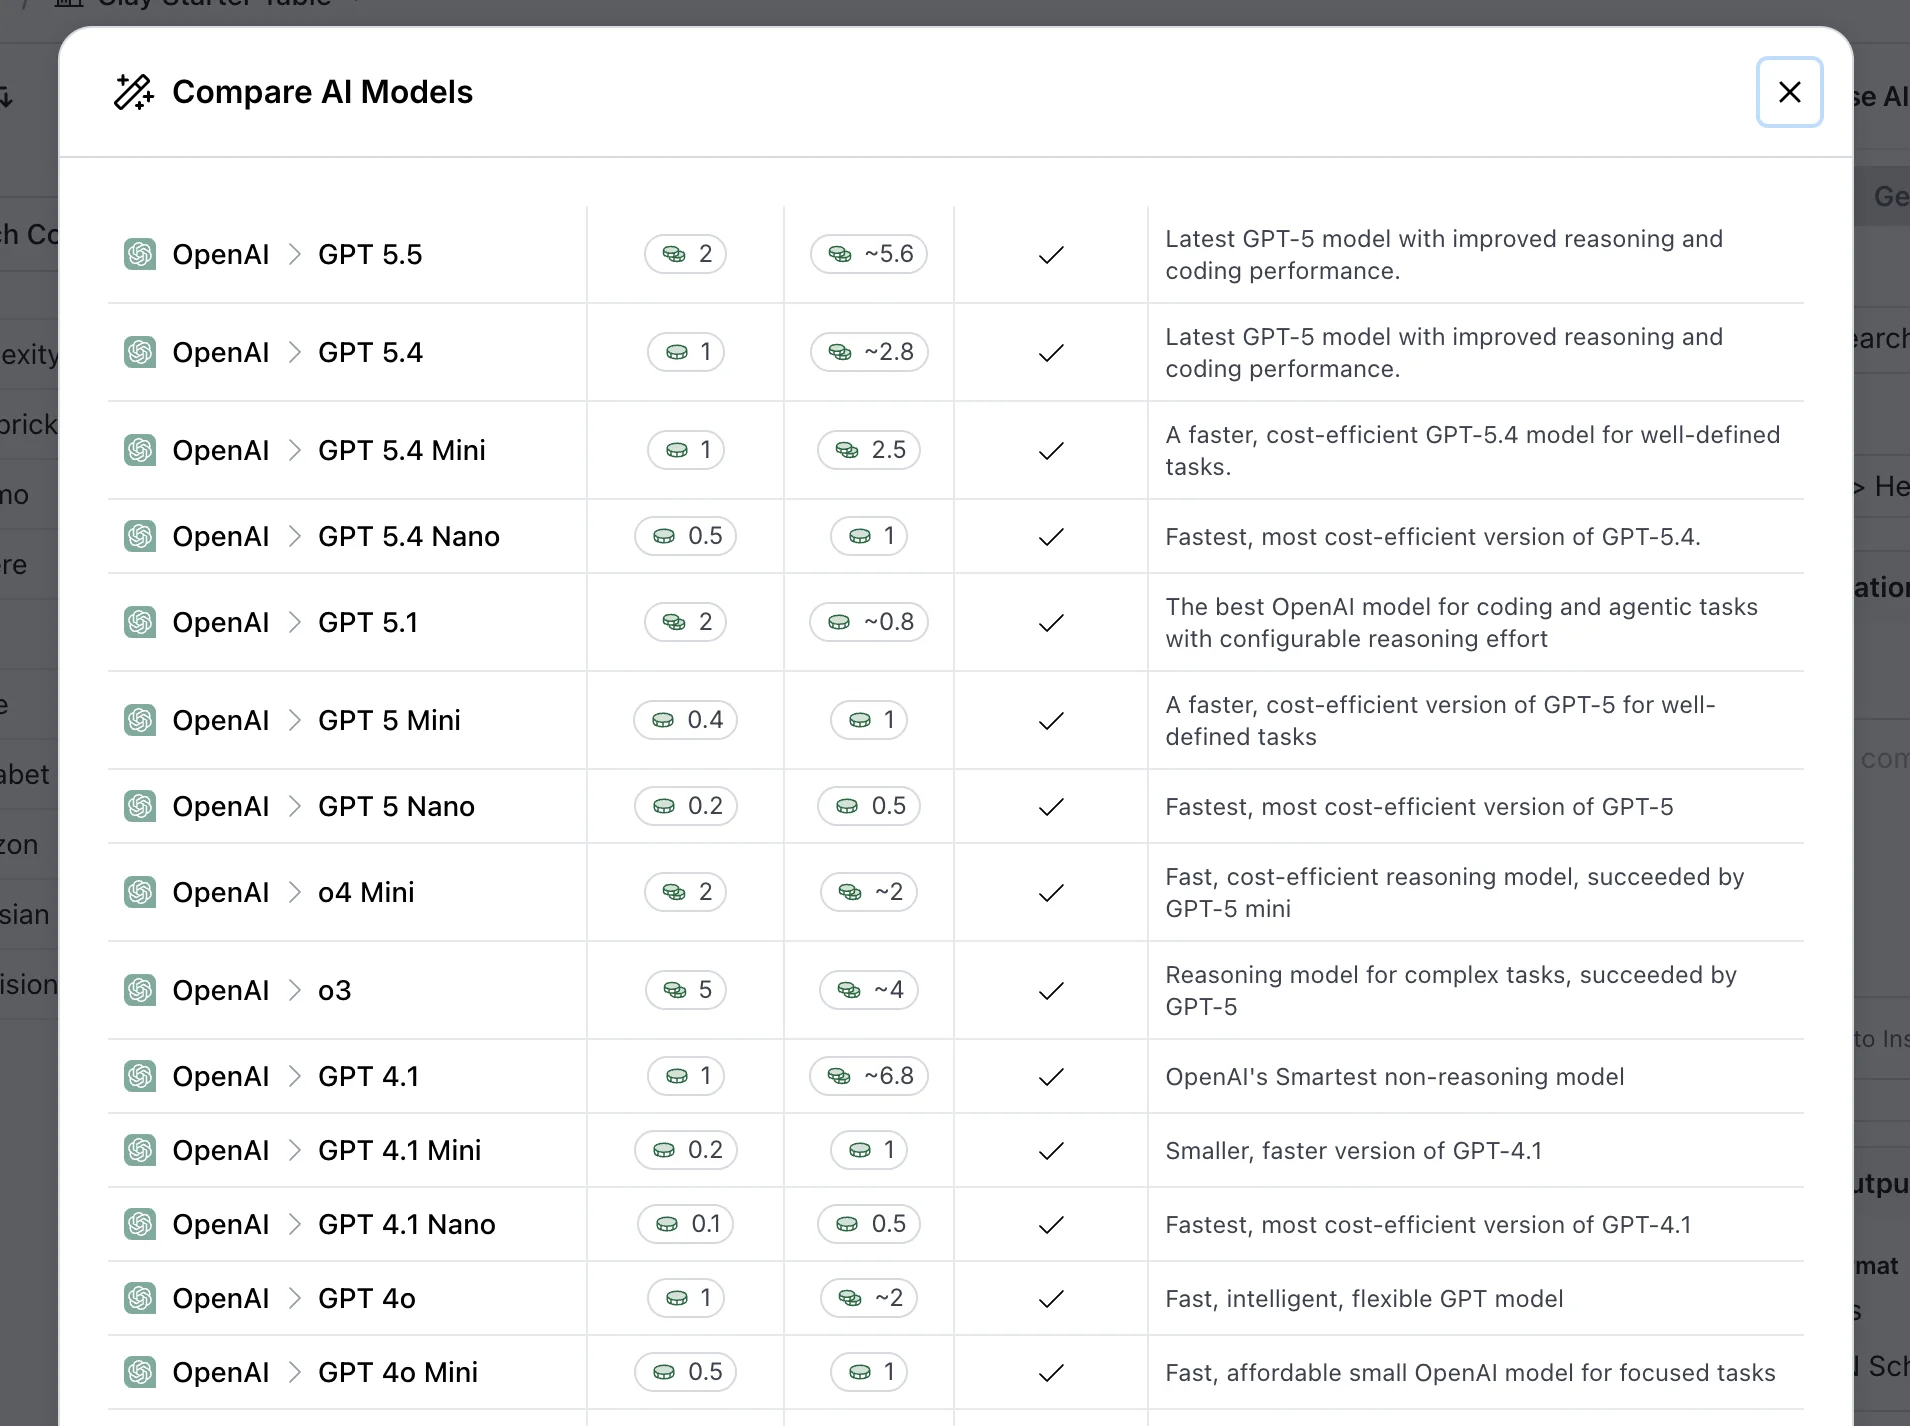
Hier is de rest. Er zit zelfs DeepSeek tussen.
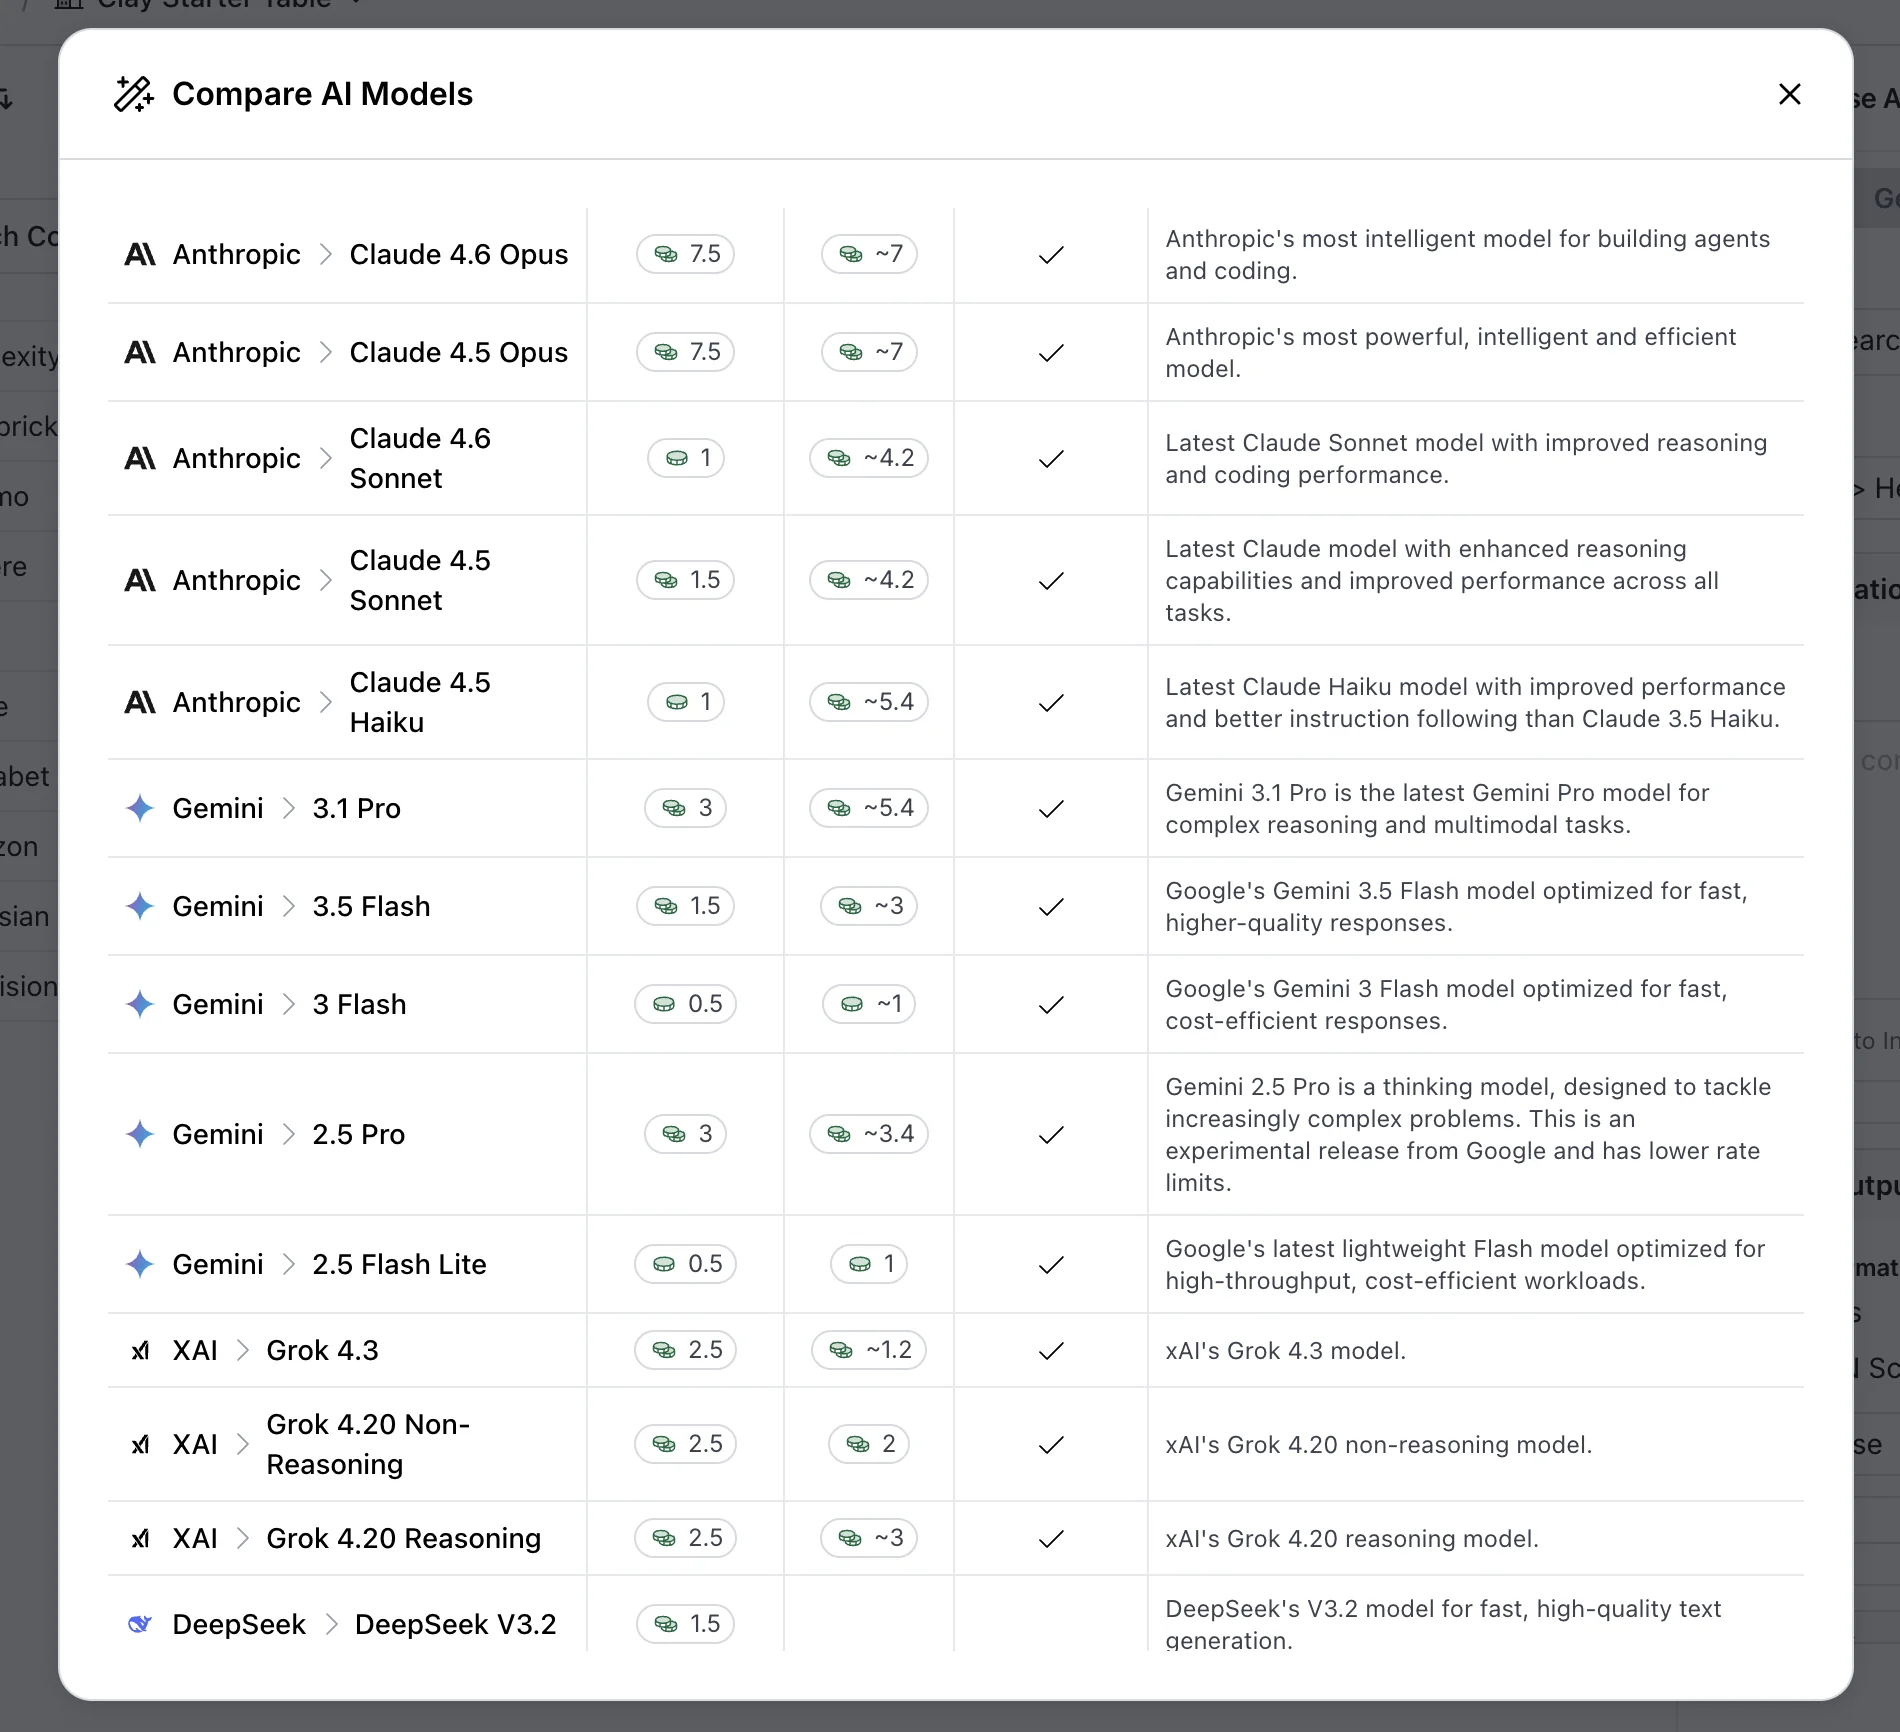
GPT-5.5 (uitgebracht in april 2026) en Claude Opus 4.7 (uitgebracht in april 2026) zijn de huidige topopties van OpenAI en Anthropic. Gemini 2.0 Flash is de Google-optie in het dropdownmenu.
Die gebruiken we voor de kwalificatielogica, de relevantiescores en elke prompt waarbij het werk bestaat uit redeneren over rijdata die we al hebben.
Hoe we in een echte workflow kiezen
Het hybride patroon dat we in de meeste klanttabellen gebruiken: licht beginnen en opschalen.
Helium doet de eerste ronde voor één credit per rij. Elke rij die leeg terugkomt, met lage zekerheid of met een duidelijke formaatfout, draaien we opnieuw op Argon.
Stappen met veel denkwerk die geen browsen nodig hebben (kwalificeren, scoren, routeren) geven we aan GPT-5.5 of Claude Opus 4.7 in plaats van aan een van de eigen Claygent-modellen.
Sam Holding deed een openbare vergelijking van de drie eigen Claygents op een researchtaak, tijdens een van de eerdere modelrondes van Clay. Argon was het nauwkeurigst, en Helium bleek bij simpelere vragen het meest kosteneffectief.
Clay heeft de modellen sindsdien bijgewerkt, maar de verhoudingen in die uitkomst kloppen nog steeds.
Argon is zwaarder, Helium is lichter, en de afweging tussen kosten en nauwkeurigheid is dezelfde die je maakt bij elke modelkeuze in welke AI-workflow dan ook.
Wat je hieruit meeneemt: de modelkeuze maak je niet één keer om er daarna nooit meer naar te kijken. Verschillende Claygents in dezelfde workflow kunnen verschillende modellen gebruiken, en het systeem wordt goedkoper en nauwkeuriger als je het model afstemt op de klus in plaats van overal standaard de zwaarste optie te kiezen.
Zo schrijf je Claygent AI-prompts die werken: het S.P.I.C.E.-framework
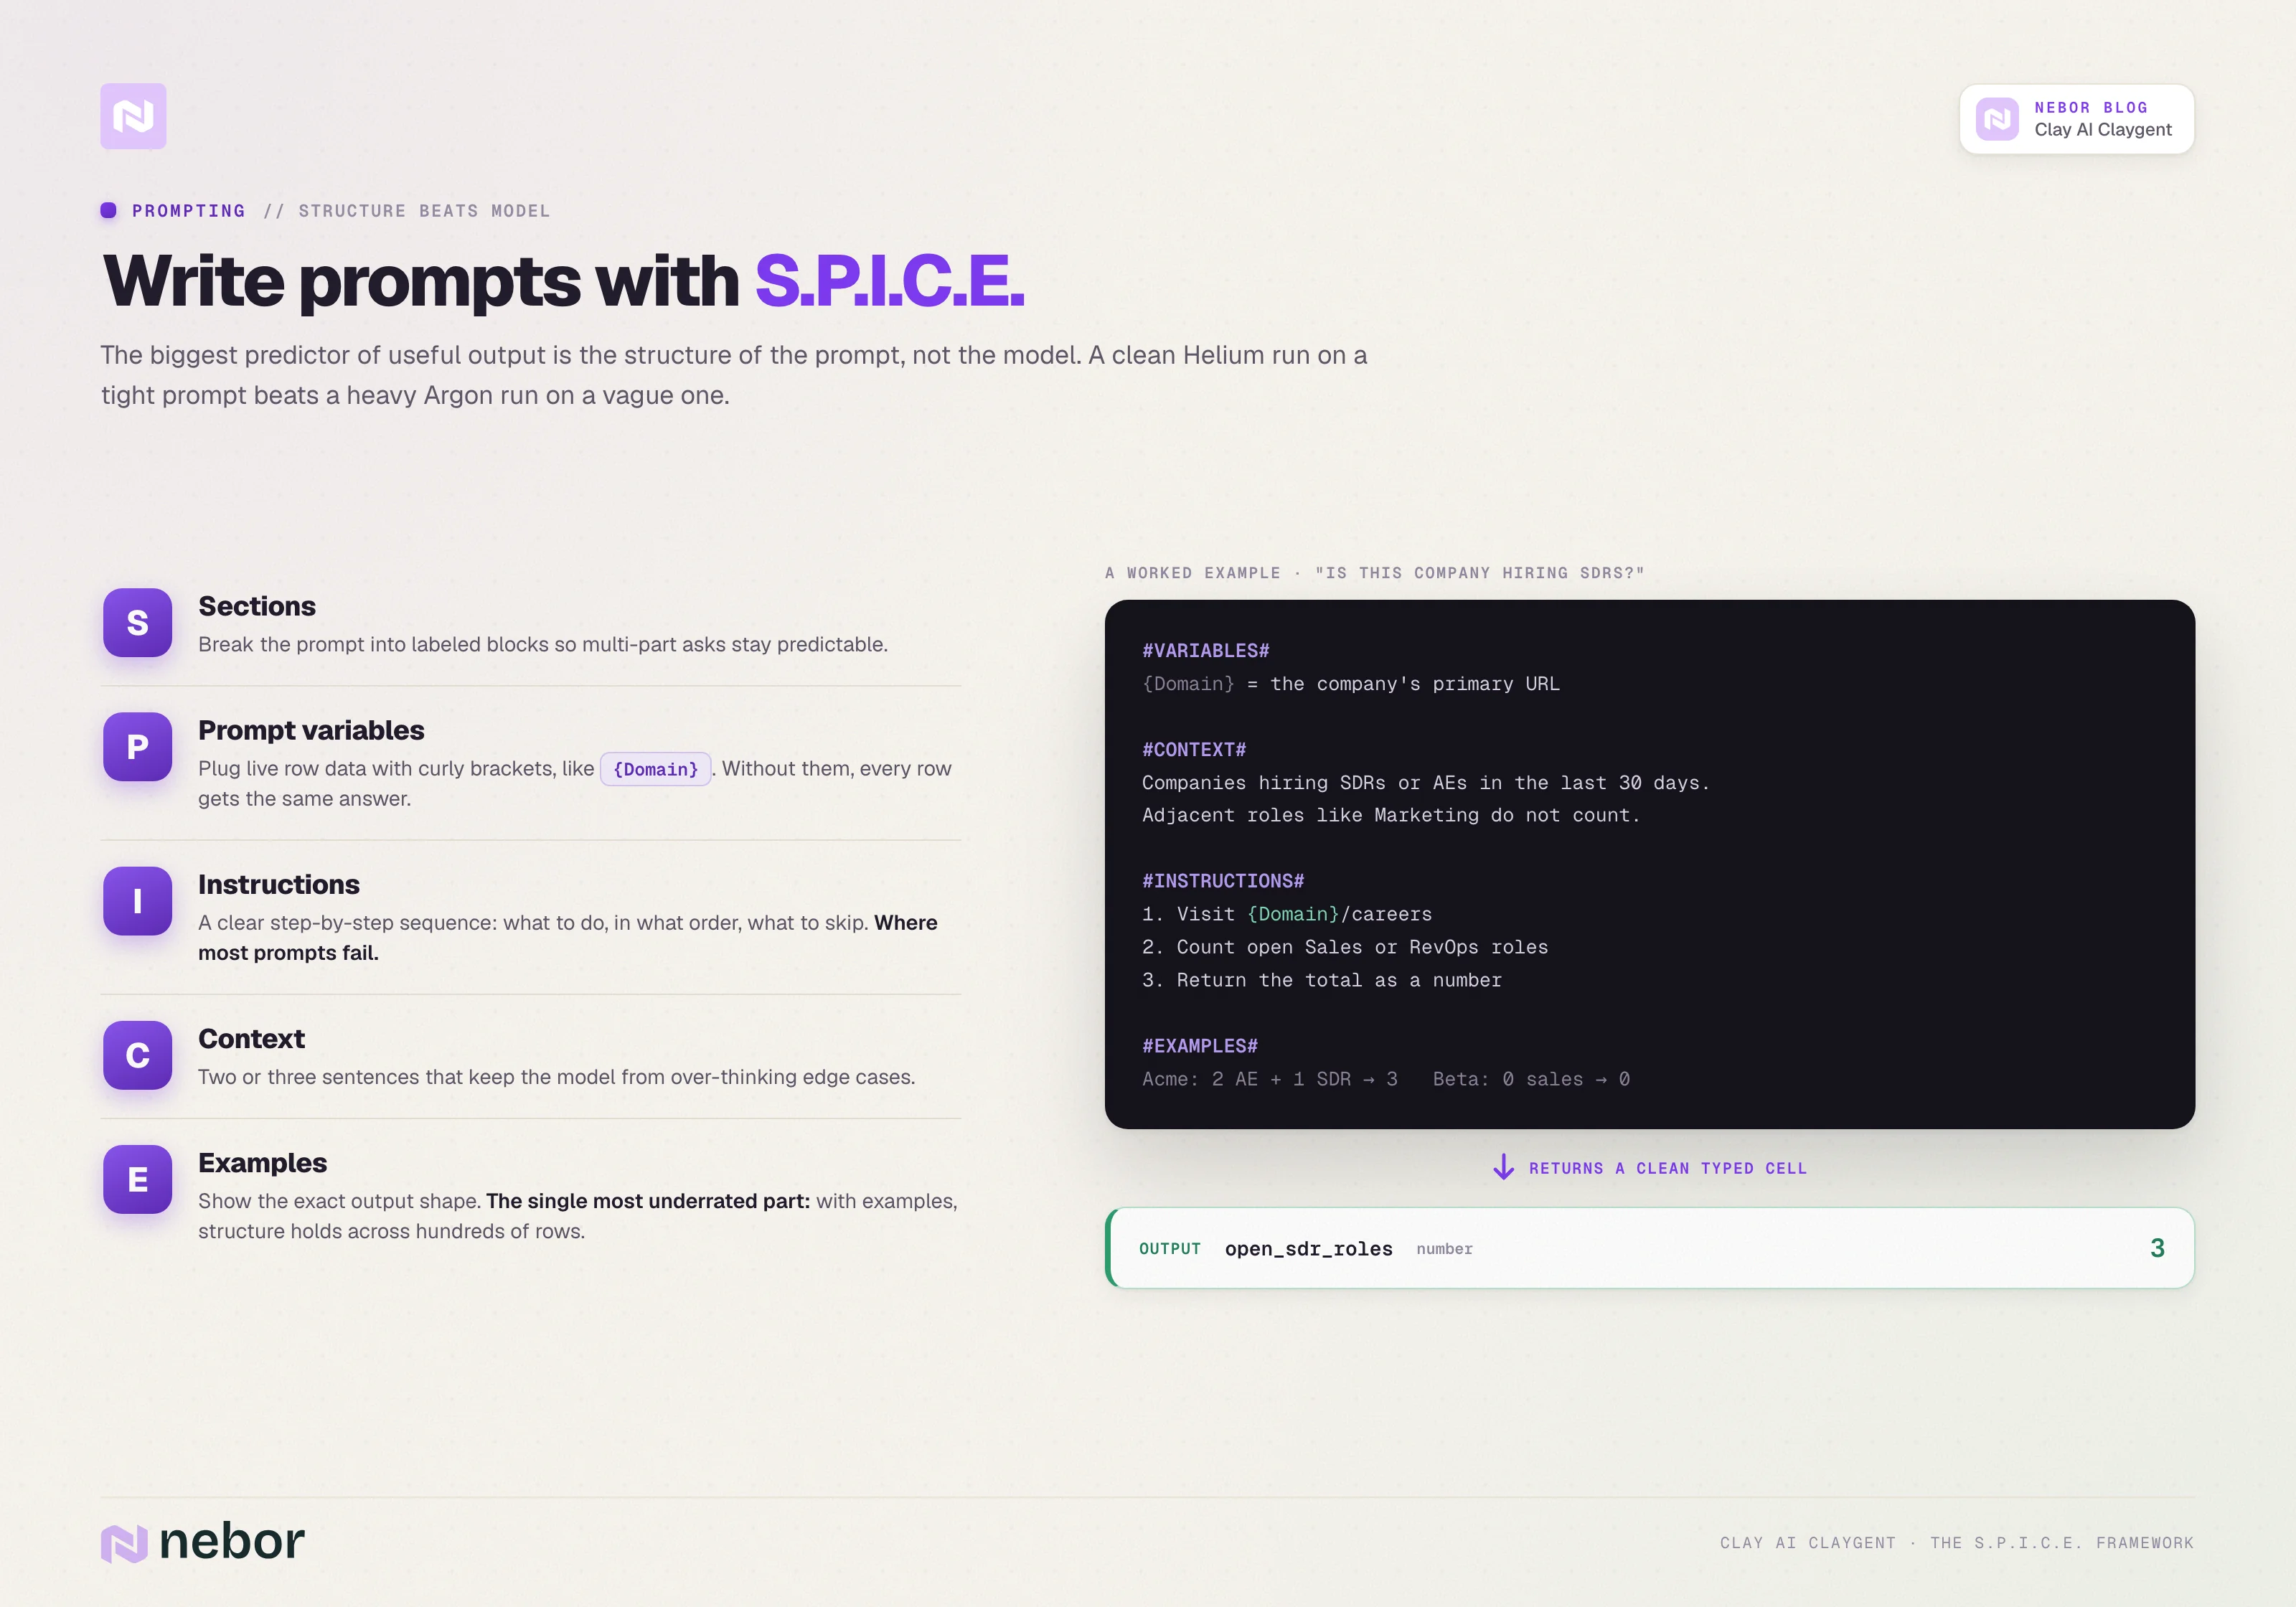
Of een Claygent bruikbare data teruggeeft, hangt het meest af van de opbouw van de prompt. Het gekozen model weegt veel minder zwaar.
Een zware Argon-ronde op een vage prompt levert vage resultaten op. Een nette Helium-ronde op een strak opgebouwde prompt levert nette, gestructureerde resultaten op.
Het eigen S.P.I.C.E.-framework van Clay is het helderste raamwerk dat we hebben gevonden voor het schrijven van Claygent-prompts. Het acroniem staat voor de vijf onderdelen die elke goede Claygent-prompt heeft: Sections, Prompt variables, Instructions, Context en Examples.
Sections
Verdeel de prompt in secties met koppen tussen hekjes, zoals #VARIABLES#, #CONTEXT#, #INSTRUCTIONS# en #EXAMPLES#. Die koppen helpen het model om de prompt in zijn functionele delen op te splitsen en de setup los te zien van de taak zelf.
Sla je deze stap over, dan gaat de prompt niet altijd stuk. Wel wordt de output minder voorspelbaar als de prompt uit meerdere delen bestaat.
Prompt variables
Verwijs tussen accolades naar je inputkolommen om live rijdata in de prompt te zetten. Heeft de rij een kolom Domain, dan gebruikt de prompt {Domain}. Heeft hij een kolom Company Name, dan gebruikt de prompt {CompanyName}.
Via de variabelen weet Claygent welke data in de huidige rij staat. Zonder variabelen vult het model alles in op basis van alleen de prompttekst, en dan krijg je voor elke rij hetzelfde antwoord.
Instructions
Schrijf de taak uit als een heldere reeks stappen. Vertel Claygent wat hij moet doen, in welke volgorde en wat hij moet overslaan. "Ga naar de vacaturepagina van het bedrijf op {Domain}/careers. Tel hoeveel vacatures er openstaan in Sales of Revenue Operations. Geef het totaal terug als getal."
In onze ervaring gaan de meeste prompts mis op de instructies. Mensen schrijven het doel op maar slaan de stappen over, en het model vult die stappen dan zelf in, met wisselend resultaat.
Context
Geef het model een korte uitleg over waarom deze prompt ertoe doet en hoe goede output eruitziet. "We bouwen een lijst van bedrijven die actief sales reps werven, zodat we onze outreach kunnen prioriteren. Vacatures in aangrenzende functies zoals Marketing tellen niet mee."
De contextalinea is kort, meestal twee of drie zinnen. Het model hoeft dan niet te lang na te denken over dubbelzinnige randgevallen.
Examples
Laat twee of drie voorbeelden zien van precies de outputvorm die je verwacht. Voorbeelden zijn het meest onderschatte onderdeel van Claygent-prompts.
Een prompt met voorbeelden geeft over honderden rijen consistent gestructureerde output terug. Dezelfde prompt zonder voorbeelden geeft ongeveer een op de drie rijen terug in een formaat dat het kolomtype verderop breekt. Dat verschil bepaalt of je een workflow hebt die je op schaal kunt vertrouwen of een workflow waar je constant op moet passen.
Een uitgewerkt voorbeeld
Alles bij elkaar ziet een Claygent-prompt voor "werft dit bedrijf actief SDR's" er ongeveer zo uit.
#VARIABLES#
{Domain} = de primaire URL van het bedrijf
#CONTEXT#
We bouwen een lijst van bedrijven die de afgelopen 30 dagen actief SDR's of Account Executives werven. Vacatures in aangrenzende functies zoals Marketing of Customer Success tellen niet mee.
#INSTRUCTIONS#
1. Ga naar {Domain}/careers of naar het vacatureplatform van het bedrijf als dat vanaf de homepage gelinkt is.
2. Zoek naar openstaande vacatures met SDR, BDR, Account Executive of Sales Development in de functietitel.
3. Geef het aantal terug als getal. Geef nul terug als de pagina geen vacatures heeft of niet laadt.
#EXAMPLES#
De vacaturepagina van Acme Corp toont 2 openstaande vacatures voor Account Executive en 1 voor SDR. Output: 3.
De vacaturepagina van Beta Inc toont 0 openstaande salesvacatures en 4 engineeringvacatures. Output: 0.
Die prompt geeft nette getallen terug in een getypeerde Number-kolom. Schrijf je dezelfde klus als "zoek hun openstaande salesvacatures", dan krijg je de helft van de tijd inconsistente tekst terug.
De discipline om gestructureerde prompts te schrijven kost weinig. Het effect dat zich opstapelt over een workflow met vijf of zes Claygent-prompts is groot.
Zo formatteer je je Claygent-output zodat hij verderop bruikbaar is
Met het juiste outputformaat wordt een handige Claygent een bruikbare stap in je workflow.
De Claygent kan het perfecte antwoord teruggeven. Klopt het kolomtype niet, dan kan niets verderop er netjes mee werken.
In de kolominstellingen kies je uit vijf outputtypes voor Claygent.
Text voor namen, beschrijvingen en alles wat je niet hoeft te sorteren of te berekenen
Number voor alles wat je optelt, telt, middelt of filtert op een numerieke drempel
URL voor links die klikbaar moeten blijven in de tool verderop
True/false voor kwalificatievragen met twee mogelijke antwoorden
JSON voor gestructureerde payloads die naar een volgende stap gaan
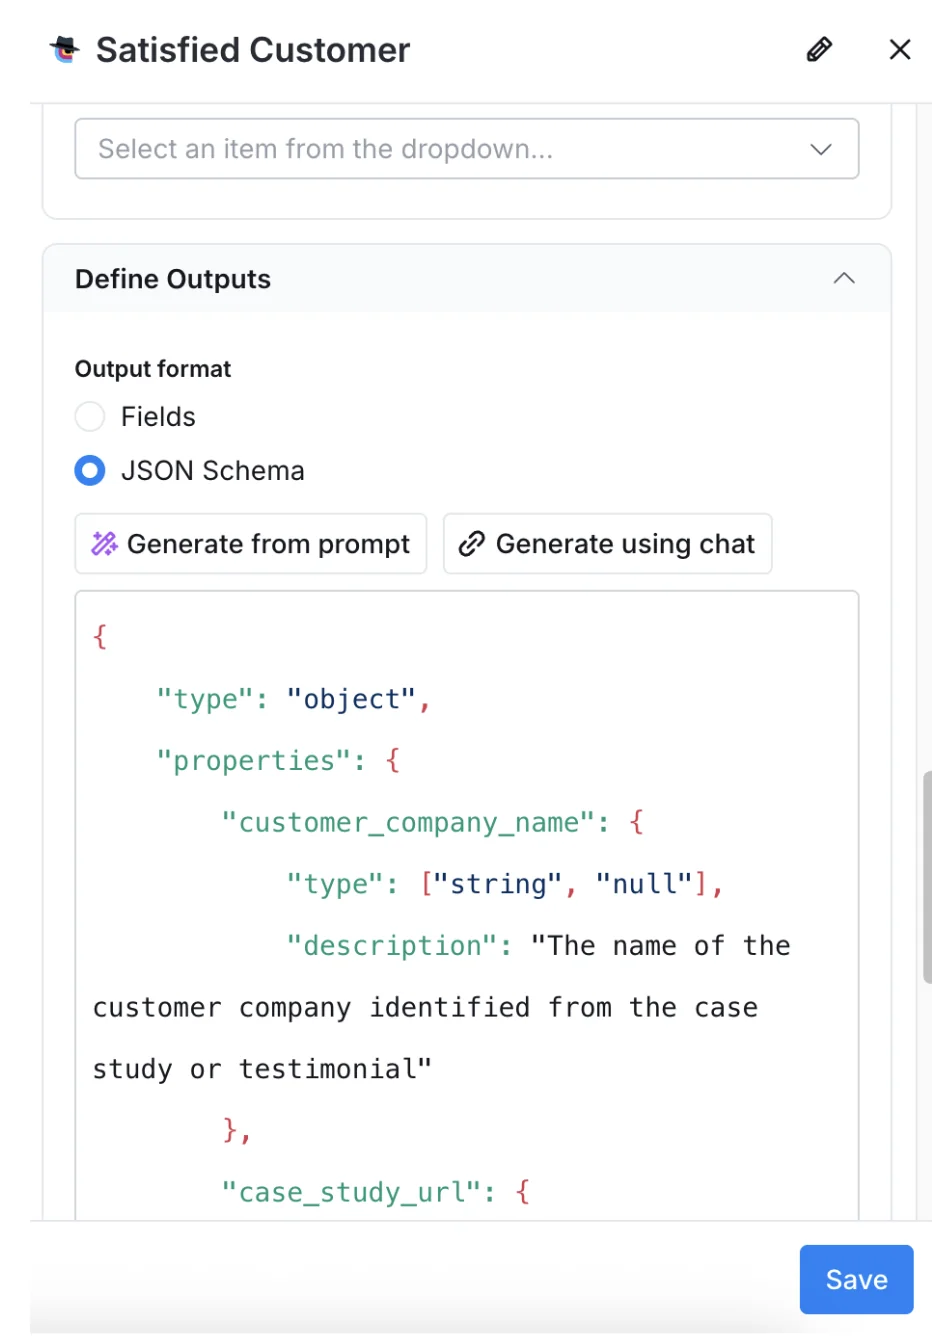
Het type doet ertoe omdat Clay getypeerde kolommen verschillend behandelt. Een Number-kolom kun je filteren op groter dan en kleiner dan.
URL-kolommen verschijnen als klikbare links die de rep kan gebruiken. En een true/false-kolom stuurt de voorwaardelijke logica van de volgende stap in de tabel.
Zet je de output op tekst terwijl het antwoord een getal is, dan ben je dat allemaal kwijt. De Claygent geeft nog steeds “47” terug, maar de volgende stap kan er niet mee rekenen, er niet op filteren en het niet netjes doorgeven aan het outboundplatform.
De meeste Claygent-prompts geven één kolom terug aan één tabel. De interessantere prompts geven drie tot vijf getypeerde kolommen terug vanuit dezelfde modelcall, en daar verdient Neon zijn creditprijs terug.
Eén kwalificerende Claygent kan in één rij een ja/nee, een reden, een zekerheidsscore en een bron-URL teruggeven, allemaal gevuld vanuit één paginabezoek.
JSON-output verdient een aparte vermelding, omdat het verandert wat de volgende stap in de workflow kan doen.
Een Claygent die zijn resultaat als JSON teruggeeft, kan direct de input vormen voor een volgende Claygent, voor een n8n-flow die op de structuur vertakt of voor een CRM-veld dat een gestructureerde payload verwacht. JSON is de juiste keuze als de output van de ene Claygent de input van de andere wordt.
Controleer voor elke Claygent-kolom het gekozen outputtype voordat je de workflow op de hele tabel loslaat. Met de testrijen uit sectie drie check je of het kolomtype past bij de data die Claygent echt teruggeeft.
Zo bouw je een Claygent voor bijna elke functie in sales, RevOps, marketing en customer success (use cases)
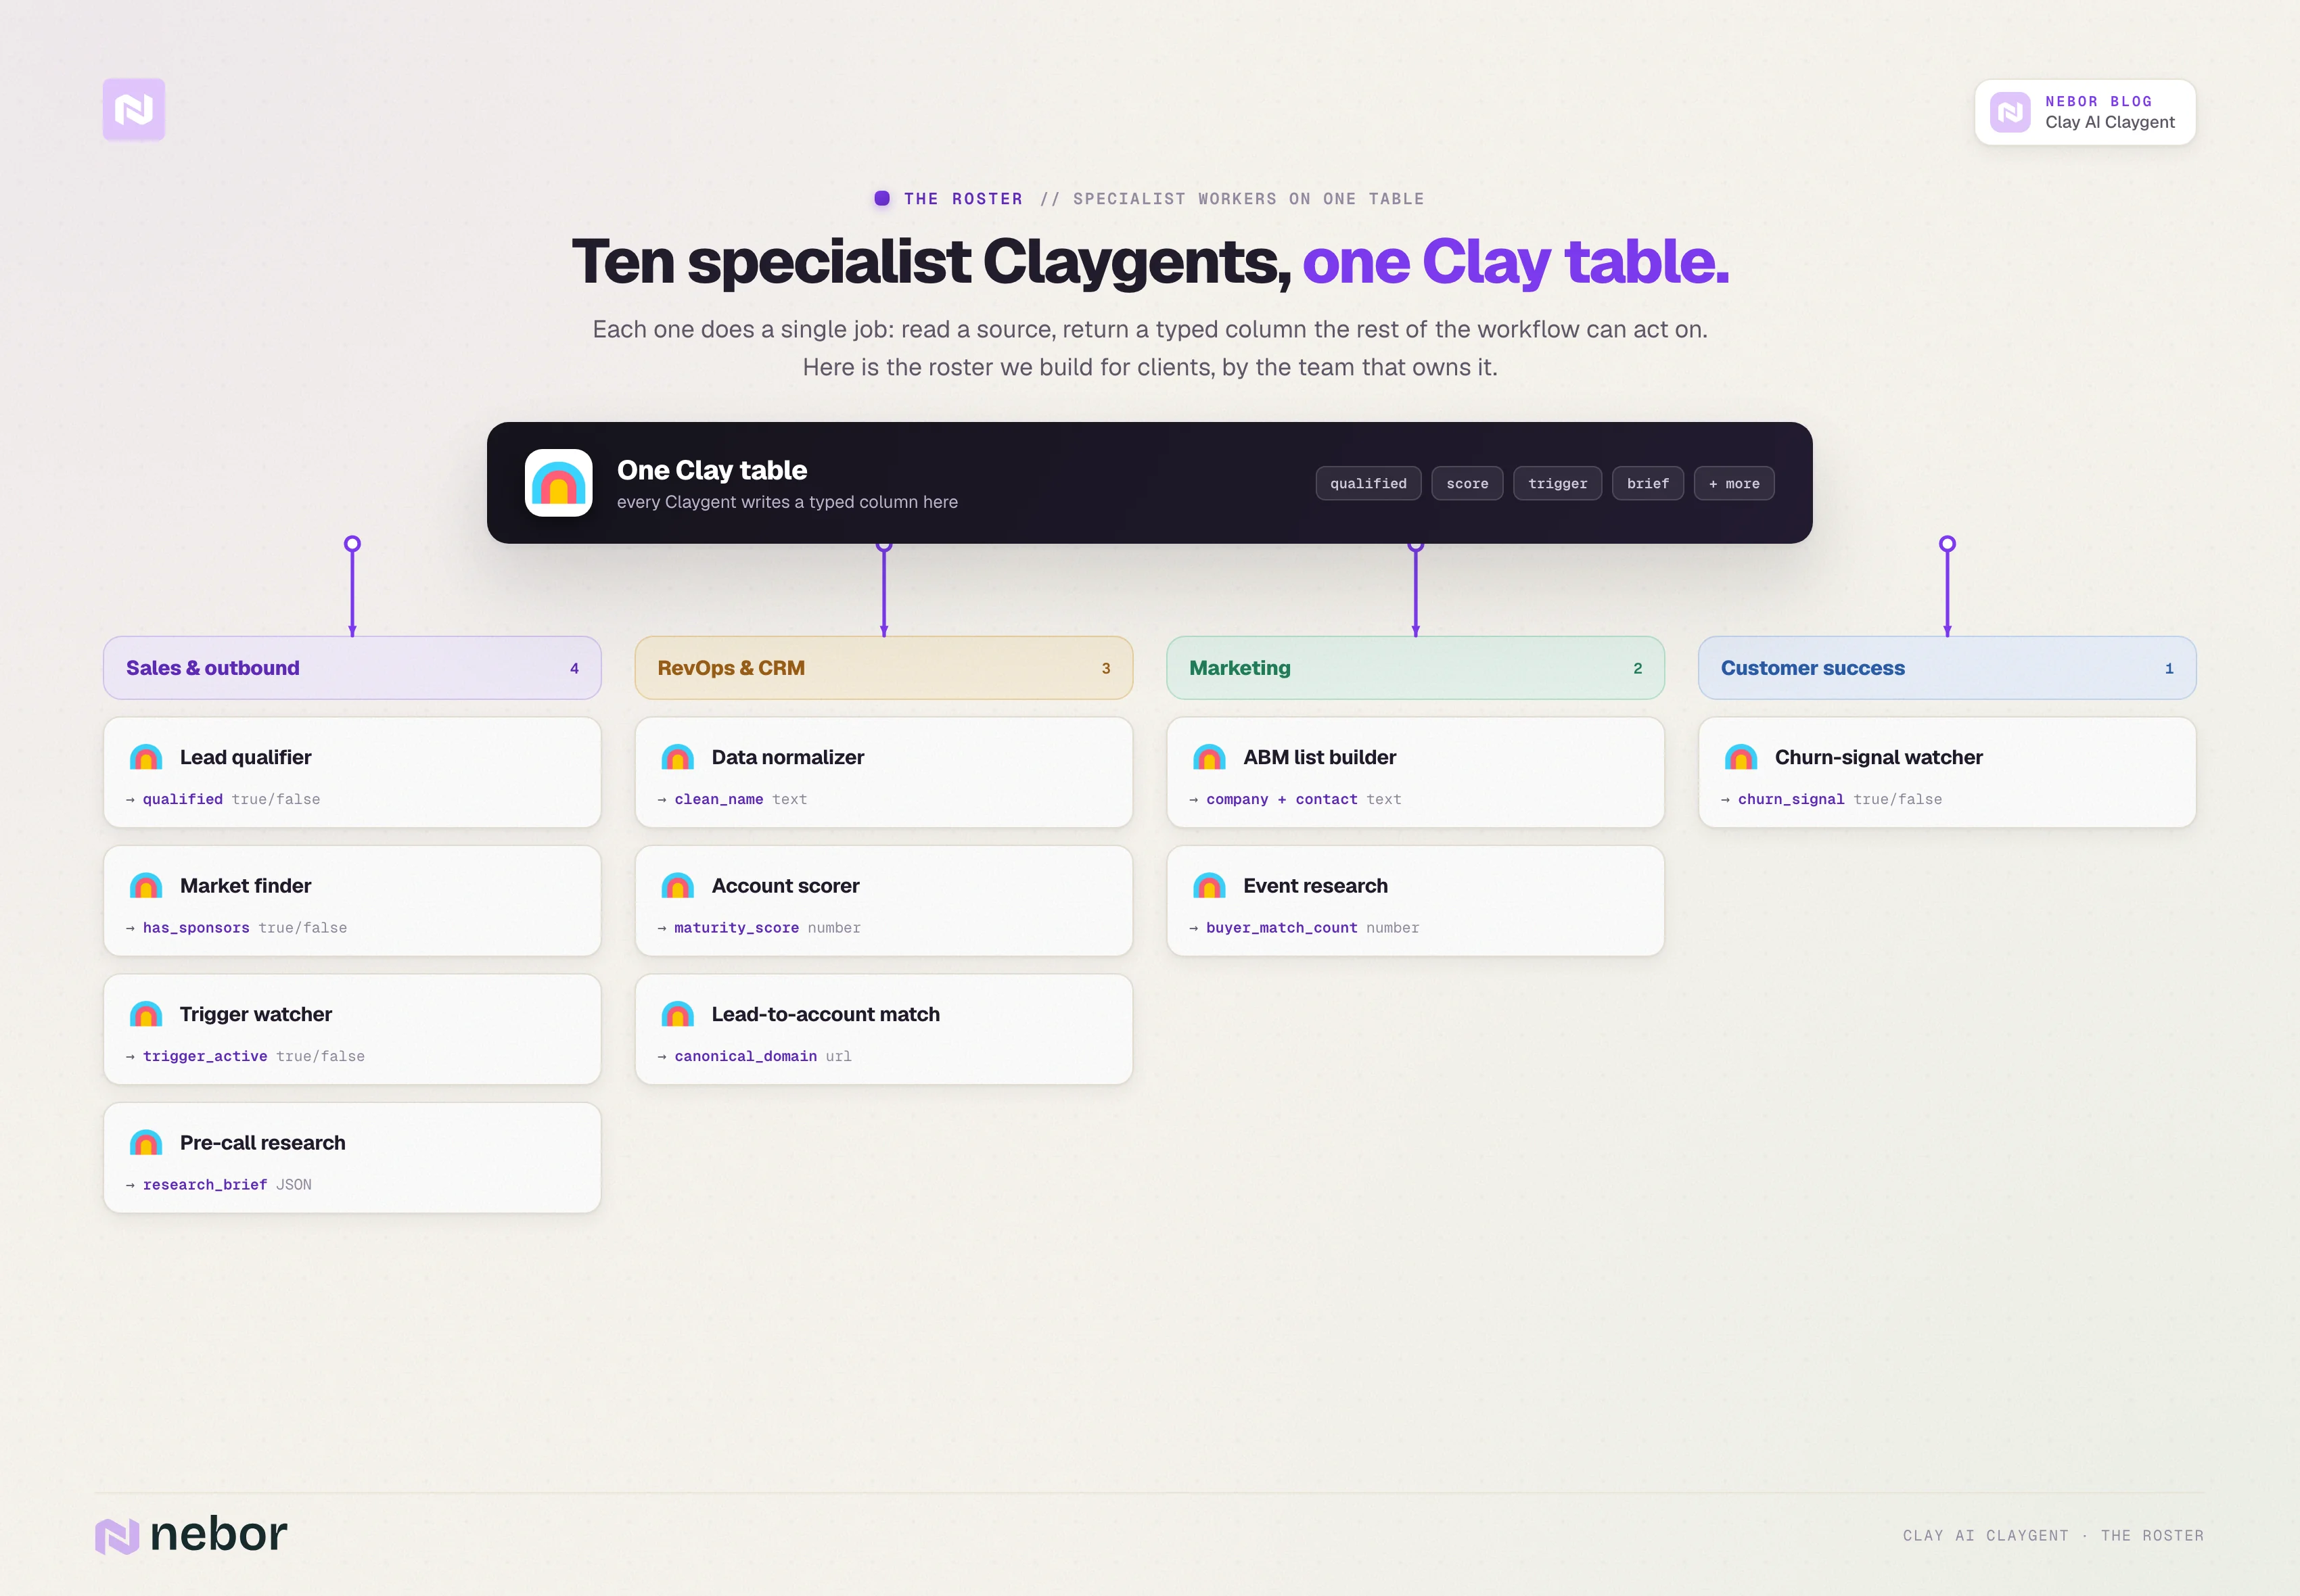
In de Utmost-versie van dit artikel bleven de use cases binnen outbound sales. Hier gaan we breder, omdat de modelkiezer, de promptopbouw en de outputformattering uit de vorige secties net zo goed werken voor andere GTM-functies.
De use cases hieronder zijn patronen die we voor klanten hebben gebouwd, ingedeeld naar het team dat eigenaar is van de workflow. Voor geen van alle heb je meer Clay-kennis nodig dan je al hebt.
Ze hebben allemaal dezelfde vorm. Bepaal een klus, richt een Claygent op de juiste bron en geef een getypeerde output terug waar een ander deel van de workflow iets mee kan.
Bij elke use case hieronder staat een representatieve promptopbouw. De prompts zijn ingekort tot de delen die het meest tellen (de instructies en de getypeerde output), omdat je het volledige S.P.I.C.E.-formaat in sectie vijf al hebt gezien.
4 Clay AI Claygent-use cases voor sales en outbound
Het oorspronkelijke Utmost-artikel behandelde vijf outbound-use cases. Hier krijgt Claygent de meeste aandacht, en de use cases hieronder bouwen we bij bijna elke outbound-opdracht.
Let op: het onderzoek dat je reps elke ochtend met de hand doen, is precies wat een Clay AI-agent 's nachts zou moeten doen.
Checken of een bedrijf in je ICP past, de site lezen, uitzoeken wie je moet benaderen en waarom juist nu. Claygent kan dat allemaal, en in de meeste workspaces doet hij er niets van, omdat niemand tijd had om de keten te ontwerpen.
Bij Nebor zijn we Clay Solutions Partner, en de meeste bouwtijd gaat bij ons naar Claygent. We koppelen agents aan elkaar: de ene kwalificeert het account, een andere let op een trigger waar je iets mee moet en weer een andere schrijft de opener. Ze schrijven allemaal terug naar dezelfde tabel, zodat je rep een rij opent waar het antwoord al in staat.
Plan een call van 15 minuten en laten we het over je Clay-setup hebben.
Bedrijven kwalificeren op rommelige criteria waar je dataprovider niet op kan filteren
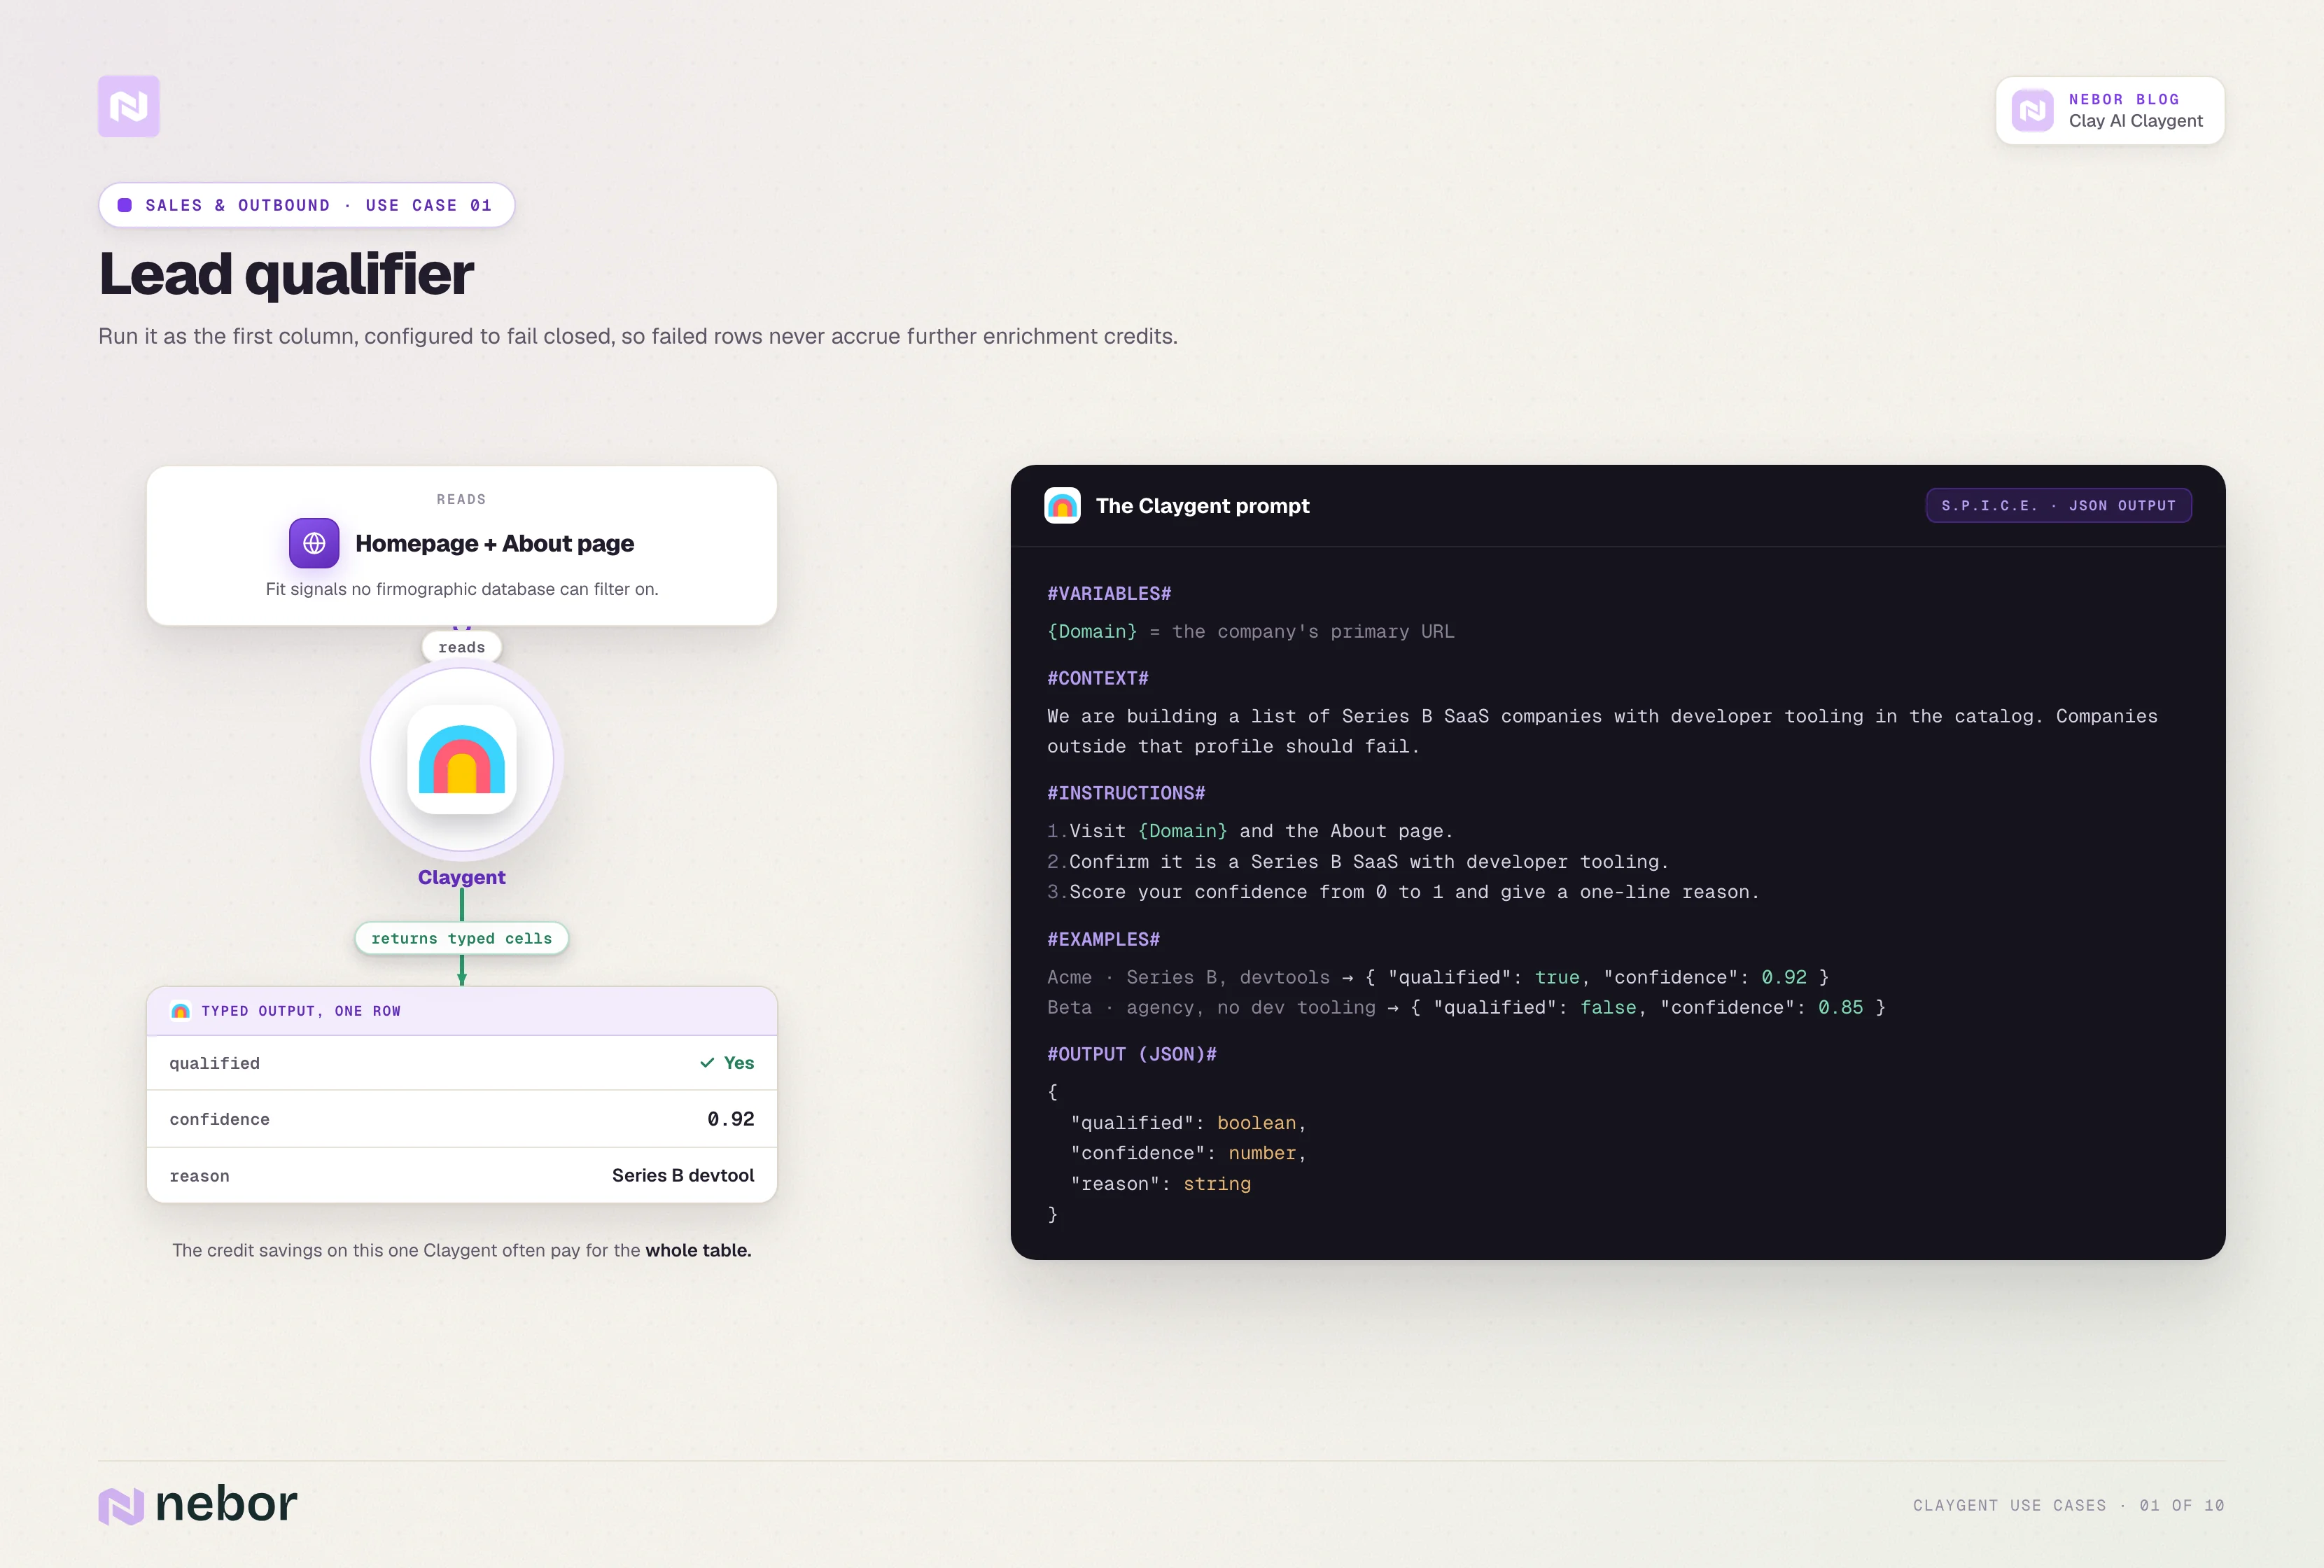
Dit is de eerste Claygent die we voor elke klant bouwen, omdat in bijna elke outboundlijst meer dan de helft van de rijen staat die er niet in horen.
Apollo en Cognism filteren op firmografische velden zoals branche, aantal medewerkers en omzetklasse. Ze kunnen niet filteren op de vraag of een bedrijf een Series B SaaS is met developer tooling in het aanbod, of een bureau drie of meer case studies over lifecycle marketing heeft gepubliceerd.
De kwalificatie-agent leest de homepage en About-pagina van het bedrijf en geeft een getypeerde ja/nee terug, plus een zekerheidsscore en een korte reden. We zetten hem als eerste kolom in de workflow, zo ingesteld dat een rij bij twijfel wordt tegengehouden (fail closed). Rijen die niet door de check komen, kosten daarna geen enrichment-credits meer.
Wat deze ene Claygent aan credits bespaart, betaalt vaak de hele tabel. In de meeste outboundlijsten kwalificeert maar een minderheid van de rijen, en als je enrichment op de afgewezen rijen overslaat, bespaar je echt geld zodra je boven een paar duizend rijen uitkomt.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {Domain} en de About-pagina.
2. Bevestig dat het bedrijf software verkoopt en geen diensten.
3. Bevestig dat het product zich richt op developers of engineeringteams.
4. Bevestig dat het bedrijf in de afgelopen 12 maanden een nieuw product of een grote update heeft uitgebracht.
5. Geef alleen ja terug als aan alle drie de voorwaarden is voldaan.
#OUTPUT#
qualifies (true/false)
reason (text, één zin)
confidence (number, 1-5)
Lookalike-bedrijven vinden in bronnen die je enrichment-provider niet dekt
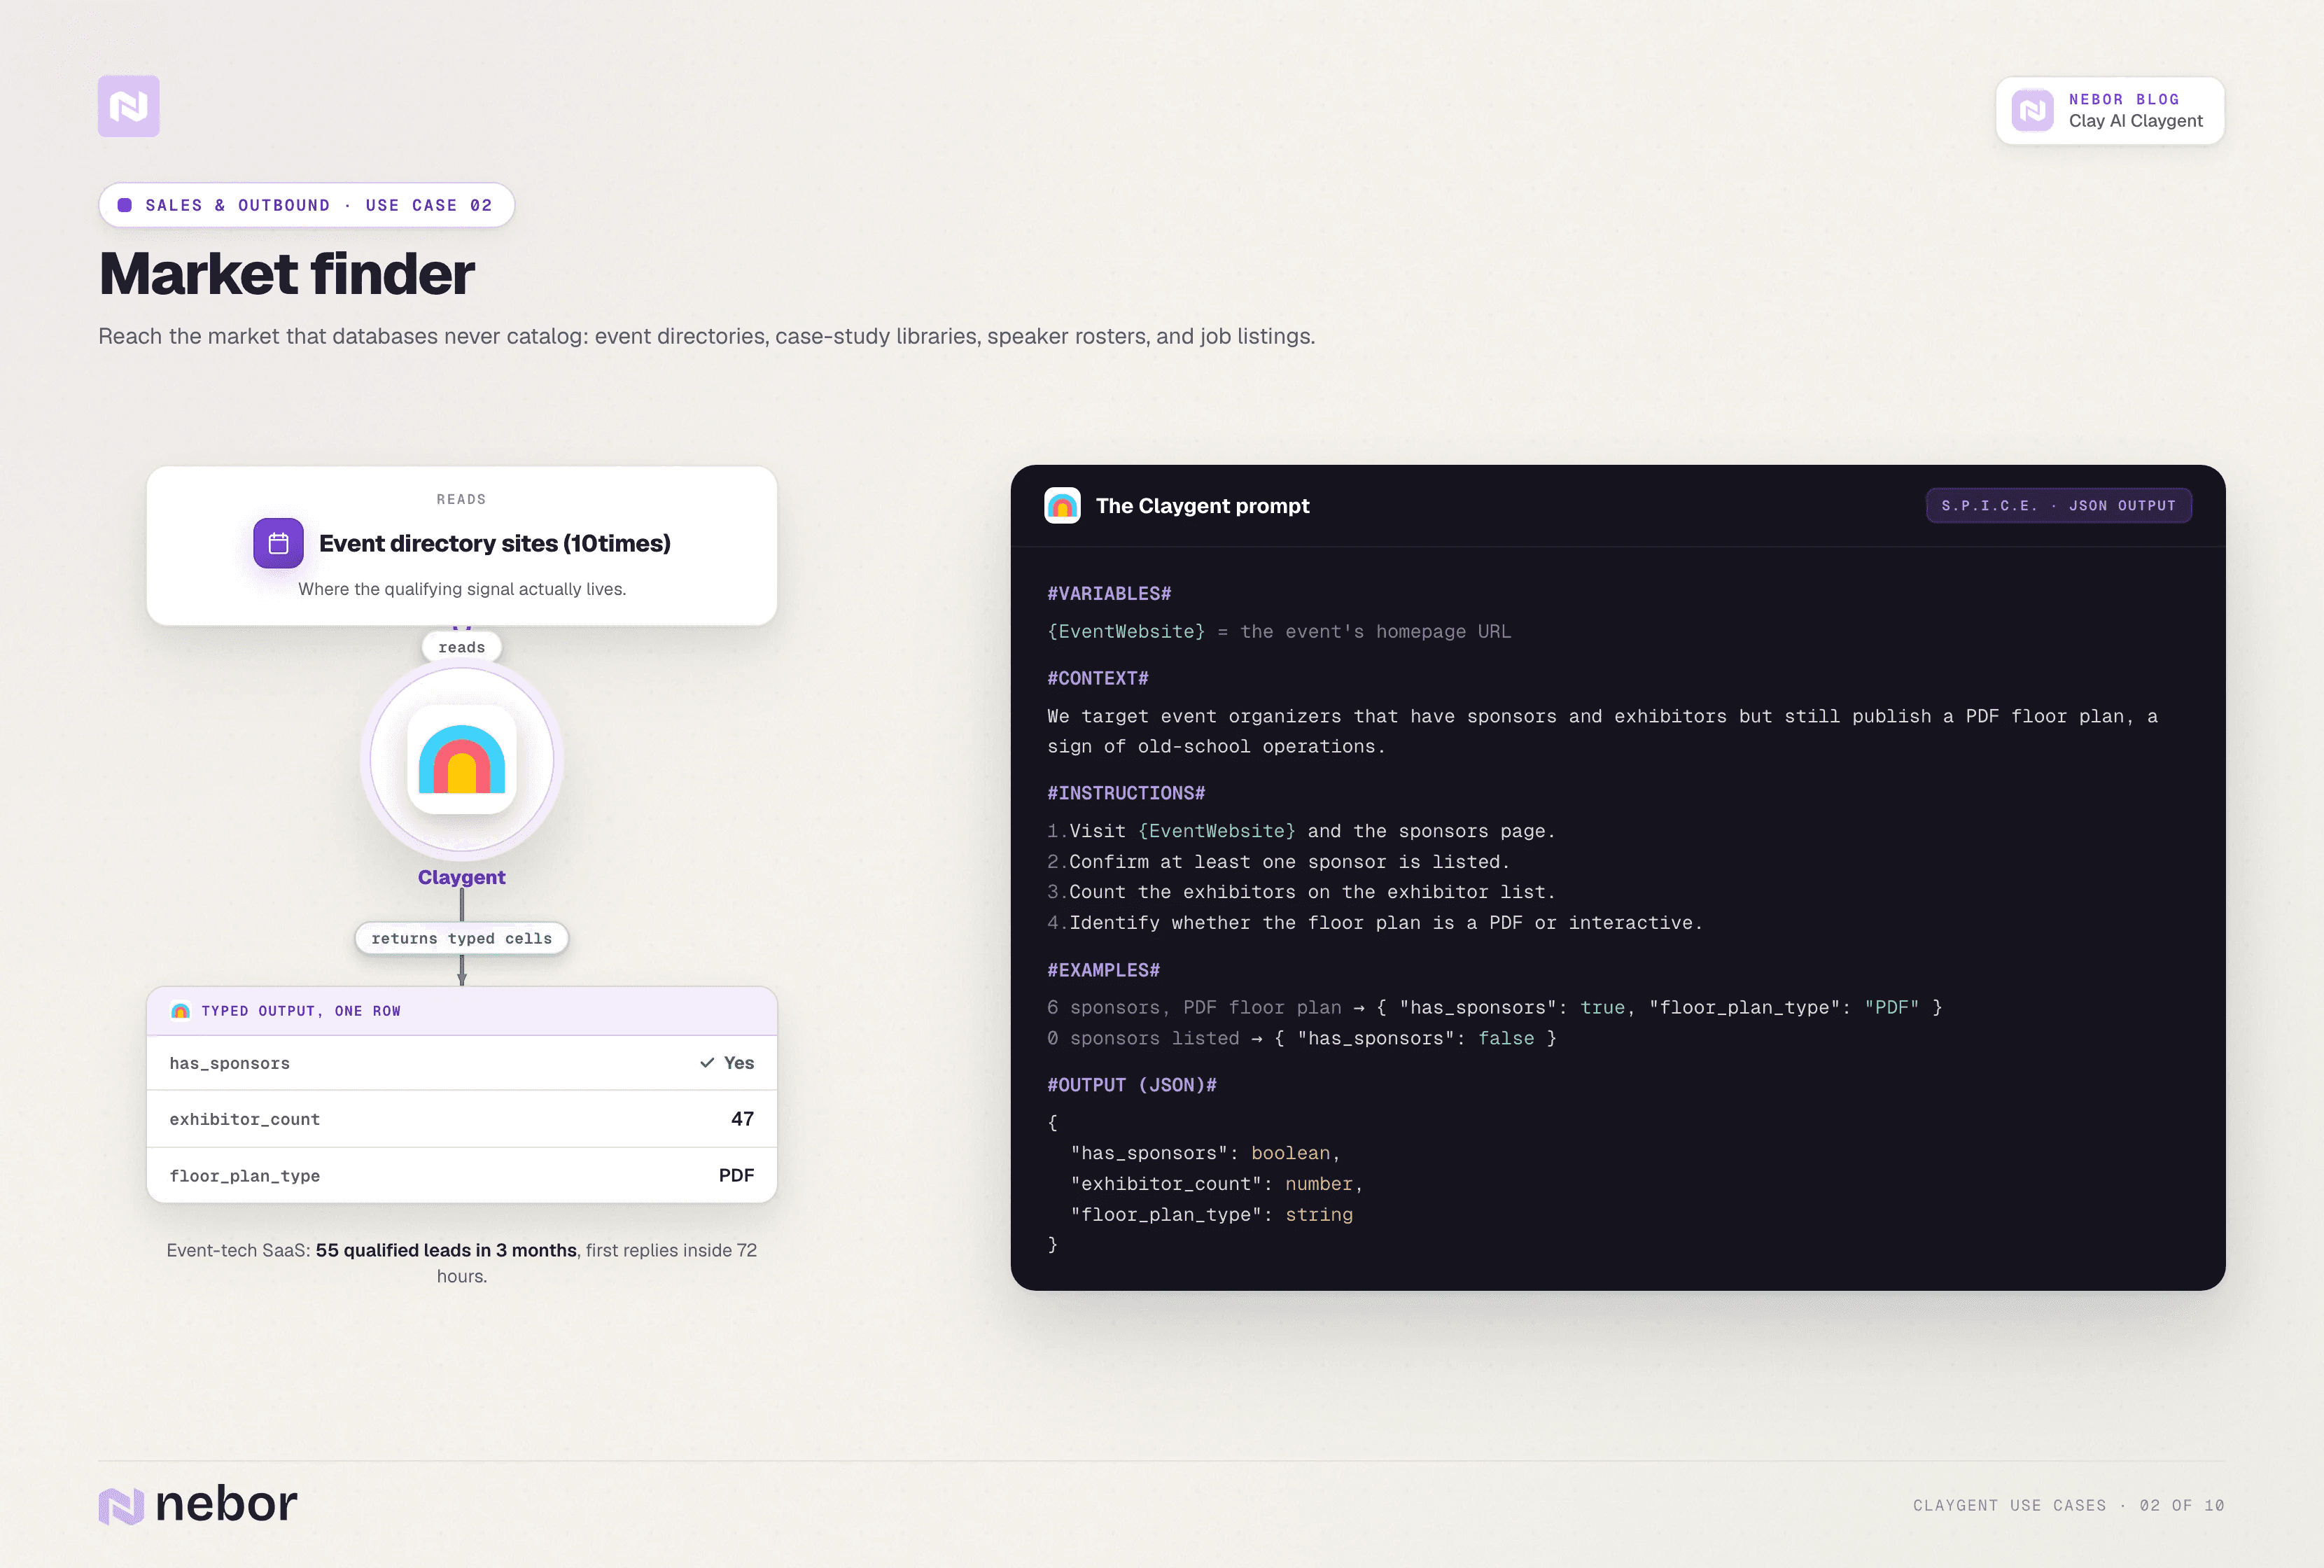
Je echte ICP zit meestal in kenmerken die geen enkele database bijhoudt. Logomuren met klanten op sites van concurrenten, partneroverzichten binnen software-ecosystemen, bibliotheken met case studies, sprekerslijsten van congressen, sponsorlijsten van evenementen en vacatures voor problemen die jij oplost bevatten allemaal signalen.
ExpoGenie is het voorbeeld waar we steeds op terugkomen. Hun doelmarkt stond op sites met evenementenoverzichten zoals 10times, en het kwalificerende signaal was zo specifiek dat Apollo er niets mee kon.
Ze zochten evenementen met sponsors en exposanten die nog pdf-plattegronden gebruikten, omdat pdf-plattegronden wezen op een ouderwetse organisatie die het platform van ExpoGenie kon vervangen.
We bouwden een Claygent die de website van elk evenement bezocht en drie getypeerde kolommen teruggaf: of er sponsors waren als boolean, het aantal exposanten als getal en de techniek van de plattegrond als tekst (pdf of interactief). Het resultaat was 55 gekwalificeerde leads in drie maanden en de eerste reacties binnen 72 uur na de start van de campagne.
Het patroon werkt ook ver buiten deze ene klant. Bijna elk B2B-bedrijf heeft een ICP-kenmerk dat op losse webpagina's staat en niet in Apollo. Claygent leest die pagina's op schaal en zet ze om in getypeerde rijen voor een TAM die je op geen andere manier had kunnen bouwen.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {EventURL}.
2. Bekijk de sponsorpagina en bevestig dat er minstens één sponsor op staat.
3. Tel de exposanten die zichtbaar zijn op de pagina met de exposantenlijst.
4. Stel vast of de plattegrond een downloadbare pdf is of een interactieve tool in de browser.
#OUTPUT#
has_sponsors (true/false)
exhibitor_count (number)
floor_plan_type (text, PDF of interactive)
Koopsignalen in de gaten houden in je hele TAM
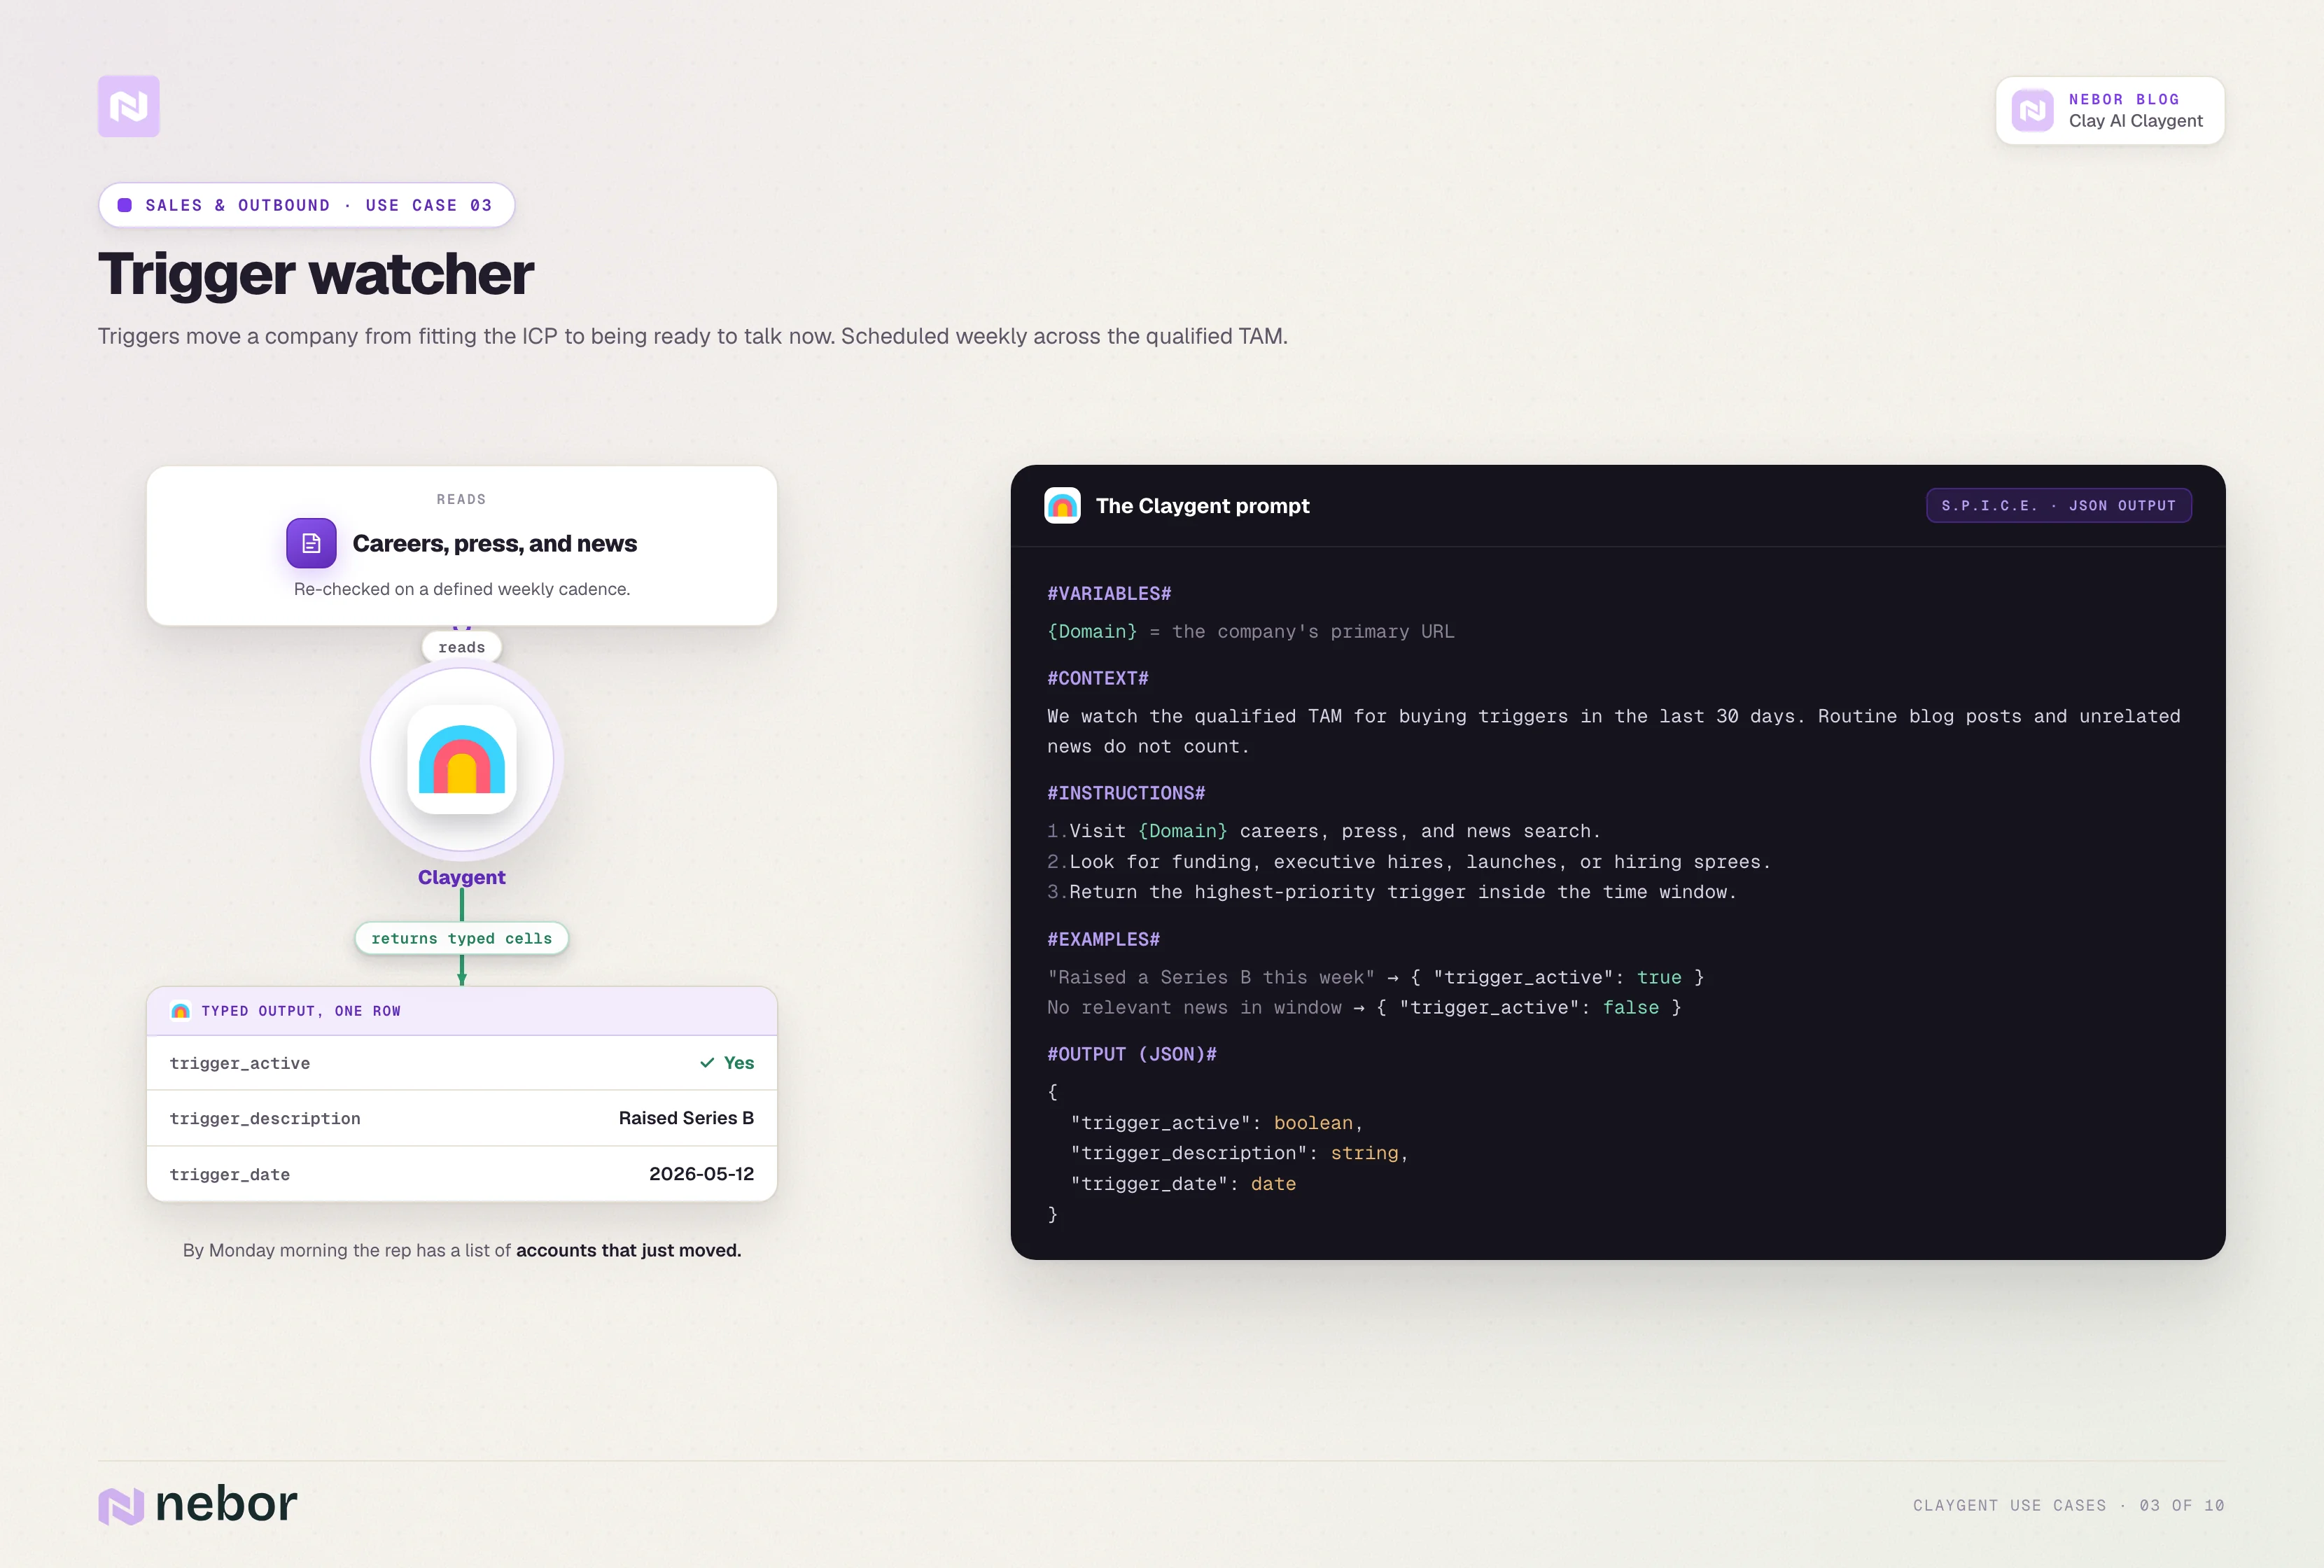
Triggers zijn de gebeurtenissen die een bedrijf van "past in het ICP" naar "klaar voor een gesprek" brengen. Denk aan investeringsrondes, nieuwe executives, productlanceringen, publieke uitspraken over een probleem dat jij oplost en wervingsgolven in aangrenzende functies.
De triggerwatcher leest met een vast ritme de vacaturepagina, de perspagina en nieuwsresultaten van het bedrijf. Hij geeft een boolean terug voor de vraag of er binnen de tijdsperiode een trigger actief is, een beschrijving van de trigger in één regel en een datum.
We laten de triggerwatcher elke week de gekwalificeerde TAM checken. Op maandagochtend heeft de rep een lijst met accounts waar net iets is gebeurd, met de gebeurtenis al uitgelicht.
Dit is de operationele ruggengraat van intent-gedreven outbound voor klanten van wie de externe intent-provider hun niche niet dekt.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar de persberichtensectie, de vacaturepagina en recente nieuwsresultaten voor {CompanyName}.
2. Zoek naar gebeurtenissen in de afgelopen 30 dagen die op koopbereidheid wijzen, zoals nieuwe financiering, nieuwe executives, wervingsgolven voor sales- of RevOps-functies, publieke productlanceringen of uitspraken over het uitbreiden van het GTM-team.
3. Geef de trigger met de hoogste prioriteit terug als je er meerdere vindt.
#OUTPUT#
trigger_active (true/false)
trigger_description (text)
trigger_date (date)
Research voor een call bundelen en een relevantieregel schrijven
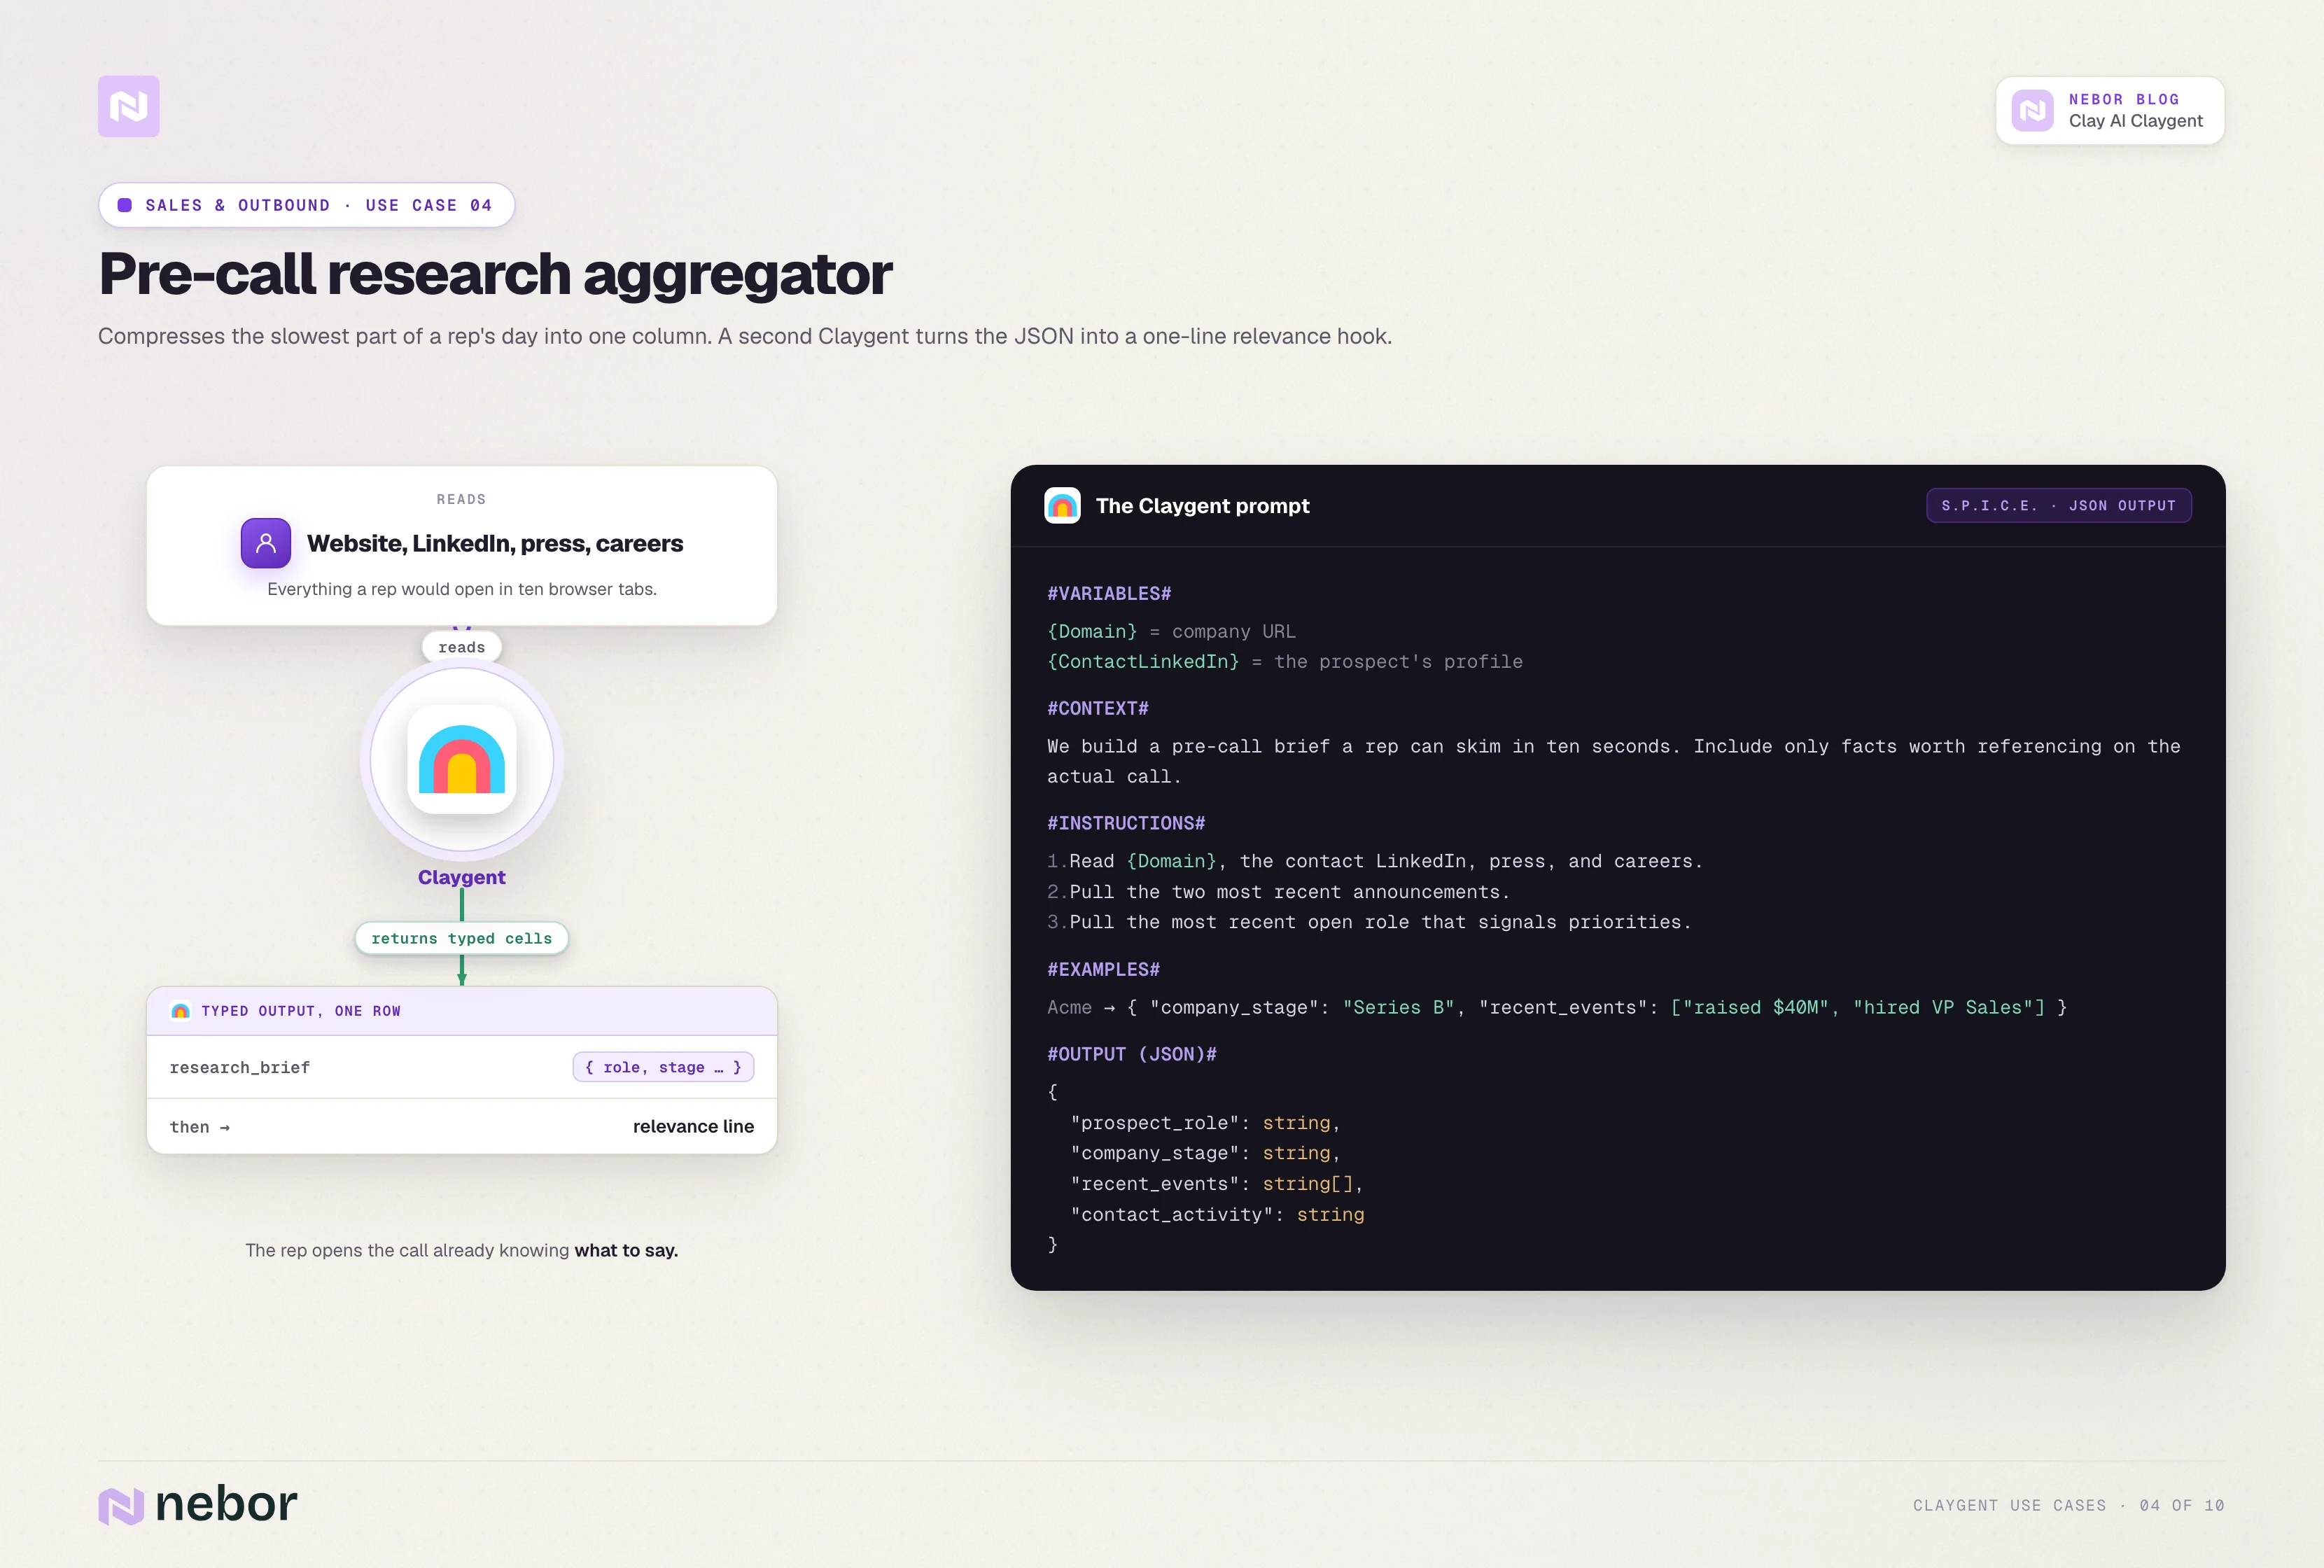
Het traagste deel van de dag van elke rep is het onderzoek voor elke call. Claygent perst dat werk samen in één kolom die een gestructureerde briefing teruggeeft.
Een Claygent die research bundelt, leest de website van het bedrijf, het LinkedIn-profiel van het contact, de recente persberichten van het bedrijf en de vacaturepagina.
Hij geeft een JSON-blok terug met de rol van de prospect, de fase van het bedrijf, twee of drie recente gebeurtenissen om naar te verwijzen en, als dat er is, het patroon van publieke activiteit van het contact.
Een tweede Claygent leest die JSON en schrijft een relevante openingszin van één regel die de rep in de e-mail of de opening van de call kan gebruiken.
Bij die tweede Claygent verdienen GPT-5.5 of Claude Opus 4.7 hun plek, omdat het werk bestaat uit redeneren over data die we al hebben en er geen nieuwe data gezocht hoeft te worden.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {Domain} en lees de homepage, de About-pagina en recente blogpagina's.
2. Ga naar {LinkedInURL} van het contact en haal de headline, recente activiteit en eventuele vastgezette posts op.
3. Haal de twee meest recente aankondigingen op van de persberichtenpagina van {Domain}.
4. Haal de meest recente vacature van de vacaturepagina op die laat zien wat nu prioriteit heeft voor het team.
#OUTPUT#
research_brief (JSON met prospect_role, company_stage, recent_events en contact_activity)
3 Clay AI Claygent-use cases voor RevOps en CRM-beheer
RevOps-teams denken vaak dat Claygent iets is voor het salesteam in Clay. De patronen hieronder laten zien waarom dat beeld onvolledig is.
CRM-data op schaal opschonen en normaliseren
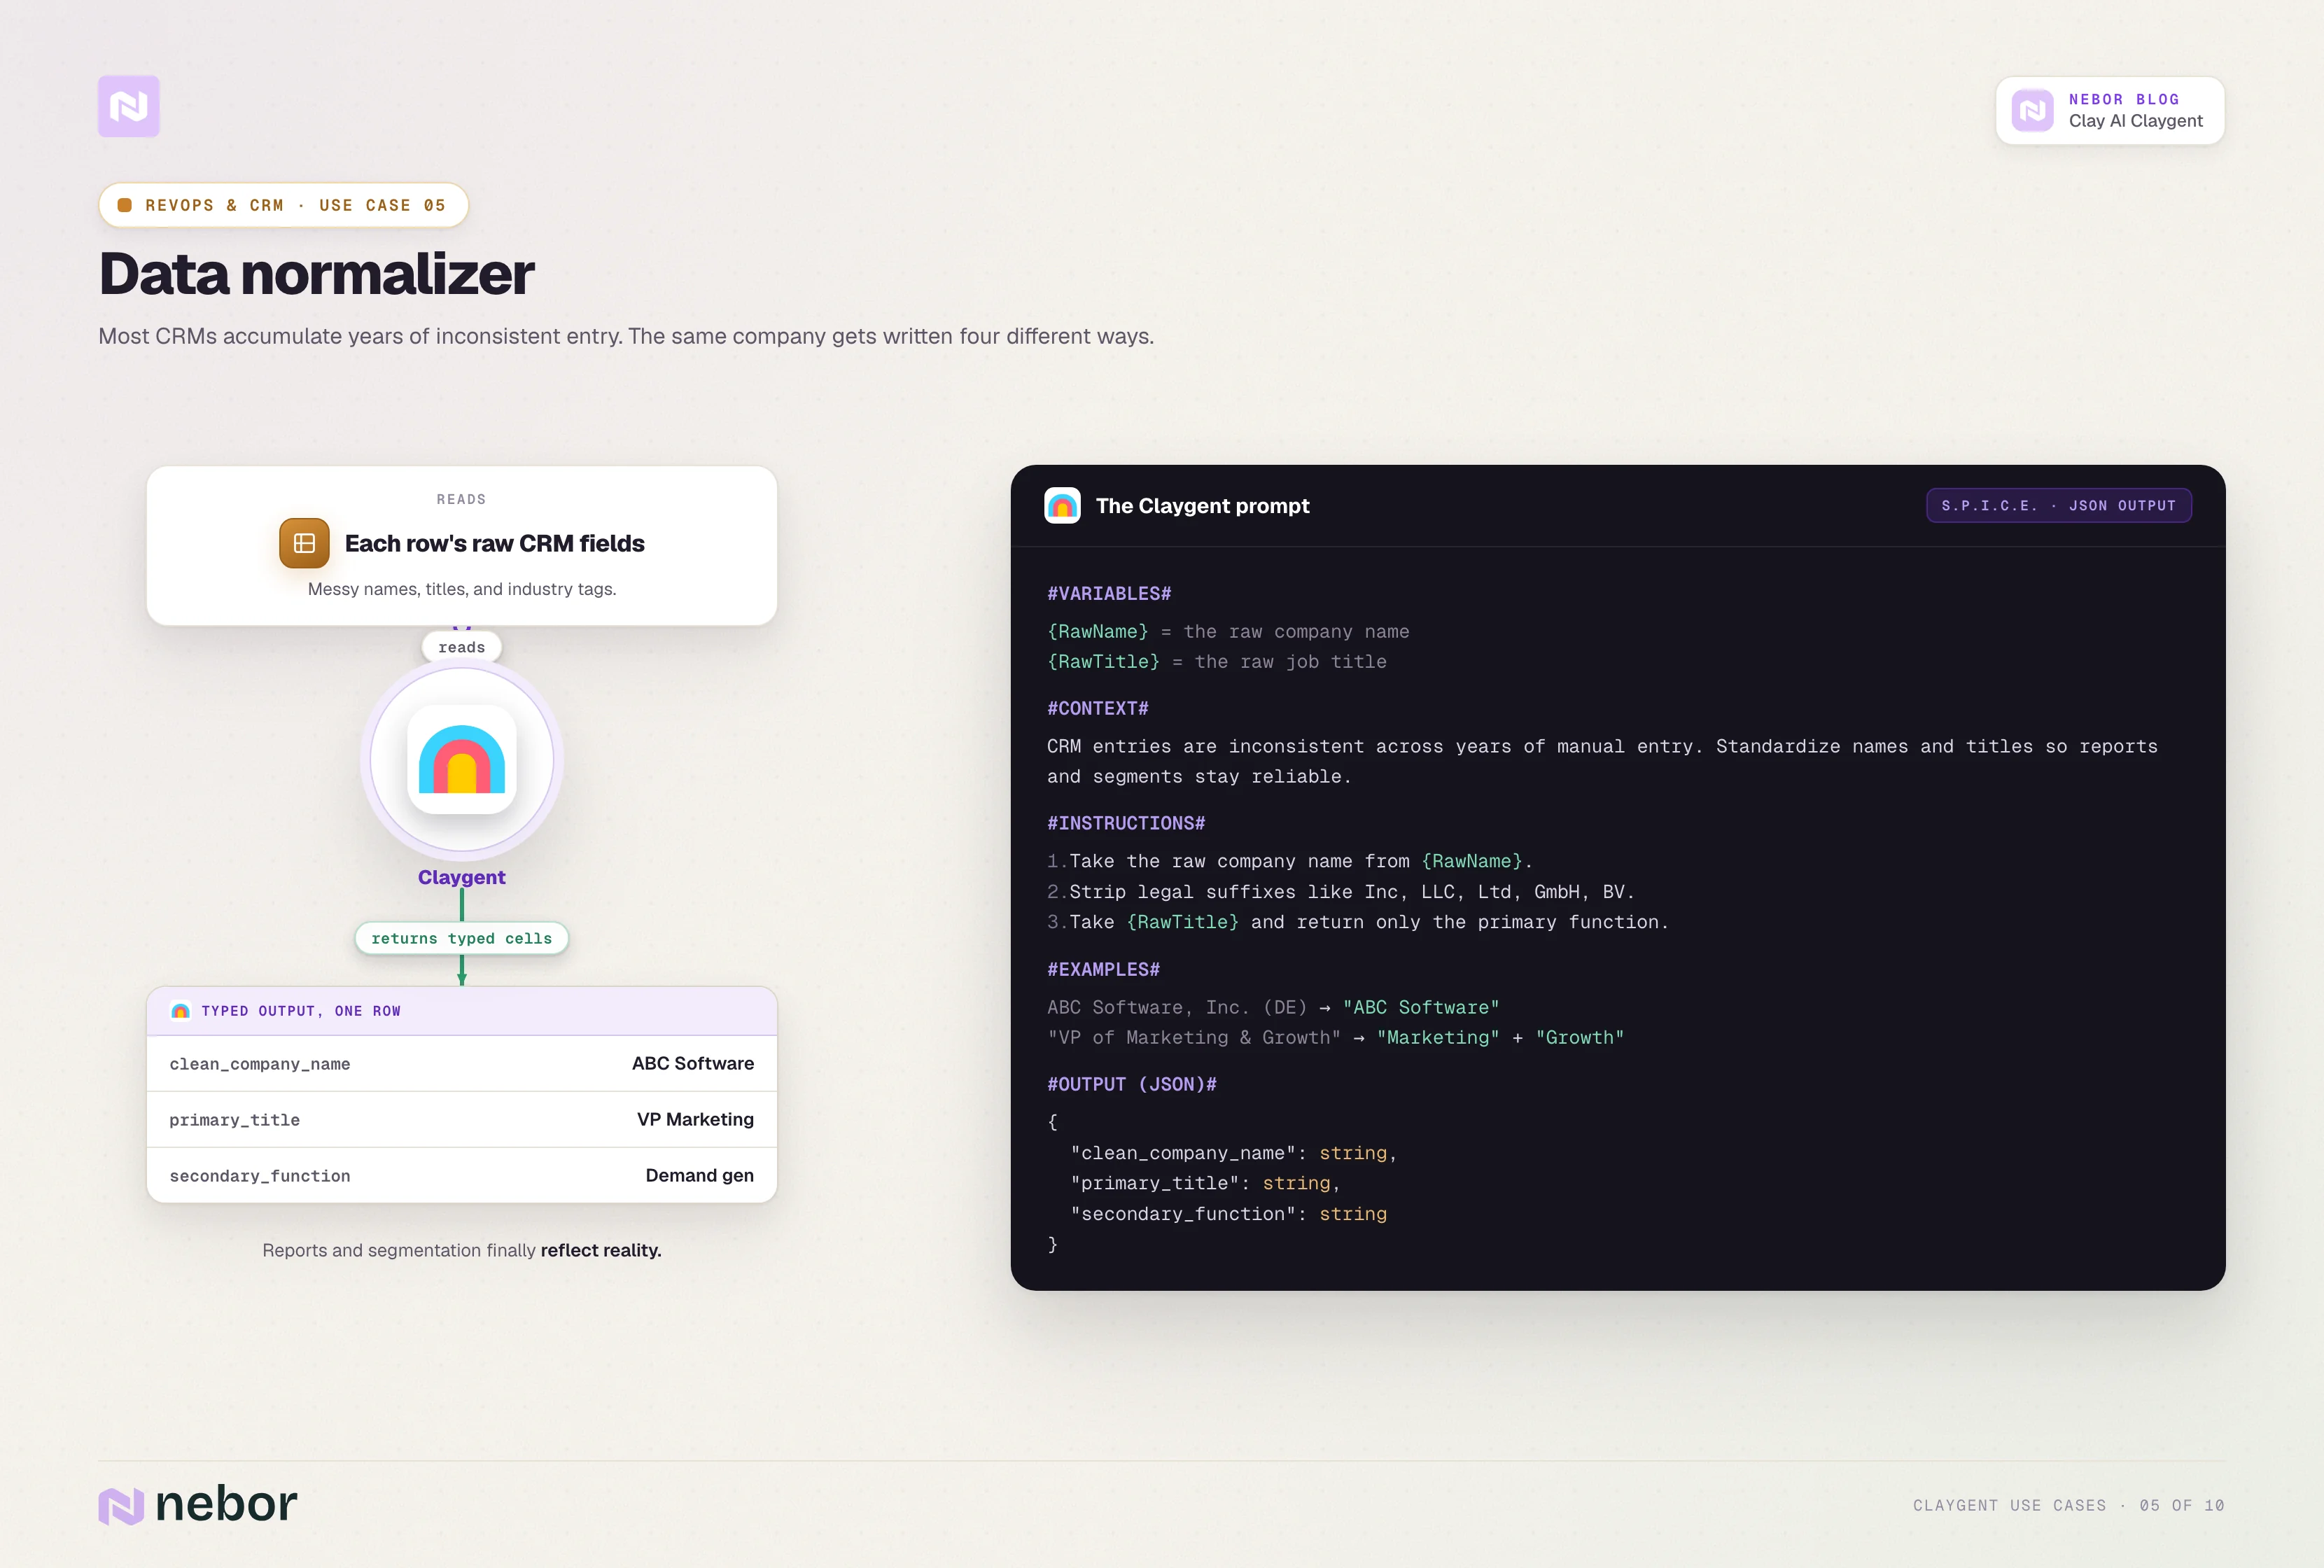
In de meeste CRM's stapelt zich jarenlang inconsistent ingevoerde data op. Reps schrijven dezelfde bedrijfsnaam op vier verschillende manieren.
Ze vullen functietitels in op basis van wat er in de e-mailhandtekening van de prospect staat, en ze kiezen de branche uit het dropdownmenu dat het dichtst in de buurt komt van hun gok.
Een normalisatie-Claygent leest het ruwe invoerveld van elke rij en geeft de opgeschoonde, gestandaardiseerde versie terug.
Een ruwe invoer als ABC Software, Inc. (DE) wordt bijvoorbeeld ABC Software, en een titel als VP of Marketing & Growth wordt VP of Marketing, met growth apart getagd. De output is een schone kolom waarmee het CRM kan synchroniseren.
Meestal is dit een eenmalige batchklus, maar de workflow kan ook doorlopend op nieuwe records draaien, zodat de dataset schoon blijft terwijl hij groeit. Over het Clay-naar-CRM-patroon hebben we elders uitgebreider geschreven.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Neem de ruwe bedrijfsnaam uit {RawName}.
2. Haal rechtsvormen weg zoals Inc, LLC, Ltd, GmbH, BV.
3. Verwijder regiocodes tussen haakjes.
4. Neem de ruwe functietitel uit {RawTitle} en geef alleen de primaire functie terug, met eventuele secundaire functies apart getagd.
#OUTPUT#
clean_company_name (text)
primary_title (text)
secondary_function (text, mag leeg zijn)
Accounts scoren op eigen criteria die het CRM niet kan berekenen
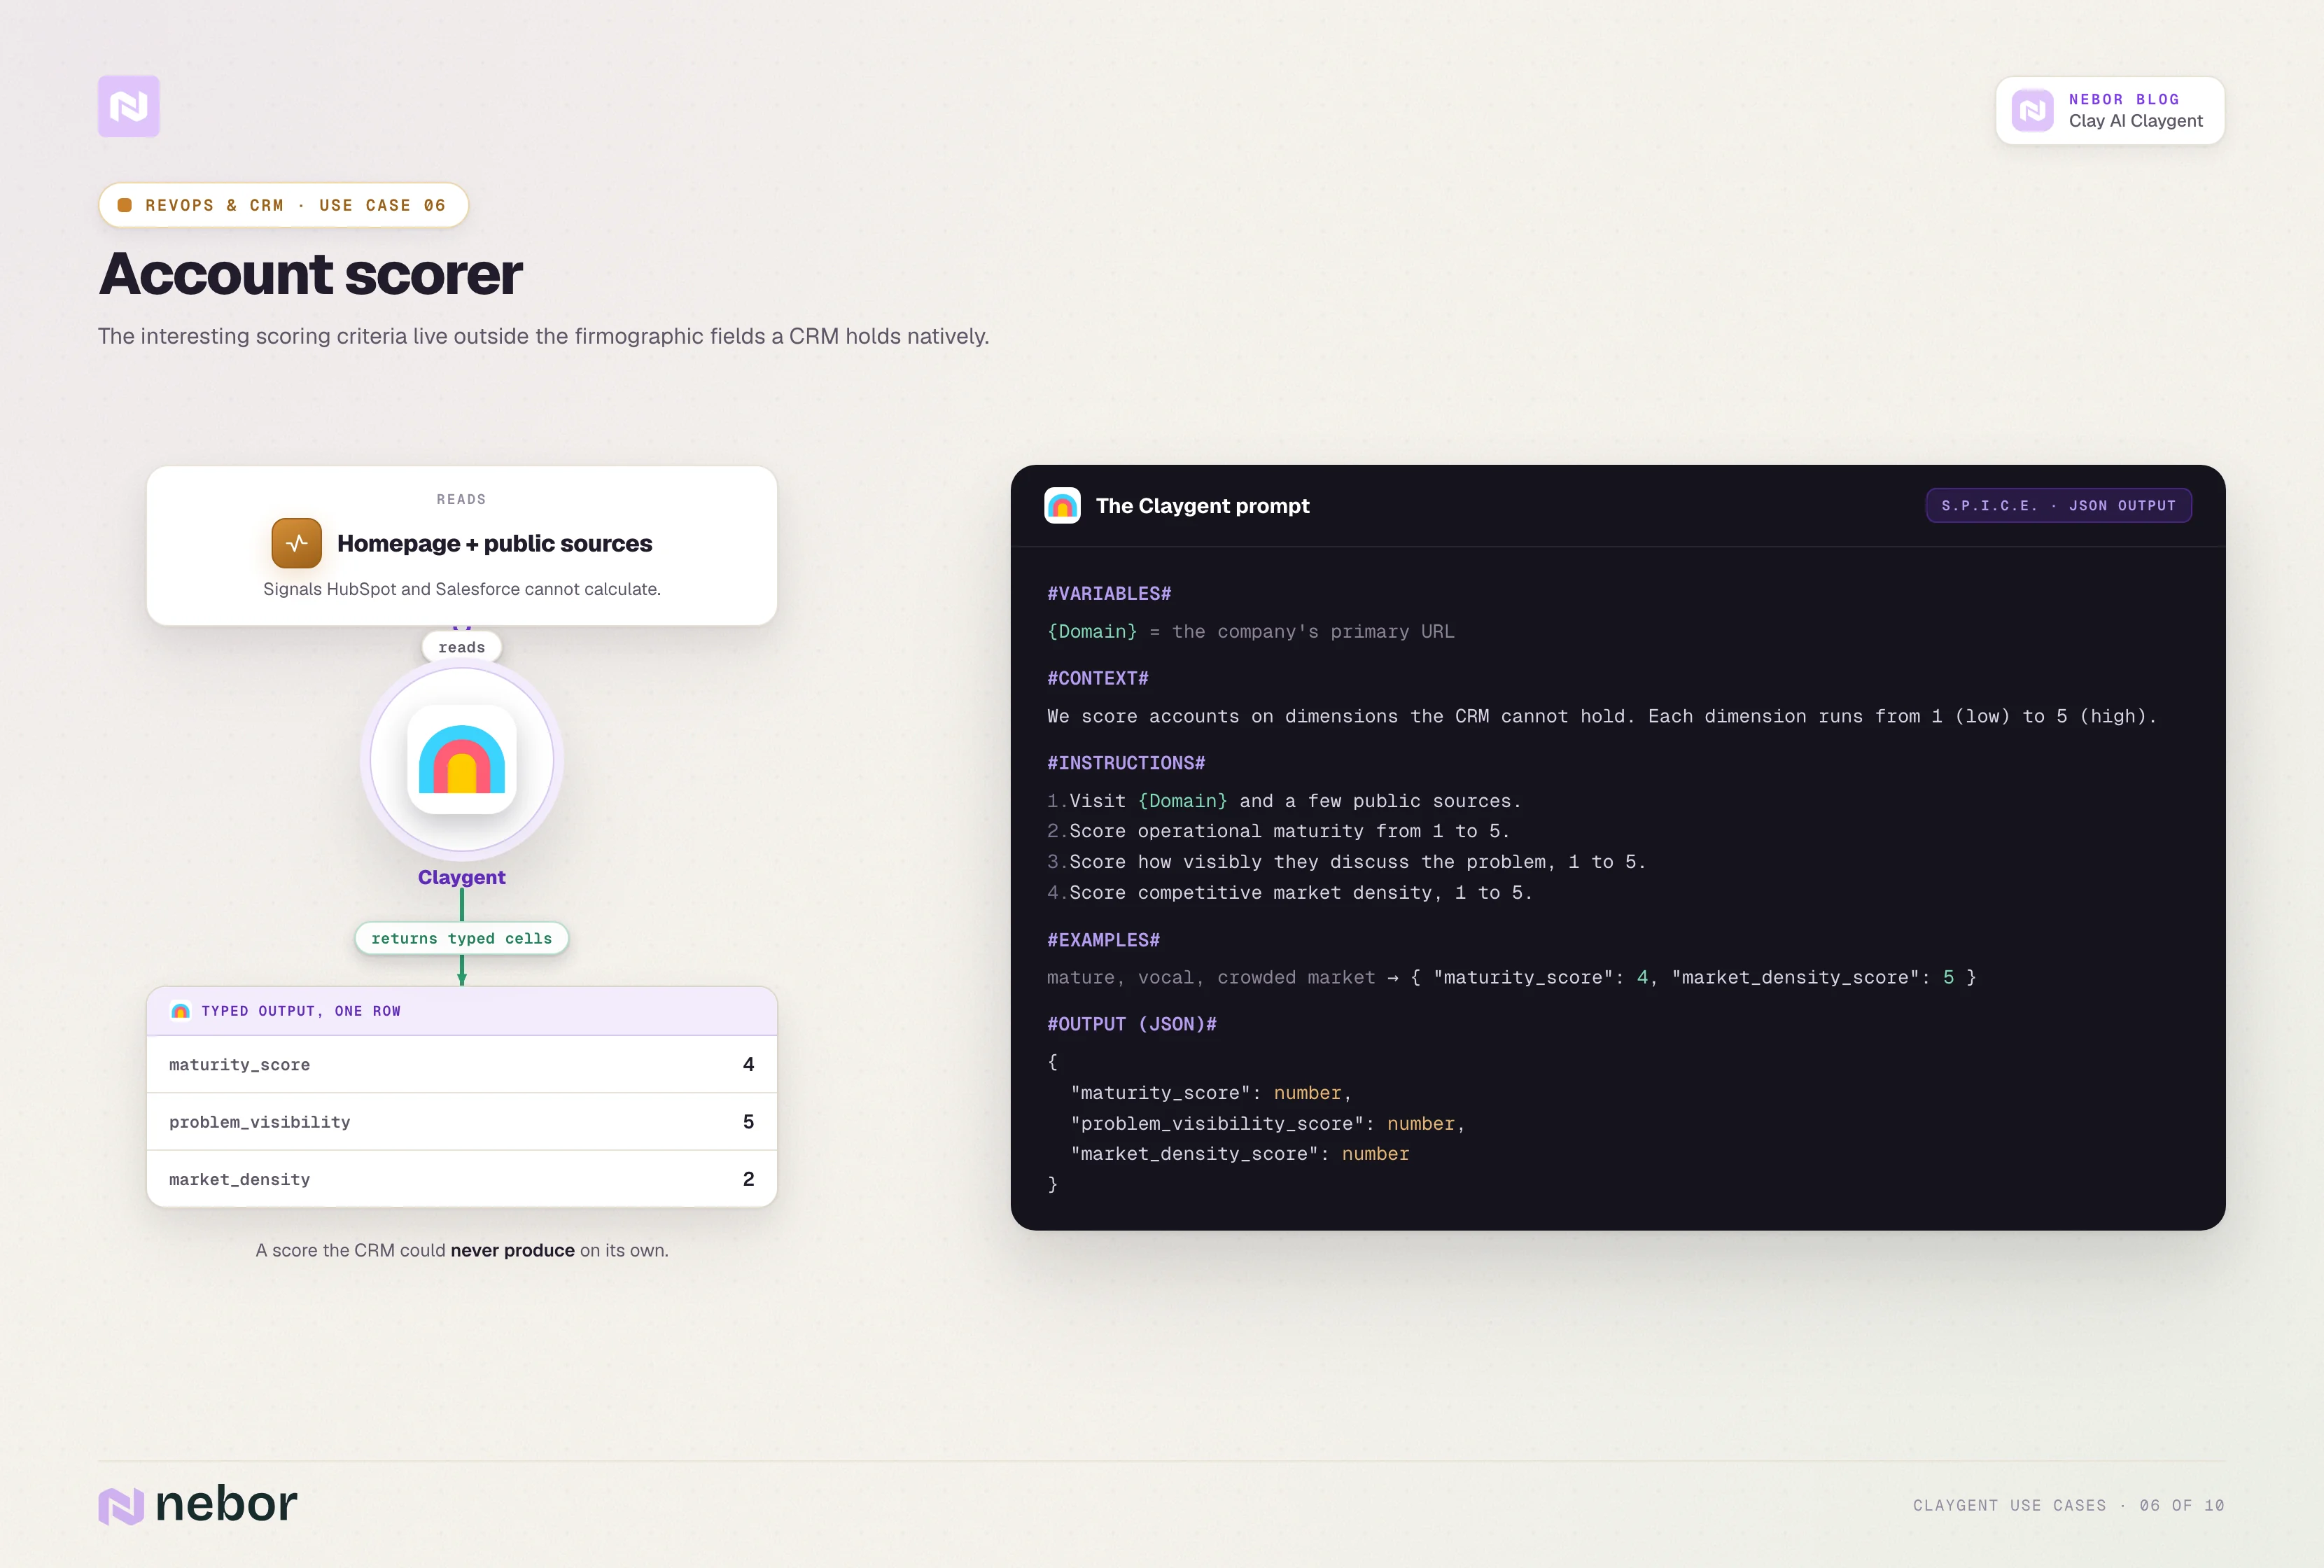
Accountscoring in HubSpot of Salesforce houdt meestal op bij de firmografische velden die het CRM zelf heeft: aantal medewerkers, branche, omzetklasse en regio. De interessante scoringscriteria liggen buiten die velden.
Een scoring-Claygent leest de homepage van het bedrijf en een paar openbare bronnen en geeft daarna een numerieke score terug op twee of drie eigen dimensies.
Veelgebruikte dimensies zijn operationele volwassenheid op een schaal van 1 tot 5, hoe zichtbaar het bedrijf praat over het probleem dat wij oplossen en hoe druk de markt met concurrenten is.
De outputkolommen gaan naar de scoringlaag van het CRM, zodat RevOps kwalificatielogica kan bouwen die verder gaat dan firmografie.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {Domain} en lees de homepage, de About-pagina en de productpagina's.
2. Scoor de operationele volwassenheid van 1 tot 5, waarbij 1 een bootstrap-fase is en 5 enterprise.
3. Scoor van 1 tot 5 hoe zichtbaar het bedrijf praat over het probleem dat wij oplossen.
4. Scoor van 1 tot 5 hoe druk de markt met concurrenten van het bedrijf is.
#OUTPUT#
maturity_score (number)
problem_visibility_score (number)
market_density_score (number)
Leads aan accounts koppelen in rommelige data
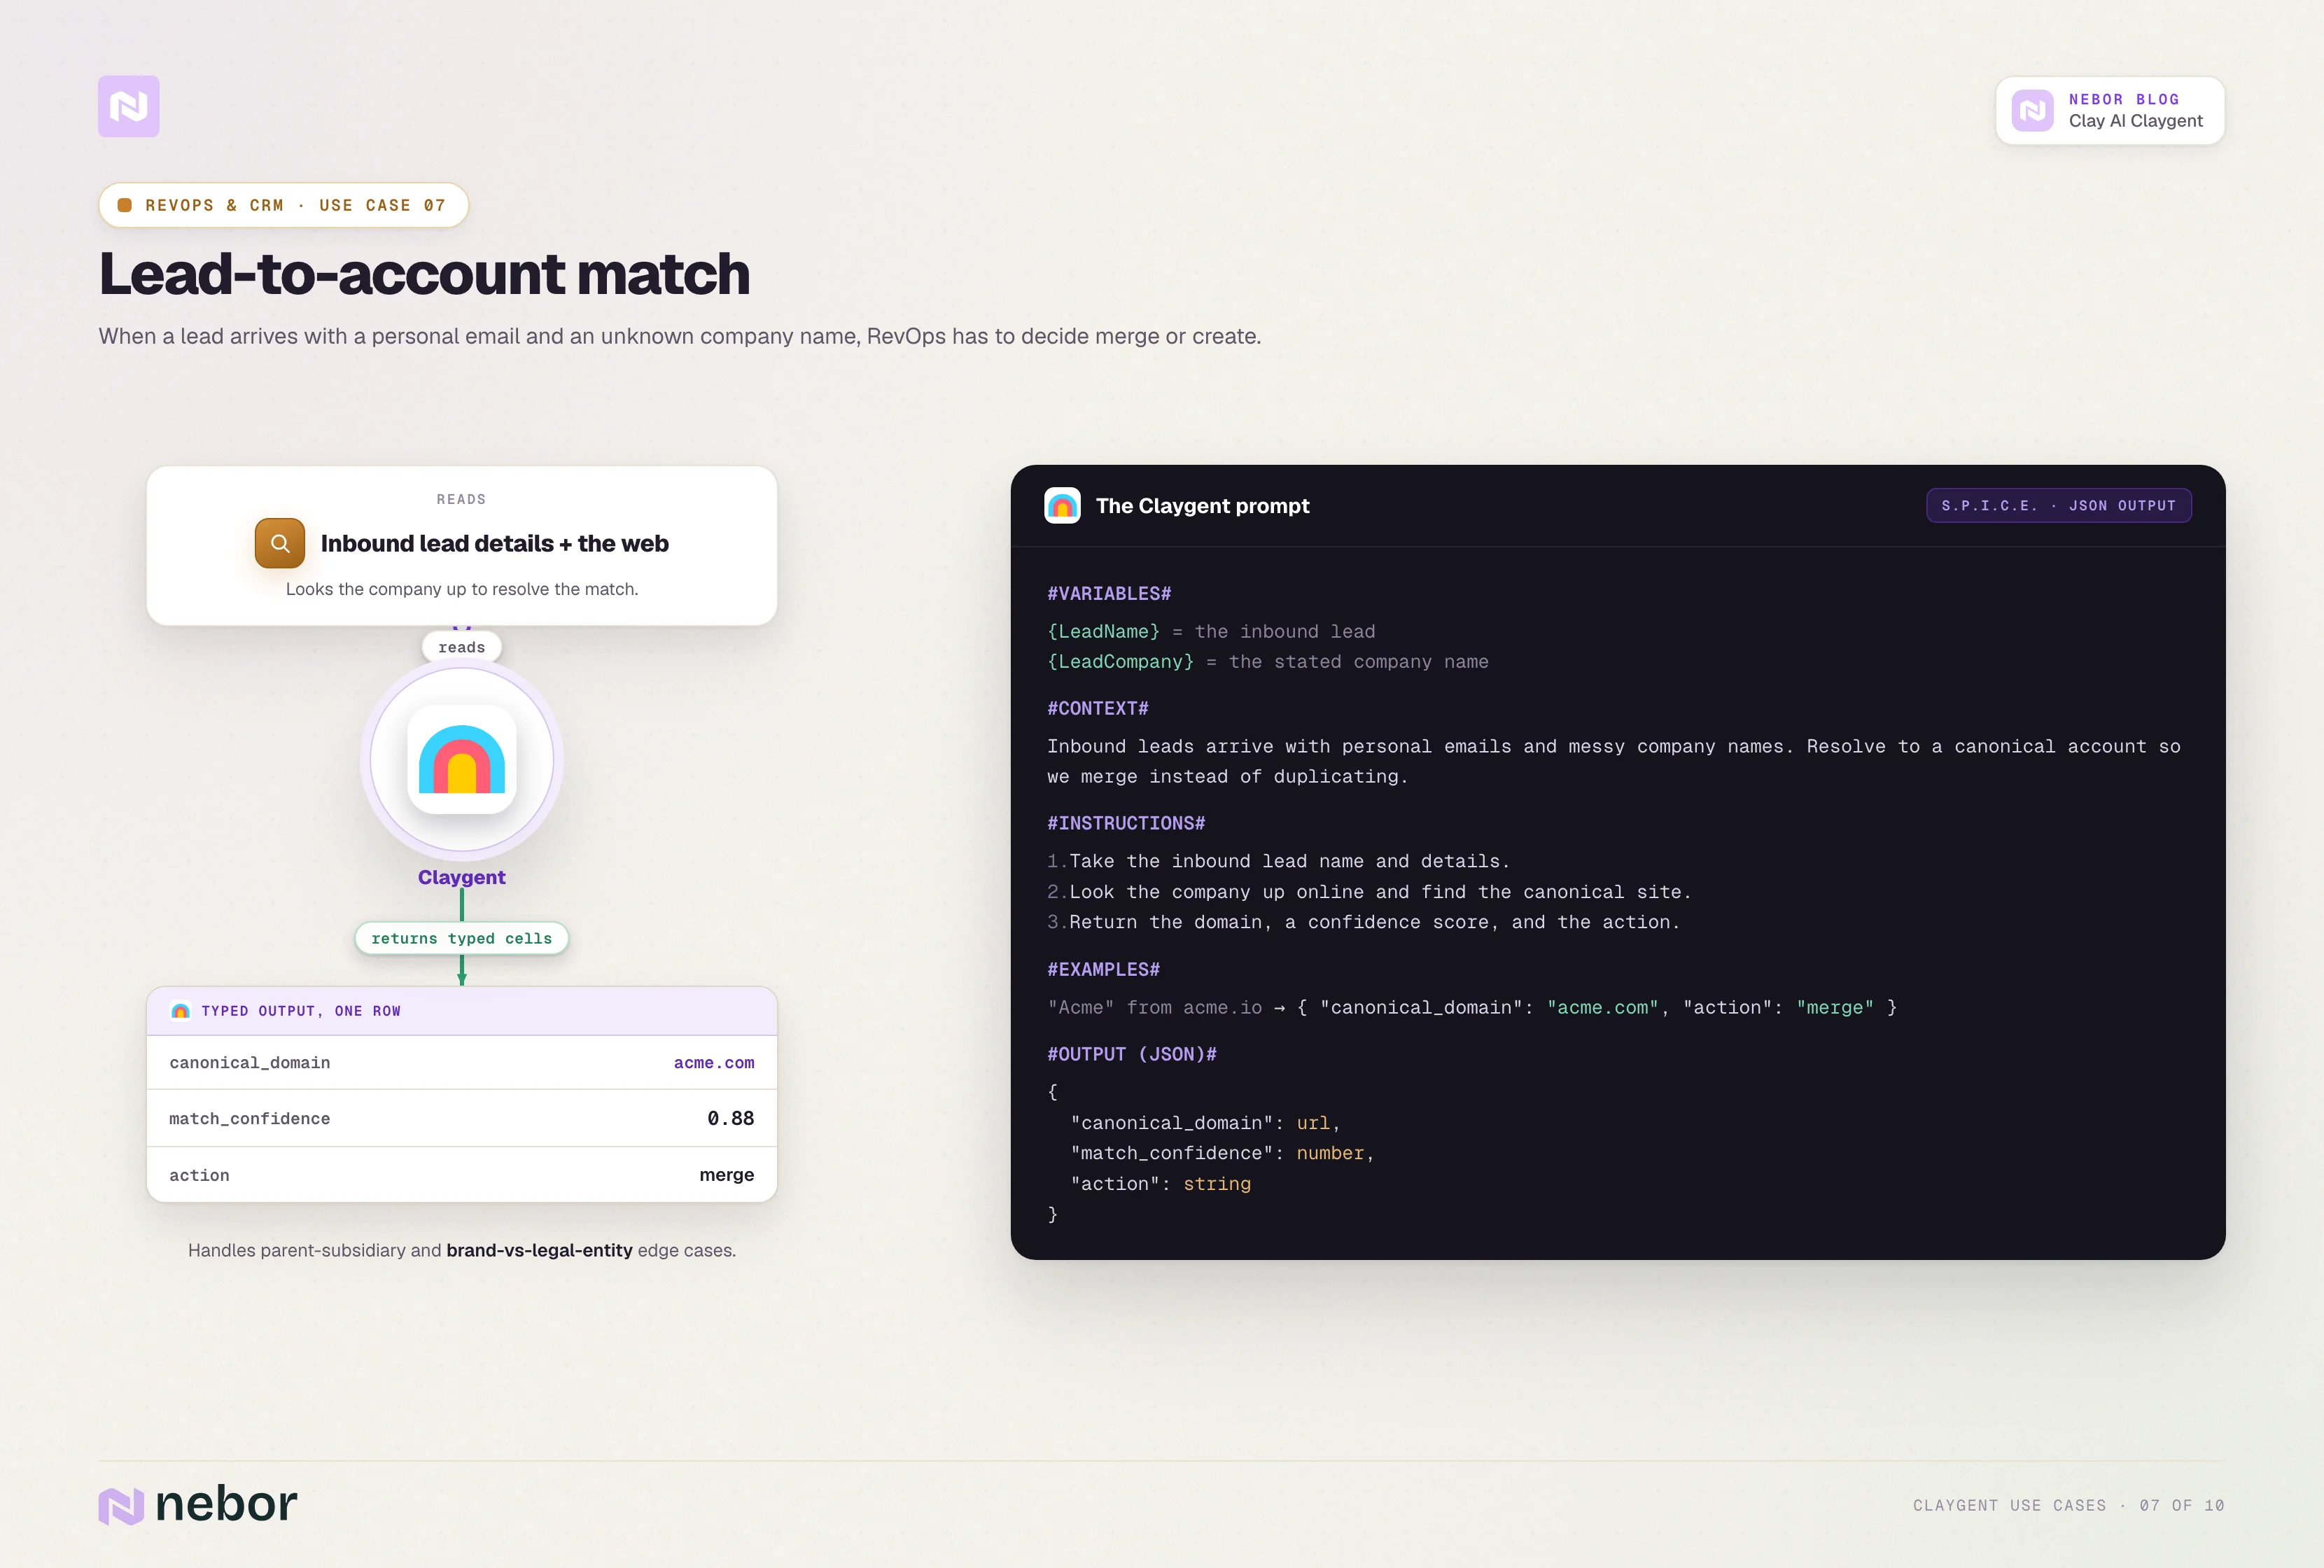
Komt er een lead binnen met een persoonlijk e-mailadres en een bedrijfsnaam die het CRM nog nooit heeft gezien, dan moet RevOps beslissen of die lead bij een bestaand account hoort of een nieuw account wordt.
Een koppelings-Claygent neemt de naam en inbound-gegevens van de lead, zoekt het bedrijf online op en geeft de canonieke bedrijfswebsite en een zekerheidsscore terug.
Logica verderop in de workflow bepaalt op basis van de zekerheidsscore en een lijst met bestaande accountdomeinen of de lead wordt samengevoegd met een bestaand account of een nieuw account krijgt.
Dezelfde Claygent kan overweg met moeder- en dochterbedrijven, verschillen tussen merknaam en juridische entiteit en de rommelige randgevallen waar alleen een CRM-lookup zou falen.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Neem de inbound-gegevens uit {LeadName}, {LeadEmail} en {LeadCompanyText}.
2. Bepaal welke canonieke bedrijfswebsite het best past bij de inbound-gegevens.
3. Controleer dit tegen de bedrijfsnaam en, als dat beschikbaar is, het domein van het persoonlijke e-mailadres.
4. Geef het canonieke domein en een zekerheidsscore terug.
#OUTPUT#
canonical_domain (URL)
confidence (number, 1-5)
match_notes (text)
2 Clay AI Claygent-use cases voor marketing en demand generation
Marketingteams gebruiken Claygent minder dan salesteams, vooral omdat de use cases minder voor de hand liggen. Op de twee hieronder zien we klanten steeds terugkomen.
ABM-lijsten bouwen uit niet-traditionele bronnen
ABM-lijsten beginnen meestal met hetzelfde Apollo-filter als outboundlijsten, en erven daardoor dezelfde blinde vlekken. Een ABM-lijst die je met Claygent bouwt, kan putten uit plekken die Apollo niet ziet.
Een marketing-Claygent kan een targetlijst bouwen uit de gastenhistorie van podcasts, sprekerslineups van congressen, shortlists van awards, recente investeringsaankondigingen of pagina's met auteurs van vakbladen.
De output is een getypeerde lijst van bedrijven en contacten waarop het ABM-platform kan targeten met ads, content en direct mail.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {SourceURL}. Dat is een gastenhistorie van een podcast, een sprekerslijst van een congres, een shortlist van een award of een andere ongestructureerde lijst.
2. Haal elk bedrijf op dat met naam op de pagina staat.
3. Geef voor elk bedrijf de bedrijfsnaam, het canonieke domein en het type bron waarin het opdook terug.
#OUTPUT#
companies (JSON-lijst met objecten met name, domain, source_type)
Evenementen onderzoeken waar je ICP opduikt als bezoeker, spreker of sponsor
De meeste marketingteams kiezen de evenementen die ze bezoeken of sponsoren op gevoel, op de facturen van vorig jaar of op een ingeving van een sales rep. Een Claygent kan dat gokwerk vervangen door een gerangschikte lijst van evenementen op basis van waar je kopers echt zijn.
De Claygent voor evenementenonderzoek bezoekt de website van elk evenement, haalt de sprekerslijst, de sponsorlijst en een eventuele zichtbare exposantenlijst op en checkt welke namen passen bij het koperprofiel. De output is het aantal passende kopers per evenement en een lijst van wie waar opduikt.
Een B2B-bedrijf dat verkoopt aan heads of RevOps kan bijvoorbeeld twintig vakcongressen invoeren en een gerangschikte lijst terugkrijgen van de congressen waar in de laatste twee edities de meeste VP's en Directors of RevOps spraken, sponsorden of zichtbaar aanwezig waren.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar {EventWebsite}.
2. Haal de sprekerslijst, de sponsorlijst en, als die zichtbaar is, de exposantenlijst op.
3. Check voor elke genoemde naam of de functietitel of de branche van het bedrijf past bij ons koperprofiel.
4. Geef het aantal gevonden passende kopers terug en een lijst van de bedrijven die opduiken.
#OUTPUT#
buyer_match_count (number)
matching_companies (JSON-lijst)
event_score (number, 1-5 voor relevantie voor ons ICP)
Clay AI Claygent-use cases voor customer success en expansion
Customer success heeft in aantal de minste use cases, maar wel de use cases die per gebouwde Claygent het meest opleveren.
Churnsignalen herkennen in openbare bronnen
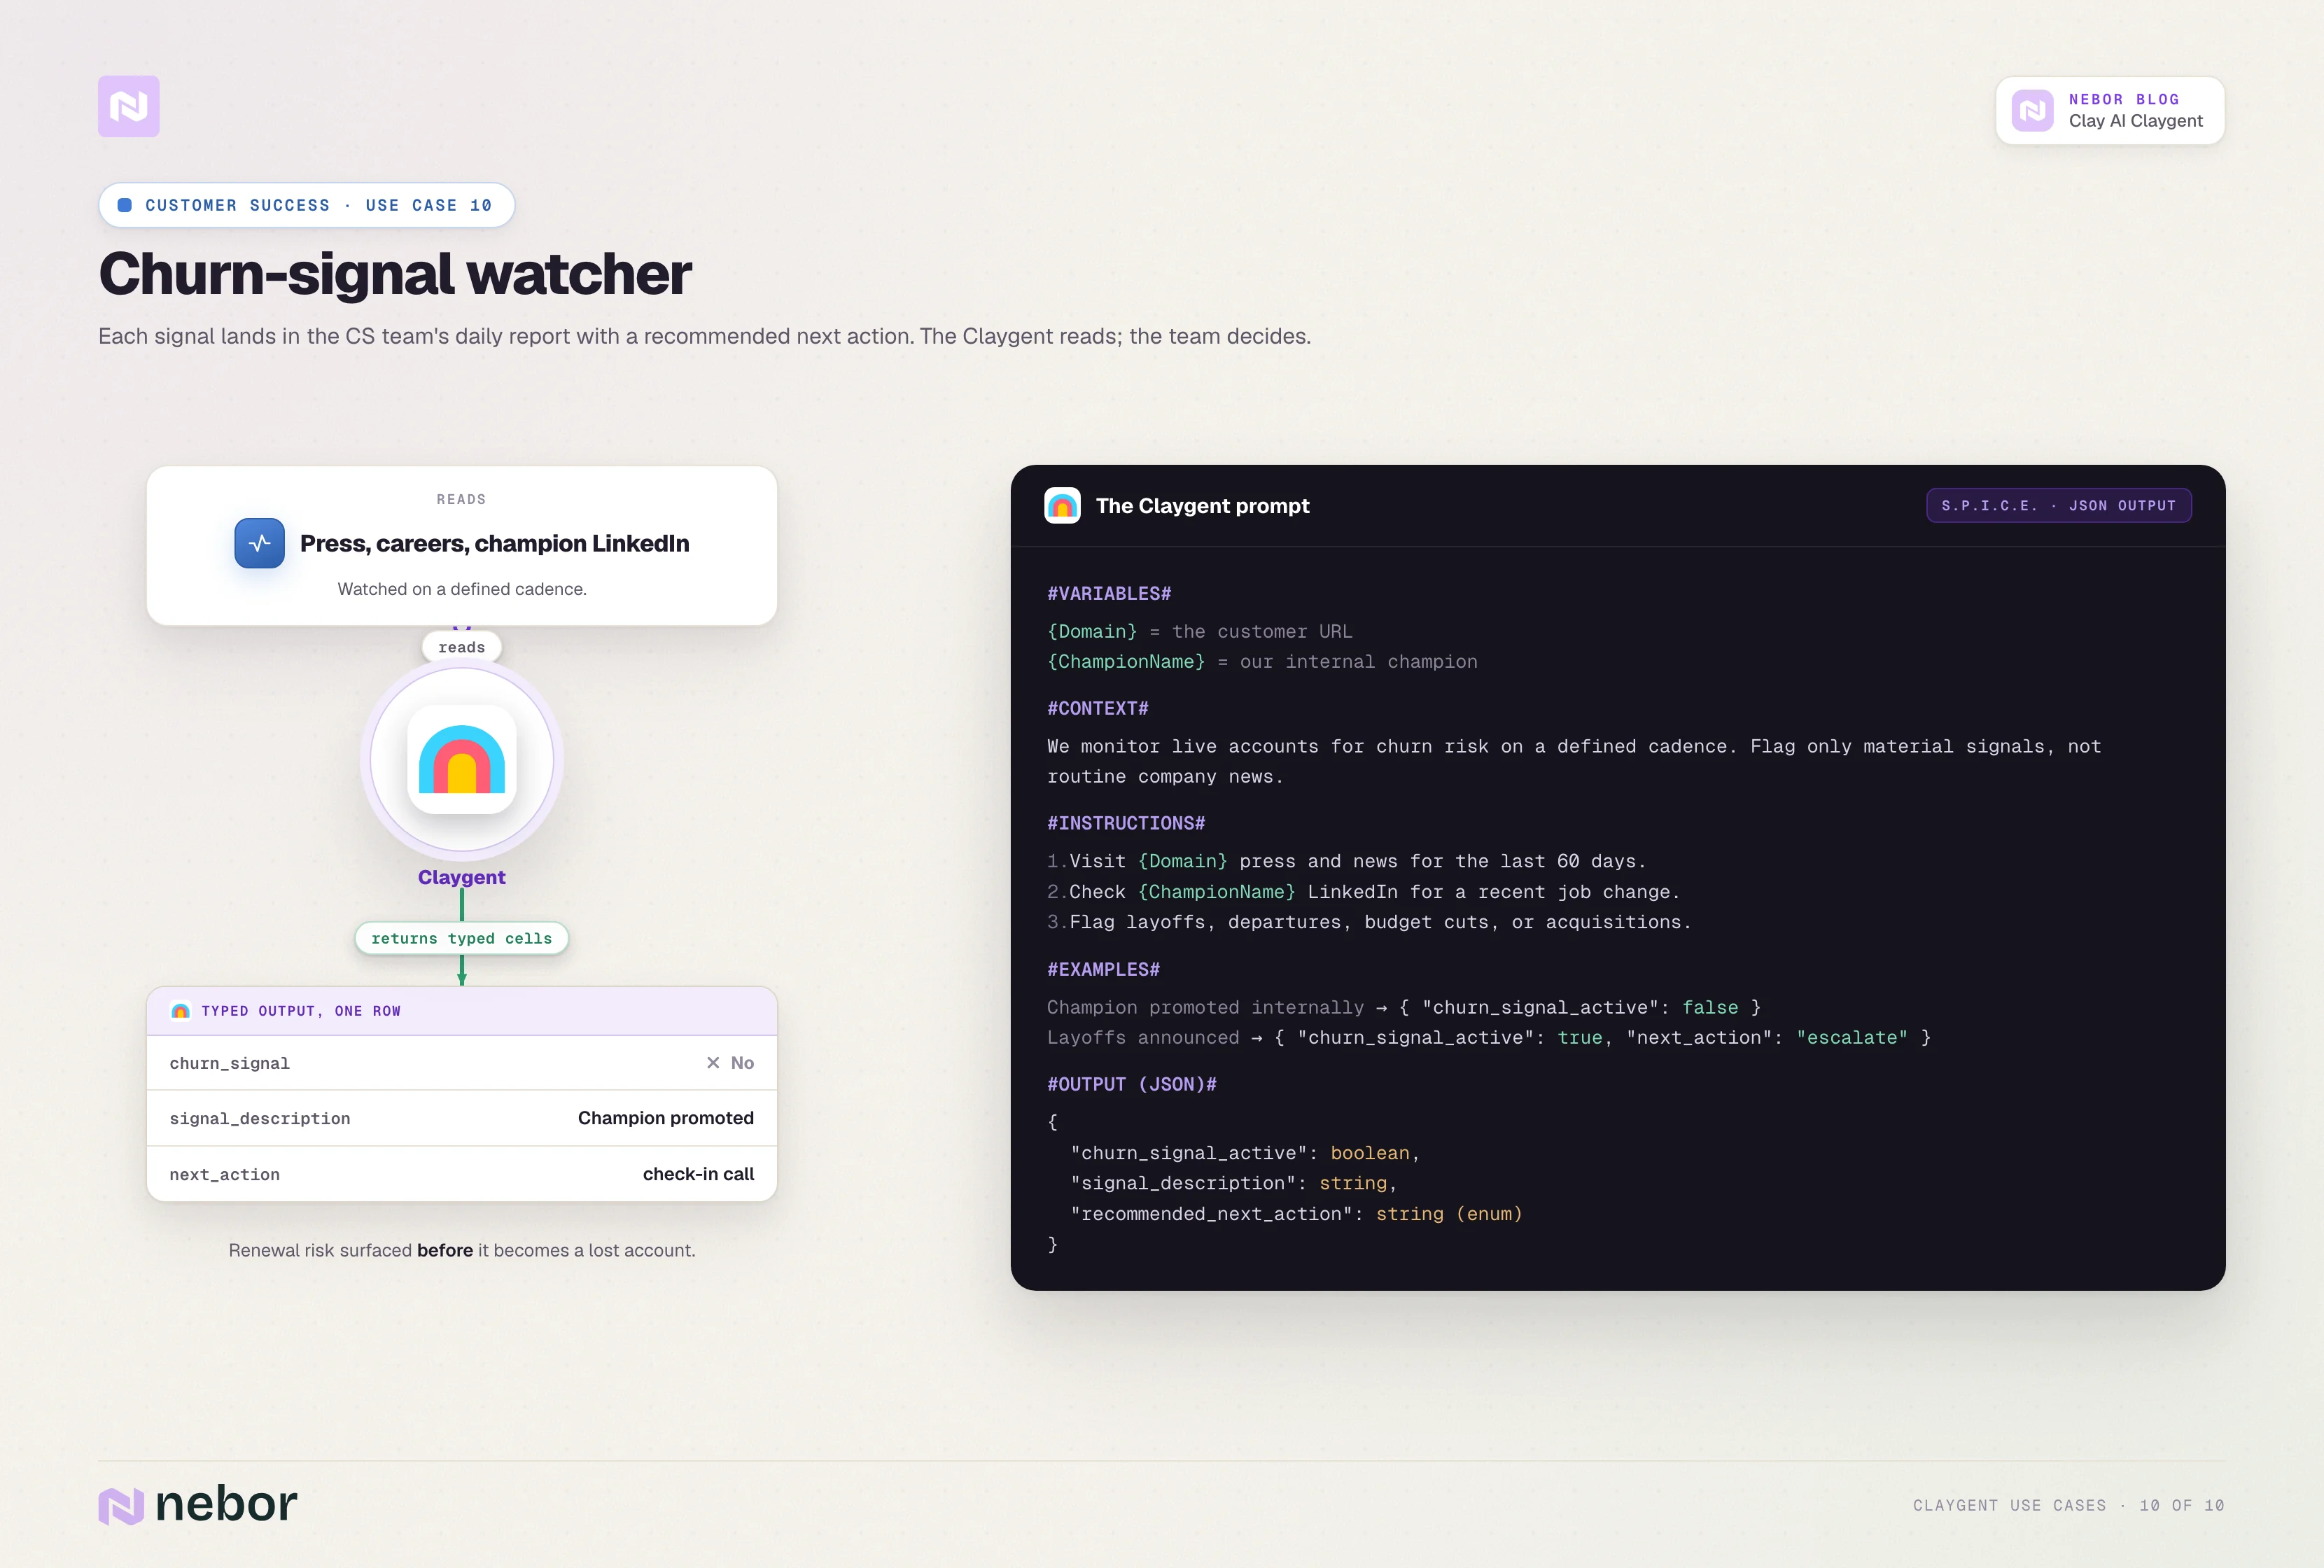
Een churnwatcher-Claygent leest met een vast ritme de persberichtenpagina, de vacaturepagina en de LinkedIn-accounts van belangrijke executives van elke actieve klant. Hij signaleert zaken als ontslagrondes, vertrekkende executives in de functie van je champion, publieke bezuinigingen of aangekondigde overnames.
Elk signaal komt met een aanbevolen volgende actie in het dagrapport van het CS-team. Dat kan een check-in call zijn, een escalatie naar het renewalteam of een rustige tag om twee weken alleen te monitoren. De Claygent doet het leeswerk en het CS-team neemt de beslissing.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar de persberichtenpagina van {Domain} en de nieuwsresultaten van de afgelopen 60 dagen.
2. Ga naar de vacaturepagina van {Domain} en tel de openstaande vacatures.
3. Bekijk het LinkedIn-profiel van {ChampionName} en zoek naar een recente baanwissel.
4. Signaleer aangekondigde ontslagrondes, vertrekkende executives in de functie van de champion, publieke bezuinigingen of overnamenieuws.
#OUTPUT#
churn_signal_active (true/false)
signal_description (text)
recommended_next_action (text, kies uit check-in call, renewal escalation of monitor only)
Expansion-kansen op het juiste moment boven water halen
Dit is het omgekeerde van de churnwatcher. Een expansion-Claygent leest de productlanceringen van de klant, de wervingsactiviteit in aangrenzende teams en aankondigingen van nieuwe initiatieven. Hij signaleert accounts waar het bedrijf binnenkort meer nodig heeft van wat jij verkoopt.
Een expansion-Claygent kan bijvoorbeeld elke bestaande klant signaleren die een nieuwe VP of Marketing of Demand Gen aanneemt. Nieuwe leiders gooien hun toolstack bijna altijd om in hun eerste 90 dagen, en een goed getimed gesprek in week twee is veel meer waard dan tien pogingen tot cold outreach in maand zes.
Zo ziet een representatieve prompt eruit.
#INSTRUCTIONS#
1. Ga naar de persberichtenpagina en de pagina met product- of featureaankondigingen van {Domain}.
2. Ga naar de vacaturepagina van {Domain} en zoek naar nieuwe functies in teams naast de teams waaraan we nu verkopen.
3. Bekijk de pagina van het leiderschapsteam op nieuwe aanwervingen in de afgelopen 60 dagen.
4. Signaleer elk signaal dat erop wijst dat de klant binnenkort meer nodig heeft van wat wij verkopen.
#OUTPUT#
expansion_signal_active (true/false)
signal_description (text)
suggested_play (text)
Het patroon waardoor dit allemaal werkt
Elke use case hierboven heeft dezelfde basisvorm. Bepaal een vraag die op schaal beantwoord moet worden, richt een Claygent op de bron waar het antwoord echt staat en geef het antwoord terug als getypeerde output waar de volgende stap iets mee kan.
De functies veranderen, de vorm blijft hetzelfde.
Zo maak je van je Clay-tabellen workflows door Claygents aan elkaar te koppelen
Eén losse Claygent is gewoon een kolom. Koppel je Claygents aan elkaar, dan krijg je een werkende workflow.
De omslag komt als de output van de ene Claygent de input van de volgende wordt, en de keten een rij oplevert waar de volgende stap in de workflow iets mee kan.
Het team van Claygents uit de vorige sectie doet op zichzelf niets nuttigs. Het gaat pas echt werken als de Claygents in de juiste volgorde met elkaar praten.
In de meeste outbound-workflows die we bouwen, koppelen we vier of vijf Claygents aan elkaar. De keten lijkt bij verschillende klanten op elkaar, omdat de onderliggende logica op elkaar lijkt.
De standaardvorm van de keten
Stap één is de bronlijst bovenaan de tabel.
De tabel begint met een verse batch rijen van ergens anders, of dat nu een Apollo-zoekopdracht is, een directory-scrape via Claygent, een extractie van partnerpagina's of een upload van de bestaande TAM van de klant. Elke rij heeft minstens een naam en een domein.
Stap twee is de ICP-kwalificatie die we in de vorige sectie bespraken. We zetten die als eerste en stellen hem zo in dat een rij bij twijfel wordt tegengehouden (fail closed). Elke rij die niet door de kwalificatie komt, valt uit de workflow en kost geen credits meer.
Stap drie is de triggerwatcher, die over de gekwalificeerde rijen loopt. Hij geeft elke rij een prioriteitssignaal.
Rijen met een verse trigger binnen de tijdsperiode schuiven naar voren in de prioriteitswachtrij. Rijen zonder actuele trigger wachten in een wachtrij die wekelijks wordt gecheckt, zonder verdere enrichment te starten.
Stap vier is de buying-committee-mapper samen met de relevantieschrijver, die tegelijk draaien. Ze hangen allebei af van de kwalificatie en de triggerwatcher, maar niet van elkaar. Daardoor kunnen ze tegelijk draaien en halveren ze de tijd tot de outreach.
Stap vijf is de signaalrouter die de keten afsluit. Hij leest de output van de vorige Claygents en beslist wat er met de rij gebeurt.
Een gekwalificeerde rij met een verse trigger en een sterke relevantieregel stuurt de router direct naar de SDR voor persoonlijke outreach. Gekwalificeerde rijen zonder actuele trigger wachten in de wachtrij op het volgende signaal, en rijen die een eerdere check niet haalden, vallen uit de keten met de reden erbij gelogd.
Voorwaardelijke logica en fallbacks
Fallbacks maken de keten betrouwbaar op de rijen waar een Claygent niets bruikbaars te melden heeft.
Geeft de relevantieschrijver een algemene regel terug, dan valt de keten terug op een handmatig samengesteld template dat bij het type trigger hoort. Vindt de buying-committee-mapper geen enkel contact, dan loopt de keten via LinkedIn Sales Navigator met de people-find-integratie van Clay. Een rij waarvoor de kwalificatie een dubbelzinnig antwoord geeft, gaat naar een menselijke reviewer in plaats van door de keten.
Zo kan de keten slechte rijen via een andere route redden of ze doorzetten naar een wachtrij voor menselijke controle.
Wat wanneer gebeurt
De volgorde is net zo belangrijk als wat elke Claygent doet.
De kwalificatie en de buying-committee-mapper draaien op aanvraag zodra er nieuwe rijen binnenkomen. De triggerwatcher checkt elke week de gekwalificeerde TAM.
De relevantieschrijver komt pas in actie als er een verse trigger verschijnt, en de router luistert continu naar elke rij die net de keten heeft doorlopen.
Door werk op aanvraag te mengen met gepland werk voelt de keten levend aan in plaats van batchgestuurd. Triggers die dinsdagochtend binnenkwamen, staan dinsdagmiddag al in de outbound-wachtrij, en niet pas volgende maandag.
Waar Clay ophoudt en API's of n8n-webhooks het overnemen
Het meeste regelwerk gebeurt in Clay zelf. De overdracht aan externe tools (het outboundplatform, het CRM, de tool voor LinkedIn-automatisering) loopt via API's of n8n in plaats van via de eigen integraties van Clay.
We kiezen standaard voor API-koppelingen, om twee redenen. De eerste is kosten, want de eigen integraties van Clay rekenen Clay-credits bovenop het abonnement van de tool zelf.
De tweede is flexibiliteit in het ontwerp, want met API's kan de workflow vertakken, opnieuw proberen en afhankelijk van wat de Claygents eerder in de keten teruggaven verschillende externe tools aanroepen.
Dezelfde logica geldt voor inbound- en intent-ketens. Hetzelfde team van Claygents drijft ze allemaal aan, dezelfde n8n- of API-flows sturen data tussen tools, en het ritme hangt af van waar elke keten op reageert.
Door die bedrading wordt een Clay-tabel van een researchtool een systeem dat meetings oplevert terwijl je team slaapt.
Claygent vs Claude Code: wanneer welke tool de juiste is
Dit is de sectie die we aan het begin beloofden. We gebruiken beide tools dagelijks, en de vraag welke we moeten pakken komt elke week terug. Met deze vergelijking willen we je een heldere manier geven om tussen de twee te kiezen. Een winnaar aanwijzen is het doel niet.
Wat Claude Code is, voor wie er alleen zijdelings van heeft gehoord
Claude Code is de agent van Anthropic voor power users. Hij werkt in je terminal, je IDE, je desktopapp of je browser, en hij kan alles wat een chat met Claude kan, en nog veel meer.
Het belangrijkste is dat Claude Code bestanden op je computer kan lezen en schrijven, shell-commando's kan uitvoeren, het web op kan en zelfstandig taken van meerdere stappen aan elkaar kan koppelen.
De release van mei 2026 voegde een Agent View-dashboard toe om parallelle sessies te beheren, en een /goal-commando voor doelgerichte sessies die doorlopen tot het doel is bereikt.
Claude Code werd in het begin vooral door engineers omarmd. Voor een GTM-team is het interessante dat je geen engineer hoeft te zijn om het te gebruiken.
Als je in gewone taal kunt beschrijven wat je gedaan wilt hebben, kan Claude Code je lokale bestanden lezen, je API's bevragen en de output maken die je nodig hebt.
Wat Claude Code kan en Claygent niet
Voor een verkoper of iemand in een revenue team tellen drie verschillen.
Het eerste is toegang tot bestanden op je eigen computer. Claygent werkt binnen een Clay-tabel en leest het web. Claude Code kan alles op je computer lezen.
Denk aan pdf's van contracten, CSV-exports van CRM-data, Slack-archieven, screenshots van prijspagina's van concurrenten en transcripties van salescalls. Staat het bestand op je computer, dan kan Claude Code het openen en ermee redeneren.
Het tweede is diepgang bij één losse researchtaak. Claygent is het meest zinvol als dezelfde prompt voor honderden rijen geldt. Claude Code is het meest zinvol als één taak op zichzelf diepgang en grondigheid vraagt.
Moet je voor een meeting op vrijdag één strategisch account onderzoeken en alles bij elkaar zoeken wat er te vinden is, dan gaat Claude Code dieper dan Claygent, omdat het antwoord niet in een Clay-kolom hoeft te passen.
Het derde is integratie met tools via het Model Context Protocol. Claude Code praat met elk systeem dat een MCP-server heeft (je CRM, je datawarehouse, je interne docs, je monitoringtools). De integraties van Claude Code gaan verder dan wat Clay zelf ondersteunt.
RevOps-teams gebruiken dit om Claude Code te koppelen aan HubSpot, Salesforce, BigQuery of wat er verder in hun stack zit, en om ze allemaal in één prompt te bevragen.
Wat Claygent kan en Claude Code niet
Heb je schaal en structuur nodig, dan draait het om.
Claygent werkt op schaal over honderden rijen in één workflow. Claude Code kan dezelfde klus in een chat voor tien rijen doen, maar voor tienduizend rijen is dat traag en duur vergeleken met een Claygent-tabel die dezelfde rijen in een paar minuten verwerkt, voor een fractie van de kosten.
Claygent geeft getypeerde kolommen terug waar andere stappen in de workflow zonder vertaalslag mee verder kunnen. Een true/false-output van een Claygent gaat direct naar een vertakkende kolom verderop.
Een relevantieregel die een Claygent schreef, komt in het outboundplatform terecht zonder dat iemand hem kopieert of opmaakt. Claude Code geeft tekst terug die je daarna zelf moet verwerken en doorsturen.
Claygent draait met een vast ritme in een workflow zonder dat iemand ernaar kijkt. Claude Code is standaard interactief en heeft een sessie nodig.
Je start een sessie, beschrijft het doel en controleert de output. Met het nieuwe /goal-commando zijn langere zelfstandige sessies mogelijk, al blijft het werk sessiegebonden en draait het niet altijd door.
Hoe een verkoper tussen de twee kiest
Bij elke researchtaak stellen we twee vragen, in deze volgorde.
De eerste is of de klus zich op schaal over veel rijen moet herhalen. Is het antwoord ja, dan hoort de klus in Claygent.
Denk aan 500 bedrijven kwalificeren, een leadlijst verrijken, een hele TAM scoren of 200 accounts monitoren op triggers. Dat zijn allemaal Claygent-klussen.
De tweede is of de klus bestanden, diepgang of toegang tot systemen buiten Clay nodig heeft. Is het antwoord ja, dan hoort de klus in Claude Code.
Denk aan een stapel pdf's lezen, het CRM bevragen via een MCP-server, diep onderzoek doen naar één strategisch account of de Claygent-prompt schrijven voor een use case die je nog niet hebt gebouwd. Dat zijn allemaal Claude Code-klussen.
Er is een overlapzone waarin beide tools werken. Dan kiezen we standaard voor Claygent als de output uiteindelijk in een Clay-tabel moet landen, en voor Claude Code als de output in een Slack-bericht, een Google Doc of een presentatie moet komen.
Er is ook een slimme metastap die we hier moeten noemen. Een aantal van de beste Claygent-prompts in onze bibliotheek kwam uit sessies met Claude Code.
We geven Claude Code de bronpagina's die we willen scrapen, vragen hem een prompt in S.P.I.C.E.-formaat op te stellen die de getypeerde output oplevert die we nodig hebben, en plakken het resultaat in Clay. De tool die de workflow bouwt, hoeft niet de tool te zijn die hem uitvoert.
In een echte GTM-stack vullen ze elkaar aan
Eerlijk gezegd concurreren Claygent en Claude Code niet om dezelfde klus. Het zijn twee tools voor twee soorten werk, en de teams die er het meest uit halen, gebruiken meestal allebei.
De meeste teams hebben een zwaartepunt dat bepaalt welke tool vaker opengaat. Wie veel met Clay werkt, raakt Claude Code misschien zelden aan, en researchteams bouwen misschien zelden een Claygent. Allebei prima.
De meeste GTM-teams hebben elke week allebei soorten werk, dus de praktische vraag is wanneer je welke pakt. Het gaat er niet om dat je er één kiest.
De twee tools passen prima naast de rest van je sales tech stack, en elk doet het werk waar hij het best in is.
Waar het op neerkomt
Claygent is de laag die een Clay-tabel verandert van een statisch enrichment-raster in een workflow met oordeelsvermogen. De teams die er het meest uit halen, zien hem al maanden niet meer als één losse kolom.
De vorm waar we steeds op terugkomen, is dezelfde als bovenaan. Bepaal een vraag die op schaal beantwoord moet worden, richt een Claygent op de bron waar het antwoord echt staat, schrijf de prompt met structuur en laat de getypeerde output doorstromen naar wat er daarna komt.
Het team van Claygents dat je kunt bouwen, is veel groter dan het standaard outbound-playbook doet vermoeden. Sales, RevOps, marketing en customer success hebben allemaal Claygent-vormen die echte output opleveren waar je mee aan de slag kunt zonder de tabel te verlaten.
Moet de klus zich op schaal herhalen, dan is Claygent de juiste tool. Vraagt de klus om toegang tot bestanden, diepgang bij één taak of integratie met systemen buiten Clay, dan is Claude Code de juiste tool. In de meeste werkweken heb je allebei soorten klussen.
Dat wilden we op tafel leggen. Bouw het team, koppel de stappen, stem het model af op de klus, en de workflow doet het werk.
Let op: het onderzoek dat je reps elke ochtend met de hand doen, is precies wat een Clay AI-agent 's nachts zou moeten doen.
Checken of een bedrijf in je ICP past, de site lezen, uitzoeken wie je moet benaderen en waarom juist nu. Claygent kan dat allemaal, en in de meeste workspaces doet hij er niets van, omdat niemand tijd had om de keten te ontwerpen.
Bij Nebor zijn we Clay Solutions Partner, en de meeste bouwtijd gaat bij ons naar Claygent. We koppelen agents aan elkaar: de ene kwalificeert het account, een andere let op een trigger waar je iets mee moet en weer een andere schrijft de opener. Ze schrijven allemaal terug naar dezelfde tabel, zodat je rep een rij opent waar het antwoord al in staat.
Plan een call van 15 minuten en laten we het over je Clay-setup hebben.
Gerelateerde artikelen


Door op Registreren te klikken bevestig je dat je akkoord gaat met onze Algemene Voorwaarden.