Clay + n8n: zo bouw je een moderne sales tech stack die je GTM en RevOps aandrijft
In this post:
Een sales tech stack is de set tools waar je workflows doorheen kunnen lopen zonder dat er een mens tussen zit, en de meeste bedrijven hebben er geen.
Loop bij een willekeurig GTM-team vanaf series A binnen en je ziet steeds hetzelfde beeld. De prospecting-laag leunt op Apollo of Sales Navigator, het CRM is HubSpot of Salesforce, en een tool voor e-mailoutreach verstuurt de sequences.
Daarnaast draait een tool voor LinkedIn-automatisering, Calendly regelt de afspraken, en een rapportagedashboard dat al drie kwartalen niemand heeft aangeraakt, houdt bij wat het nog bijhoudt.
De gezamenlijke maandrekening van al die leveranciers komt ruim boven de vijf cijfers uit. En geen van die tools praat met de rest zonder dat een mens data tussen tabbladen kopieert.
De meeste founders openen het gesprek met dezelfde vraag: welke tools moeten ze als eerste kopen?
Wij zijn gaan denken dat de vraag ergens anders begint. Welke workflows heeft het revenue team nodig, en hoeveel menselijk oppaswerk kunnen we in elk daarvan accepteren?
Kies altijd de tools die die workflows dragen, en kies ze als laatste. Doe je het andersom, dan tel je een maandrekening van vijf cijfers nooit op tot een GTM-systeem.
De versnippering wordt erger naarmate er meer revenue-functies in je organisatie bijkomen. Het SDR-team bouwt ernaast een eigen outbound-stack, en Marketing heeft een deur verderop een eigen automatiseringssuite.
RevOps zet een eigen laag voor rapportage en forecasting op in welke CRM-weergave er toevallig is. Customer Success zit in een aparte tool voor productanalyse die verder niemand opent.
Het resultaat is vier overlappende stacks die geen data delen, zonder één persoon die alle vier begrijpt.
We schreven al eerder waarom dat patroon extra mensen oplevert in plaats van systemen, en de reflex om met tools te beginnen is daar elke keer de oorzaak van.
We zouden dit artikel elke maand kunnen herschrijven en nog steeds niet alles behandelen, en dat is ook een deel van het punt. Een koopgids over welke tool welke categorie wint, mist volgens ons waar het om draait. Wij ontwerpen eerst de workflows en kiezen daarna de tools die elke workflow dragen.
De tools die we gebruiken, veranderen elk kwartaal of elk halfjaar. De onderliggende workflowlogica verandert veel trager, en daar gaat de rest van dit artikel over.
We nemen je laag voor laag mee door de GTM- en RevOps-stack die we voor klanten bouwen. We laten zien wat er in elke laag zit, waarom we voor bepaalde tools kiezen en waar elke tool zijn geld mee verdient.
Kwam je voor een ranglijst van tools, dan is dit hem niet. Wil je zien hoe een GTM-besturingssysteem er op workflowniveau uitziet, begin dan bij het volgende deel.
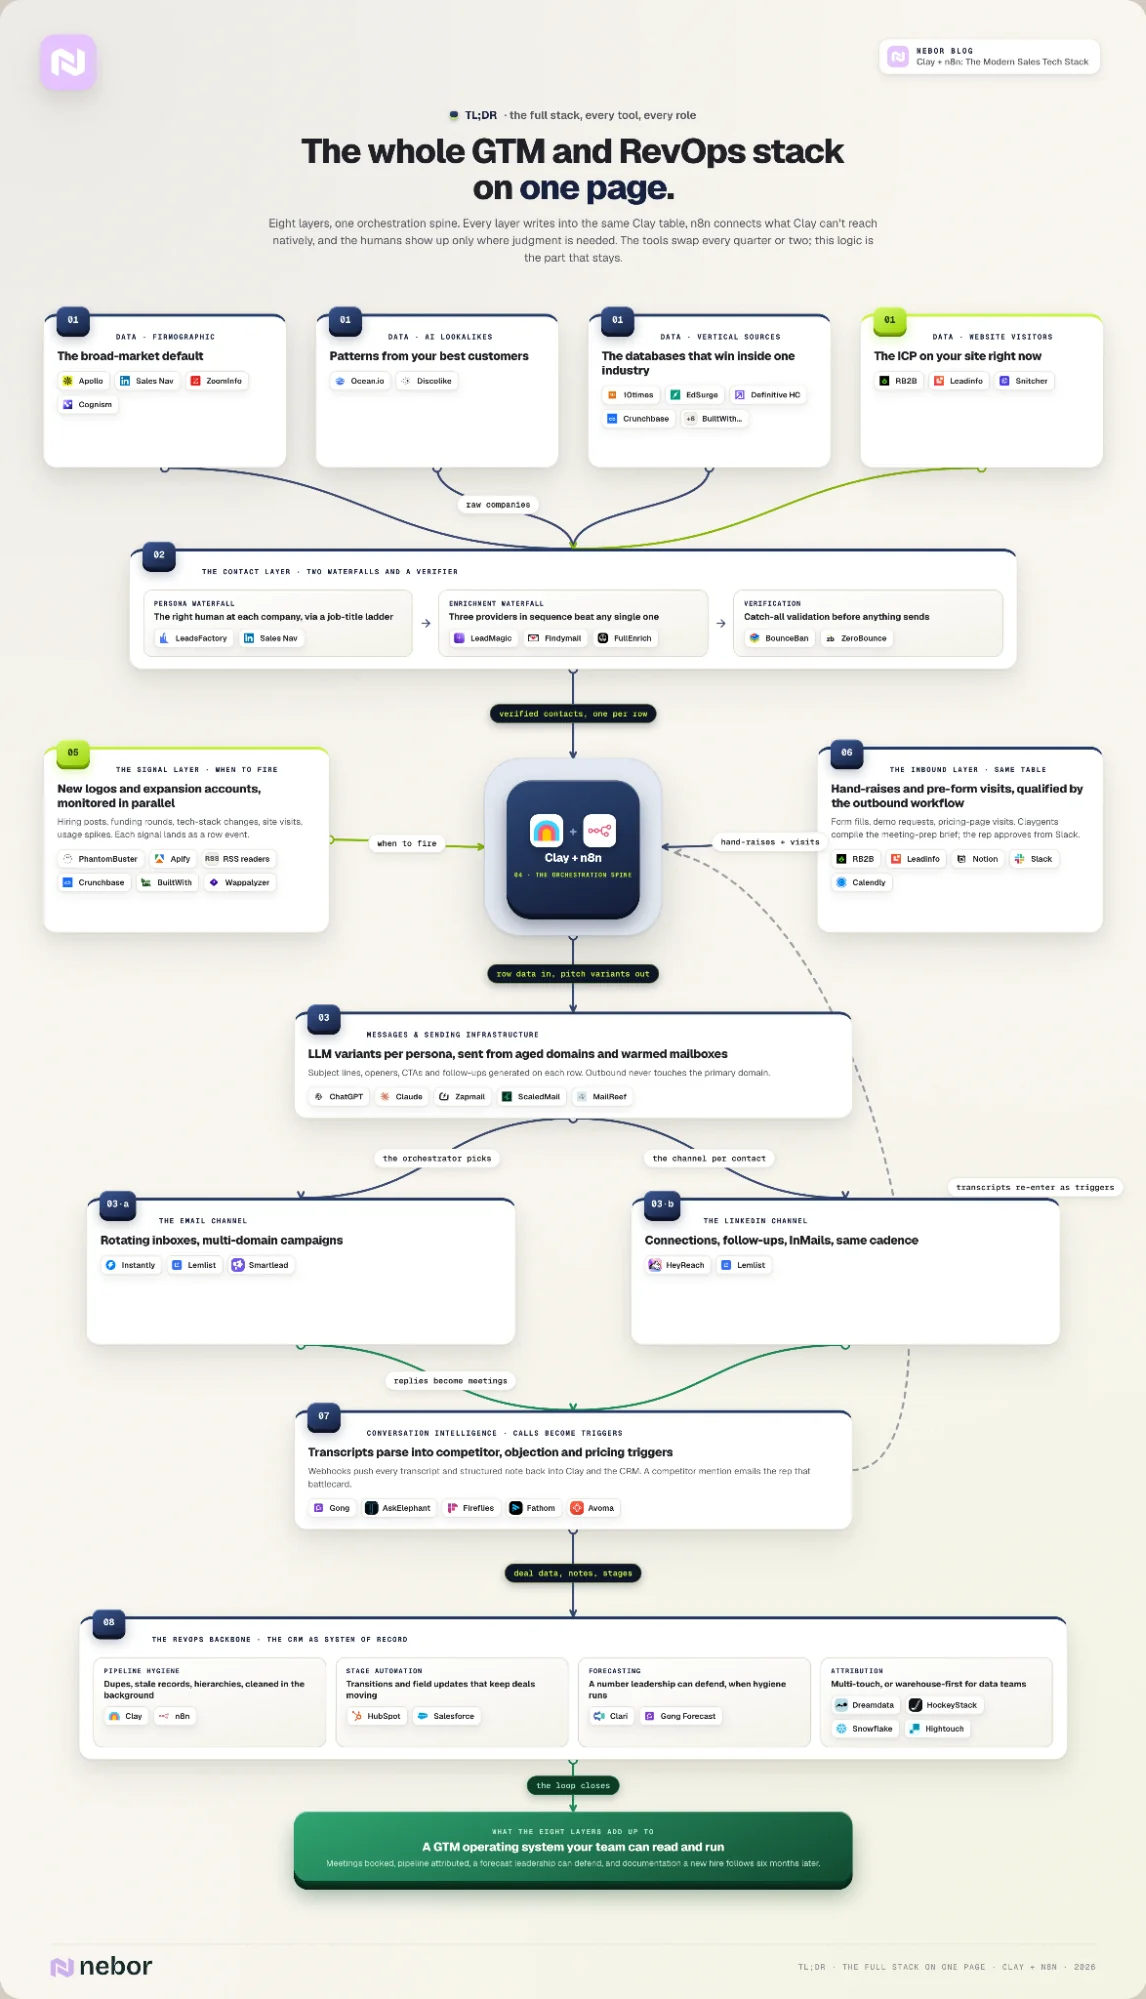
TL,DR: de volledige tech stack, met de tools en hun rol in je go-to-market-aanpak
Zo ziet de hele tech stack eruit. Houd er rekening mee dat we niet bij elke klant precies hetzelfde bouwen. Een tech stack bouwen hangt altijd af van de context en van wat het bedrijf nodig heeft. Wat een bedrijf al heeft en hoe de processen lopen, speelt ook mee.
Wat een stack tot een stack maakt
Voordat we doorlopen wat we in de stack stoppen, moeten we het eerst eens zijn over wat een stack is. Je beoordeelt een stack op de complete workflows die erin draaien, en dus op meer dan de losse tools.
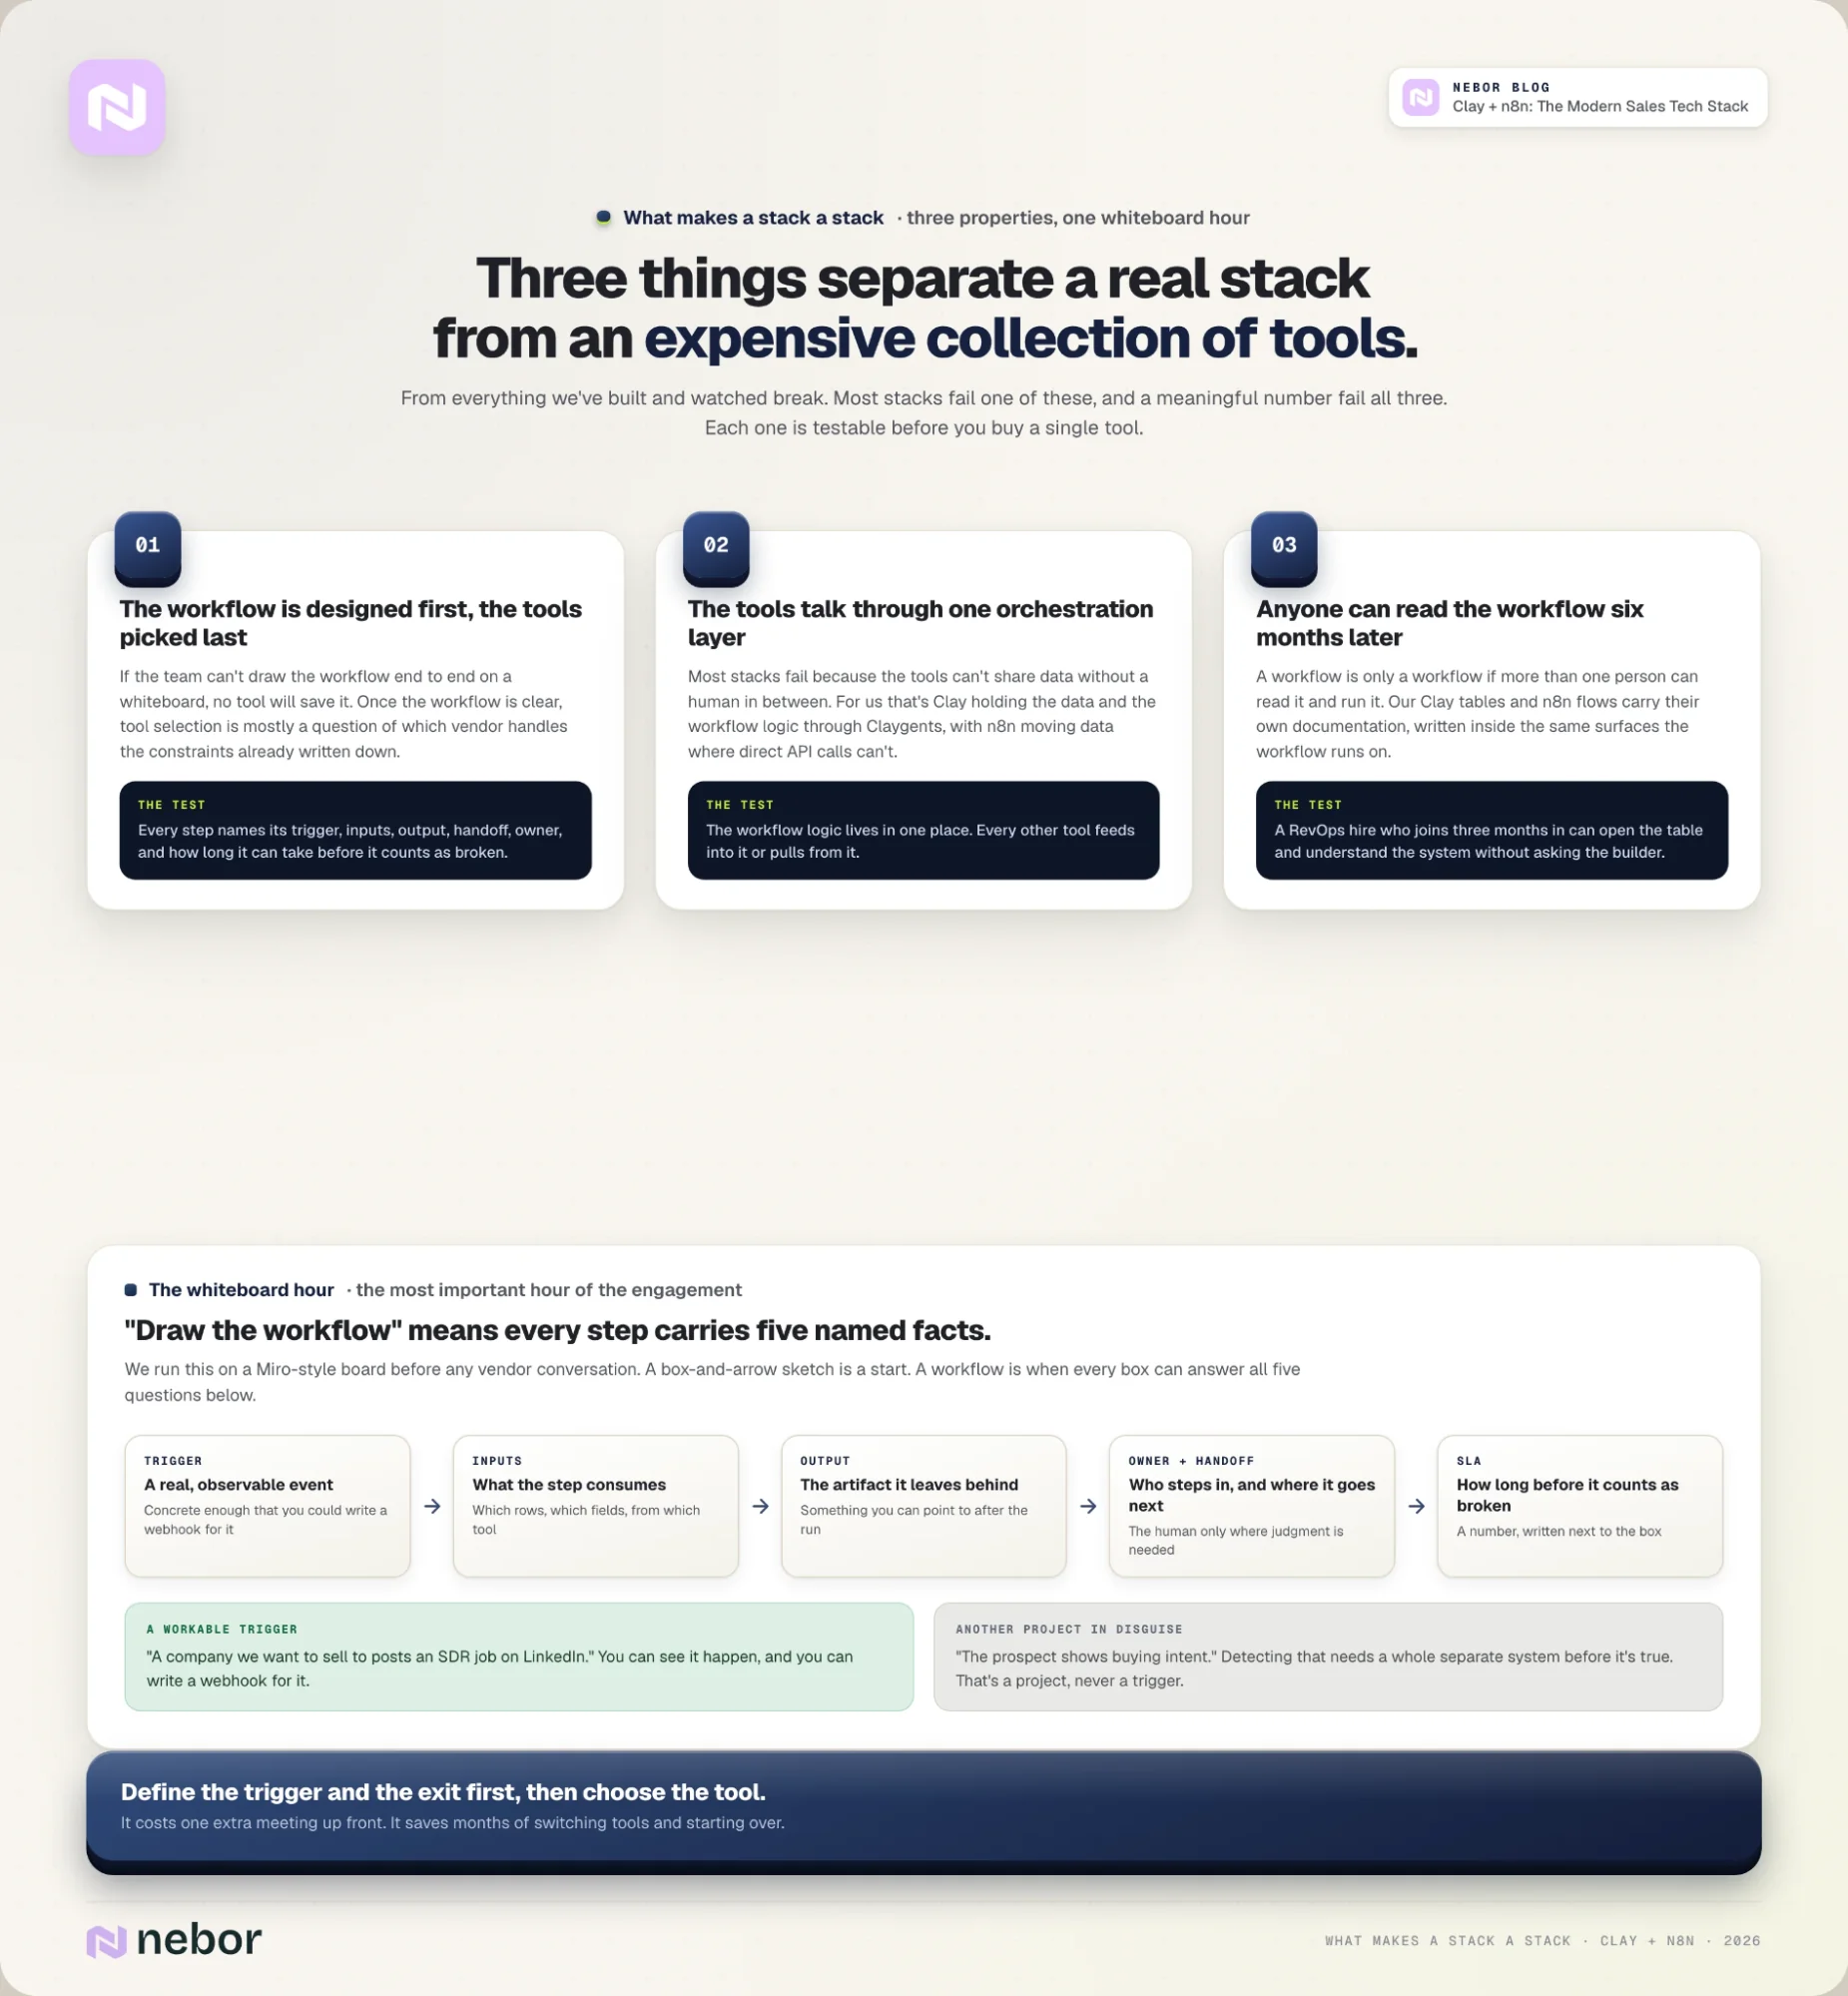
Een stack is dus elke set tools die de workflows kan dragen zonder dat een mens ze met de hand aan elkaar knoopt.
Uit alles wat we hebben gebouwd en hebben zien breken, halen we drie dingen die een echte stack onderscheiden van een dure verzameling tools.
1. We ontwerpen eerst de workflow en kiezen de tools als laatste.
Kan een salesteam de workflow niet van begin tot eind op een whiteboard tekenen, dan redt geen enkele tool het. De whiteboardoefening klinkt basaal, maar het is het belangrijkste uur dat we aan het begin van een samenwerking besteden.
Is de workflow eenmaal helder, dan is de toolkeuze vooral een kwestie van welke leverancier past binnen de voorwaarden die we al hebben opgeschreven.
Met "de workflow tekenen" bedoelen we iets specifiekers dan een flowchart met blokjes en pijlen. Bij elke stap moet staan wat de trigger is, wat de input is, wat de stap oplevert en hoe de overdracht naar de volgende stap gaat.
Bij elke stap moet ook staan wie de eigenaar is als er een mens moet ingrijpen, en hoe lang de stap mag duren voordat hij als kapot telt.
De meeste teams die zeggen dat ze een workflow hebben, hebben alleen de trigger en de uitgang. Ze kunnen ons vertellen dat leads uit Apollo komen en dat meetings in de agenda van de AE belanden, maar het midden is grotendeels vaag. En juist in dat midden hoort een tool het werk te doen.
In de praktijk doen we deze oefening op een bord in de stijl van Miro, en elke stap krijgt een naam, een eigenaar, een tool en een SLA. Een bruikbare trigger is zo concreet dat we er een webhook voor zouden kunnen schrijven. Het moet een echte, waarneembare gebeurtenis zijn.
Iets als "een bedrijf waaraan we willen verkopen, plaatst een SDR-vacature op LinkedIn" werkt, omdat je het echt ziet gebeuren.
"De prospect toont koopintentie" werkt niet, omdat je intentie niet op zichzelf kunt detecteren. Je zou een heel apart systeem moeten bouwen om te bepalen wanneer het klopt. Dan is het geen trigger meer. Dan is het een nieuw project.
De uitgang verdient dezelfde behandeling (en dezelfde kritische blik). Je moet helder kunnen zeggen of de workflow klaar is, wanneer hij klaar was en wat hij heeft achtergelaten (zoals een artefact) waar je achteraf naar kunt wijzen.
Het is verleidelijk om eerst de tool te kiezen en de workflow later uit te zoeken, maar je kunt beter het omgekeerde doen. Bepaal eerst de trigger en de uitgang, en kies daarna de tool. Het kost je vooraf één extra meeting en het bespaart je maanden aan tools wisselen en opnieuw beginnen.
2. De tools praten met elkaar via één orkestratielaag.
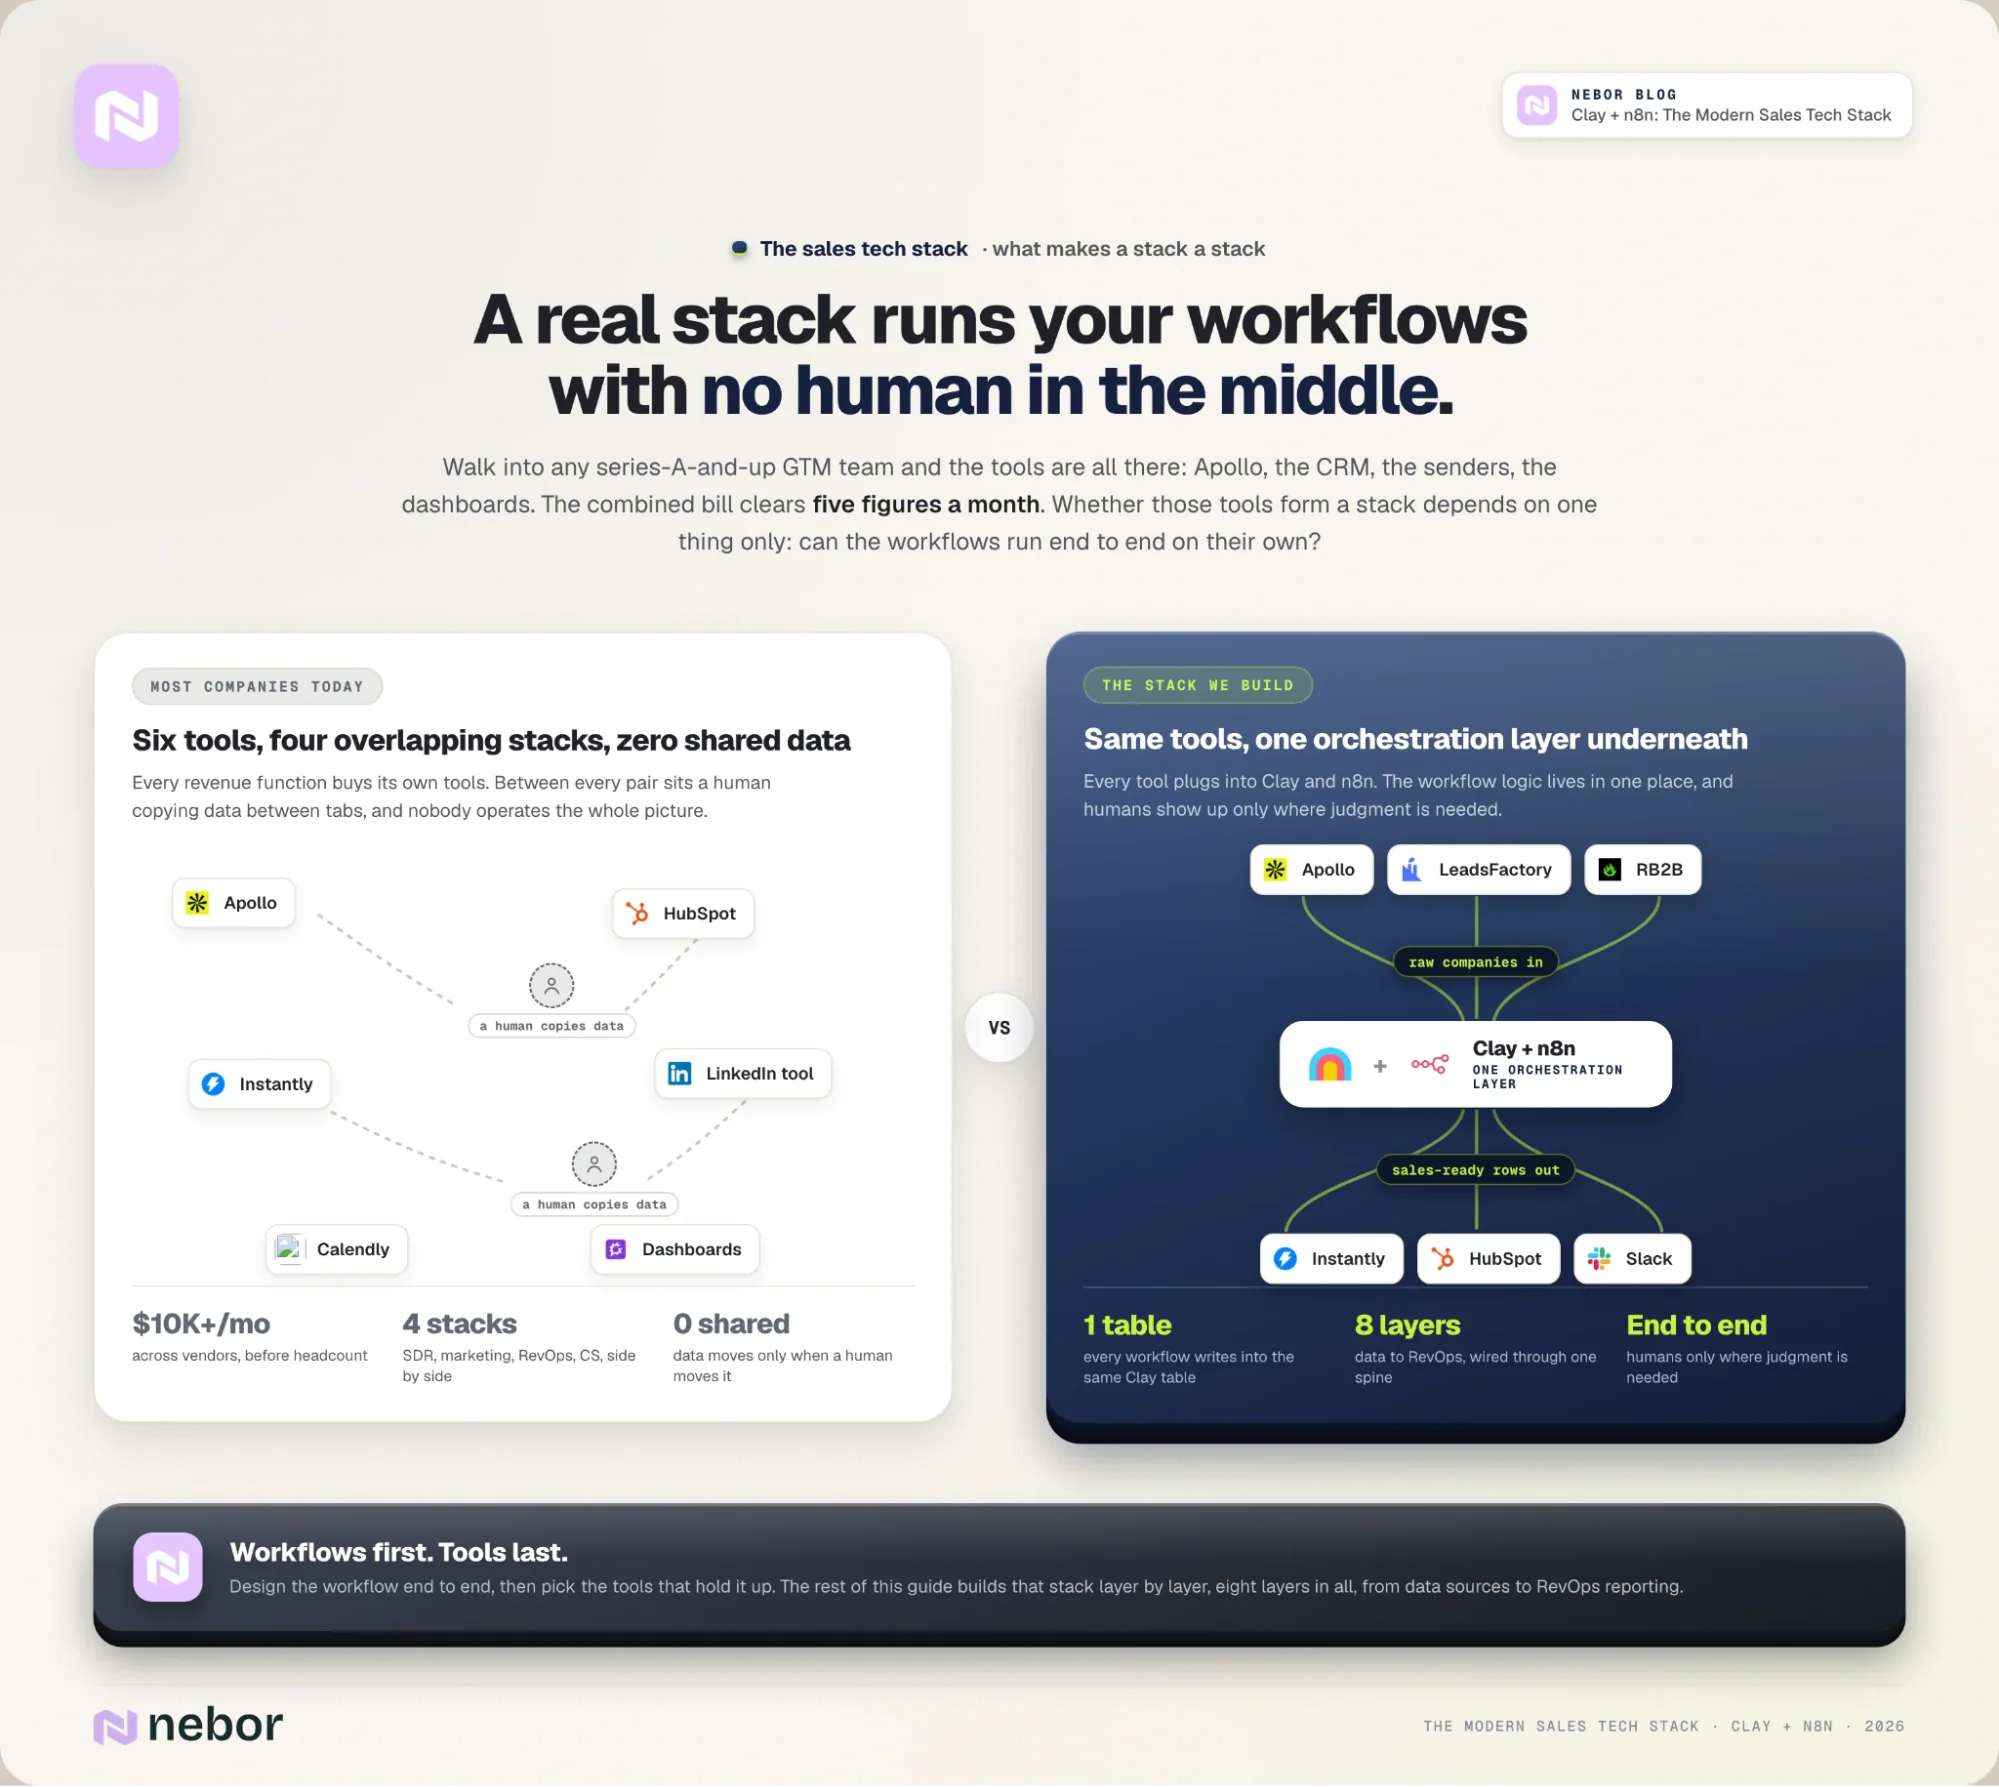
De meeste stacks mislukken door iets anders dan de tools die erin zitten. Ze mislukken omdat die tools geen data delen zonder een mens ertussen. De oplossing is één orkestratielaag waar elke andere tool op aansluit.
Voor ons is dat Clay, dat via Claygents de data en de workflowlogica vasthoudt, met n8n dat we soms inzetten om data te verplaatsen tussen Clay, het CRM, de outreach-tools en de call recorders. Gebruik een tool als n8n alleen als je geen directe API-calls kunt maken.
Bij een ander bureau kan het een andere combinatie zijn. Het principe blijft overal hetzelfde. De workflowlogica zit op één plek, en elke andere tool voedt die of haalt eruit.
3. Iedereen in het team kan de workflow zes maanden later lezen en begrijpen.
Een workflow is pas een workflow als meer dan één persoon hem kan lezen en bedienen. De Clay-tabellen en n8n-flows die we bouwen, hebben hun eigen documentatie, en die schrijven we op dezelfde plekken waar de workflow zelf draait.
Een nieuwe RevOps-medewerker die na drie maanden instapt, moet de tabel kunnen openen, de logica van de kolommen kunnen lezen en begrijpen wat het systeem doet, zonder het te vragen aan degene die het heeft gebouwd.
Lukt dat niet, dan heeft de workflow een bus factor van één en is het systeem kwetsbaarder dan het dashboard doet vermoeden.
Deze drie kenmerken zijn makkelijk op te schrijven en zie je in de praktijk zelden. De meeste stacks zakken voor een ervan, en een flink deel zakt voor alle drie.
De reden is overal hetzelfde. De meeste stacks komen uit teams die maar de helft van het werk kennen.
Aan de ene kant staan de technisch sterke mensen. Ze schrijven heel geavanceerde n8n-flows, zetten Clay-tabellen op, integreren API's en bouwen elegante koppelingen.
Het probleem is dat ze niet altijd weten hoe een echte outbound-call klinkt of welke momenten in een dealcyclus het zwaarst wegen. De workflows die ze bouwen zijn netjes, maar lossen problemen op waar het salesteam niet tegenaan loopt.
Aan de andere kant staan de operators met het juiste gevoel. Ze hebben genoeg calls gedaan om te weten wat telt, maar grijpen voor de techniek naar standaardbureaus en spreadsheets, omdat de technische laag buiten bereik voelt.
De combinatie van die twee is zeldzamer dan zou moeten. Onze founders (Yannick en Andrew) bouwden Nebor op vanuit hun eigen outbound-werk, lang voordat ze het aan klanten verkochten.
We werken als bureau voor GTM-systemen met meer dan 10 jaar saleservaring. Die overlap zorgt dat dit allemaal werkt, en het is ook de reden dat de rest van dit artikel tools en workflows in één adem behandelt.
Nu dat gezegd is: dit stoppen we in de stack, en hiermee verdient elke laag zijn plek.
Zo bouw je de volledige GTM-tech stack laag voor laag op: van databronnen tot RevOps-rapportage
Stap 1: kies databronnen op basis van je ICP (nooit op merknaam)
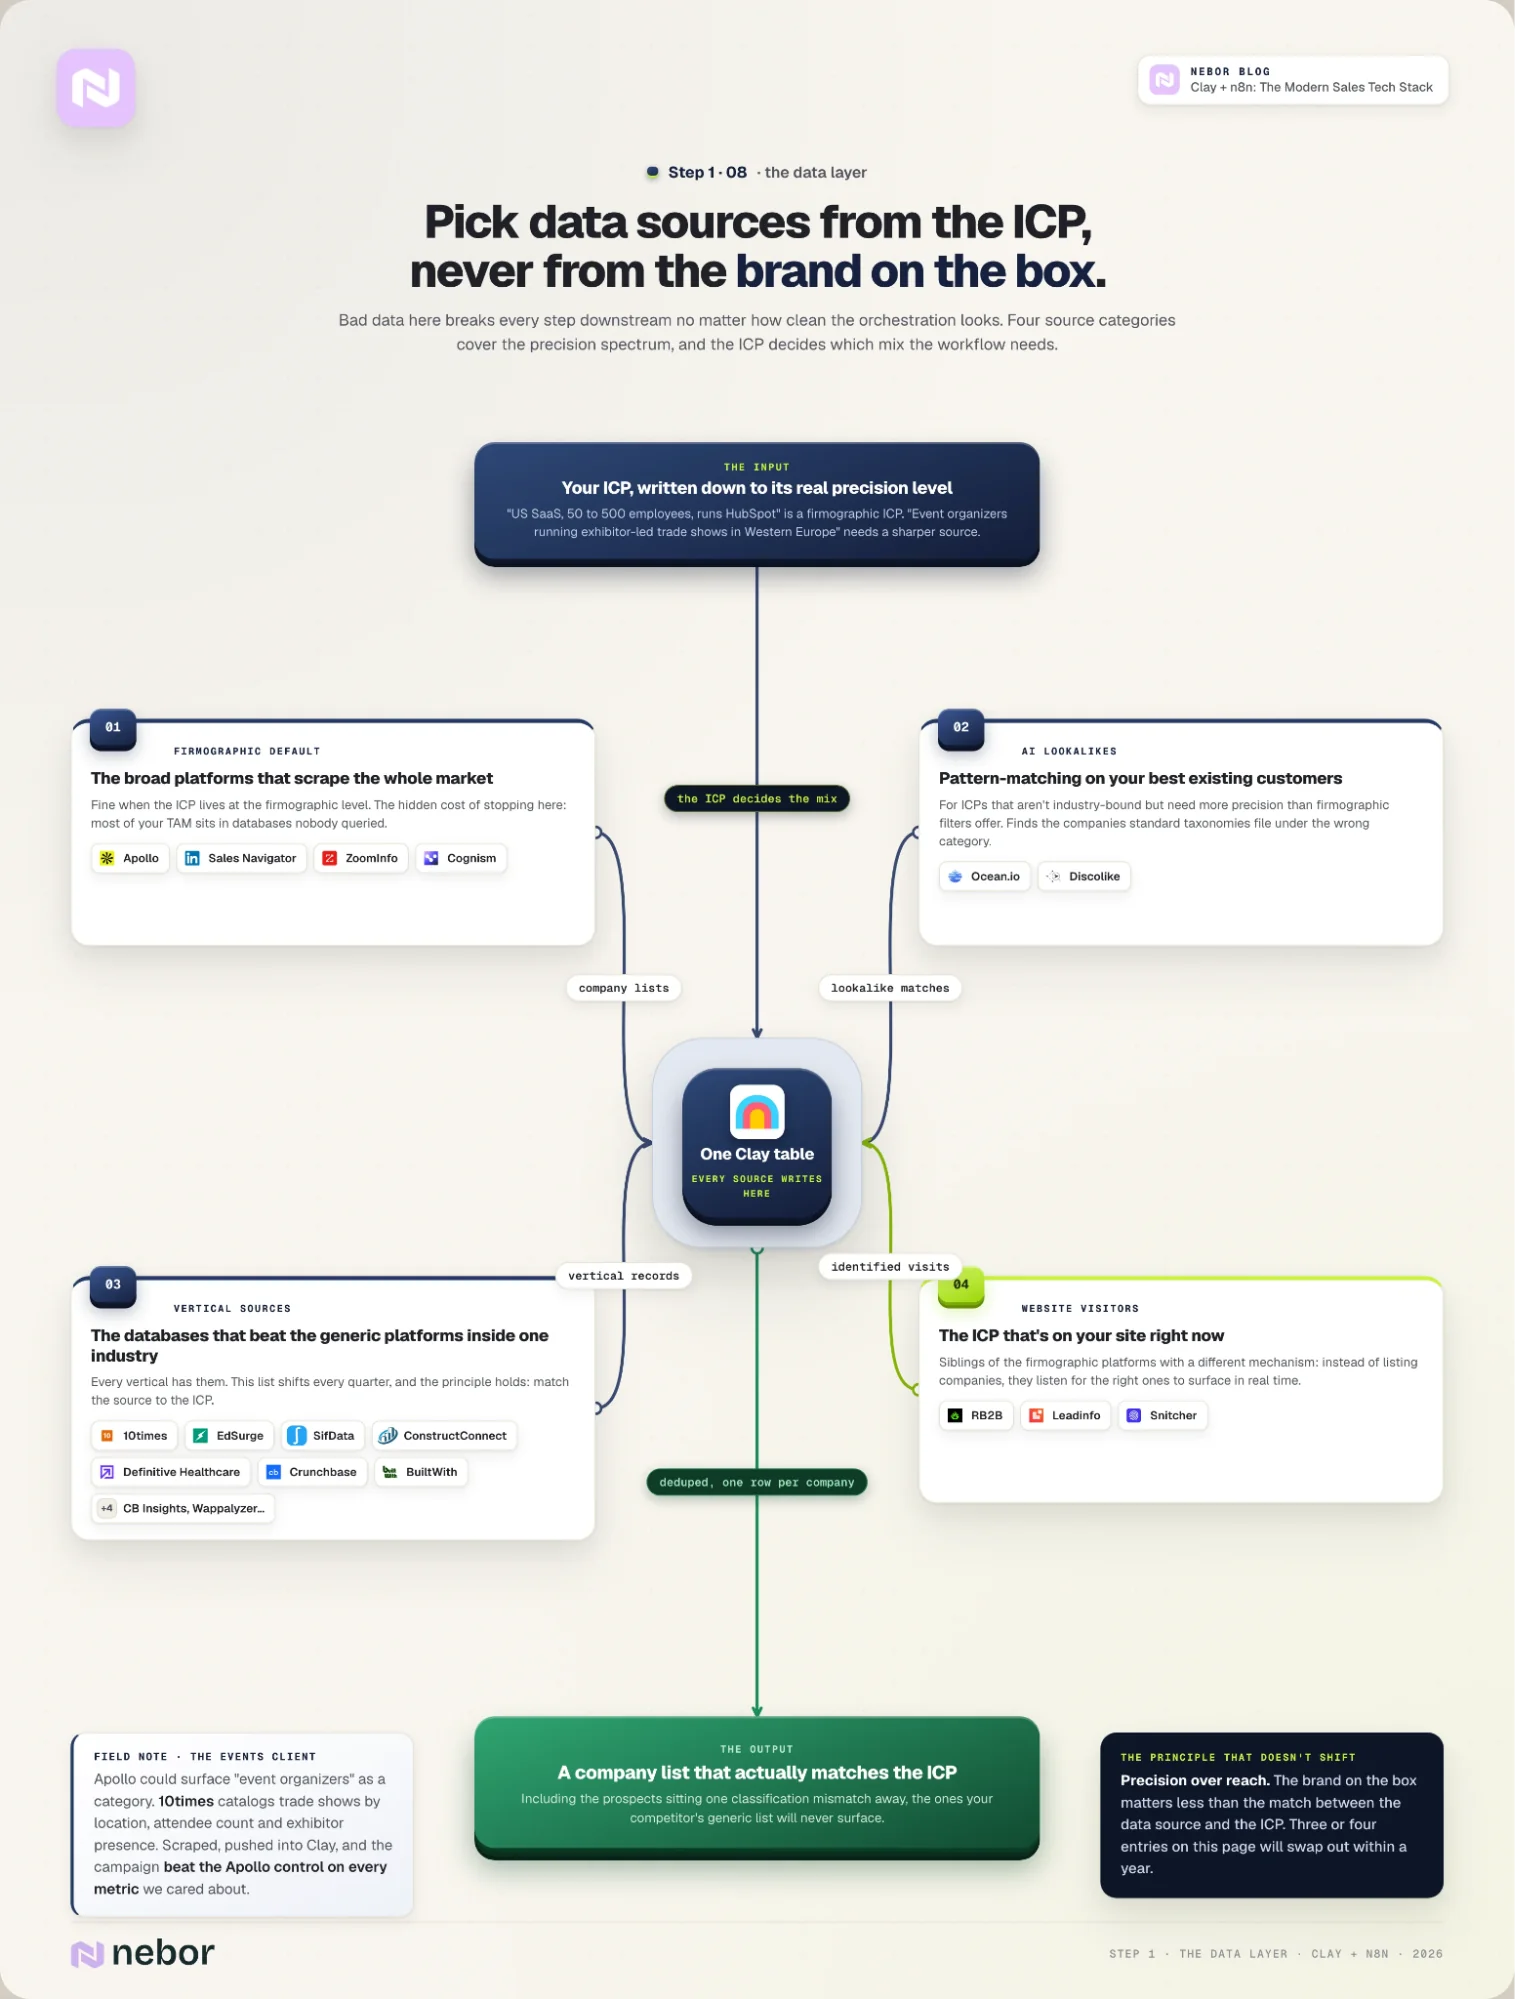
In de datalaag begint de workflow, en slechte data breekt hier elke stap verderop, hoe netjes de orkestratie er ook uitziet.
Apollo, Sales Navigator, ZoomInfo, Cognism: de firmografische standaard
De meeste teams beginnen hun stack op de automatische piloot door het platform te kopen waar het meest over wordt gepraat, en dat is meestal Apollo, LinkedIn Sales Navigator, ZoomInfo of Cognism.
Wat die standaardkeuze kost, is niet altijd duidelijk. Meestal is het wel het grootste deel van je total addressable market (TAM), dat begraven ligt in databases die niemand heeft doorzocht omdat ze te klein of te onbekend zijn om in de gesprekken op te duiken.
Die vier zijn prima voor wat ze doen. Het zijn brede firmografische platforms die de adresseerbare markt op schaal scrapen, en voor een ICP dat op firmografisch niveau leeft (SaaS-bedrijven in de VS met 50 tot 500 medewerkers die HubSpot gebruiken) doen ze hun werk.
De problemen beginnen als het ICP een precisie vraagt die de firmografische laag niet kan leveren. De verkeerde bron hoeft een campagne niet te doden, en we hebben genoeg campagnes een meeting of twee zien boeken uit generieke Apollo-lijsten.
De echte kosten zitten in de deals die je ziet weglopen zonder dat je het merkt. De prospects die je had kunnen sluiten, zitten één verkeerde classificatie verderop in een database die je niet kende, en je concurrent zit met ze aan de lijn.
We hadden een klant met als ICP organisatoren van beurzen met exposanten in West-Europa. Apollo kon evenementenorganisatoren als categorie vinden, maar haalde niet de precisie die de klant nodig had.
De juiste bron voor dat ICP was 10times, dat beurzen catalogiseert op locatie, aantal bezoekers en aanwezigheid van exposanten.
We haalden de lijst op met een Chrome-scraper, zetten hem in Clay, en de campagne presteerde beter dan de Apollo-controlegroep op elke metric die voor ons telde.
Ocean.io en Discolike: AI-lookalikes voor ICP's die niet firmografisch zijn
Voor ICP's die niet aan een branche vastzitten maar toch meer precisie nodig hebben dan firmografische filters bieden, is de laag met AI-lookalikes de volgende stap. Ocean.io en Discolike zijn de tools die we daarvoor gebruiken.
Ze kijken naar de patronen die je beste bestaande klanten delen en vinden bedrijven die bij die patronen passen, ook de bedrijven die de standaardindelingen van de populaire databrontools in de verkeerde categorie stoppen.
10times, SifData, ConstructConnect, Definitive Healthcare, BuiltWith en de verticale databronnen die we gebruiken
Naast de laag met AI-lookalikes heeft elke branche databronnen die de generieke platforms binnen die branche verslaan. Het evenementenvoorbeeld hierboven is er een van, en afhankelijk van de branche zijn er nog tientallen meer.
Dit zijn een paar databronnen die we regelmatig voor onze klanten gebruiken.
10times voor beurzen en exposantendata wereldwijd
EdSurge voor EdTech-bedrijven en hun beslissers
SifData en Clay voor vacatures en trigger events bij SaaS-bedrijven
ConstructConnect voor bouwprojecten en aannemers
Definitive Healthcare voor ziekenhuizen, zorgverzekeraars en zorgnetwerken
Data Axle voor traditionele B2B-sectoren zoals productie en distributie
StoreLeads voor winkels op Shopify, WooCommerce en BigCommerce
Crunchbase en CB Insights voor data over startups, venture capital en private bedrijven
BuiltWith en Wappalyzer om de tech stack van doelbedrijven te volgen
Naast de firmografische bronnen en de lookalike-bronnen is er nog een categorie: de signaallaag. In plaats van bedrijven op te sommen, luisteren deze tools naar realtime gedrag waardoor de juiste bedrijven naar boven komen.
Sommige letten op bezoekers van je eigen website die bij je ICP passen. Andere letten op gedragssignalen op LinkedIn en de rest van het sociale web.
In deze laag noemen we de kant van de websitebezoekers, met RB2B, Leadinfo en Snitcher. De tools voor social en bredere intentie behandelen we in stap 5, waar we dieper ingaan op het monitoren van signalen bij nieuwe logo's en bij expansion-accounts.
We zien de tools voor websitebezoekers in deze laag als broertjes van de firmografische platforms, omdat ze dezelfde vraag beantwoorden via een ander mechanisme.
Deze lijst met tools verandert elk kwartaal of halfjaar merkbaar. Overnames halen tools van de markt, er komen nieuwe bij en leveranciers passen hun prijzen aan. De lijst hierboven is wat we nu gebruiken, en we verwachten dat er het komende jaar drie of vier namen worden vervangen.
Het principe dat niet verandert, is precisie boven bereik. Het merk op de doos telt minder dan hoe goed de databron bij het ICP past.
Stap 2: bouw de contactlaag met twee waterfalls
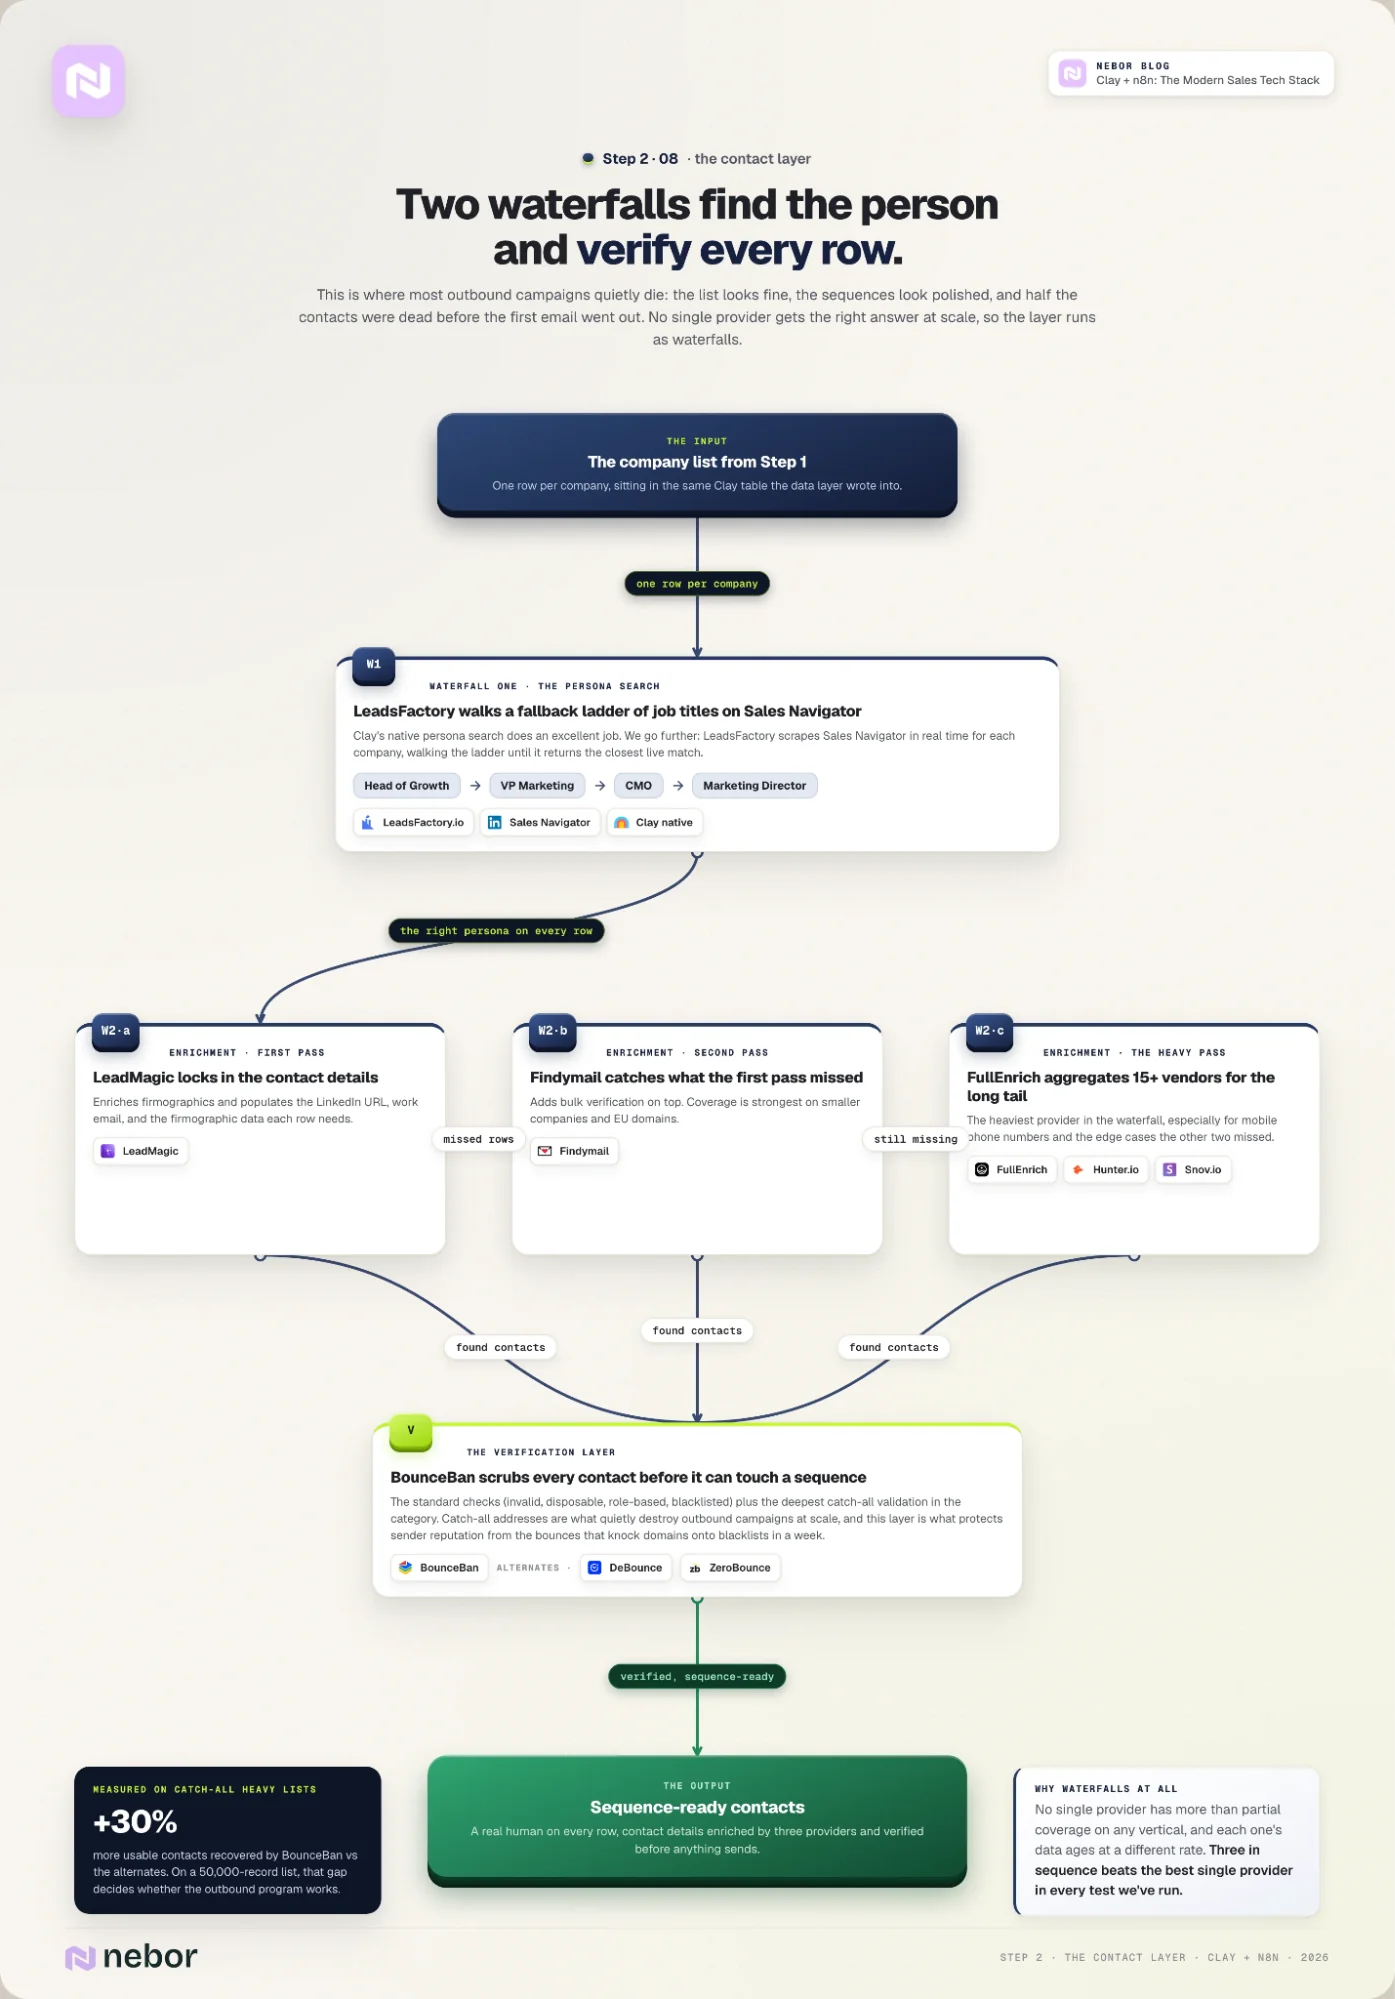
Heeft de datalaag de juiste bedrijven gevonden, dan is de volgende taak de juiste mensen bij die bedrijven te vinden en te controleren of hun contactgegevens nog kloppen. Hier gaan de meeste outbound-campagnes ongezien dood.
De lijst ziet er goed uit en de sequences zijn gepolijst. Het aantal meetings komt alleen nooit van zijn plek, omdat de helft van de contacten al dood was toen de eerste e-mail de deur uit ging.
Bij Nebor bouwen we in de contactlaag twee aparte waterfalls. De eerste vindt de juiste persoon bij elk bedrijf. De tweede verrijkt de contactgegevens van die persoon en verifieert ze, voordat er iets in een sequence belandt.
Elke waterfall bestaat omdat geen enkele poging (met maar één bron) je op schaal het juiste antwoord geeft. Behandel je deze laag als een eenmalige lookup, dan vergiftig je elke workflow verderop.
LeadsFactory.io: de persona-waterfall bovenop Sales Navigator
De eerste waterfall is de zoektocht naar de persona bij elk bedrijf. Clay doet dat zelf al uitstekend. Toch stoppen we daar niet. We gebruiken LeadsFactory.io om Sales Navigator realtime te scrapen voor elk bedrijf op de lijst, met een ladder van functietitels om op terug te vallen.
Voor een ICP waarin je de head of growth wilt bereiken, kan die ladder zijn: Head of Growth → VP Marketing → CMO → Marketing Director. Bestaat de eerste titel bij een bedrijf niet, dan loopt LeadsFactory de ladder verder af en geeft de dichtstbijzijnde bestaande match terug.
LeadMagic, Findymail, FullEnrich (en Hunter.io, Snov.io): de enrichment-waterfall
Het resultaat is een contactlijst met op elke rij een echt mens. Heeft de persona-waterfall zijn werk gedaan, dan verrijkt de tweede waterfall de contactgegevens op elke rij. Ook hier kiezen we geen enkele enrichment-tool om het daarmee te doen.
We halen elk contact achter elkaar door drie providers. Geen enkele provider dekt een branche meer dan gedeeltelijk, en de data van elke provider veroudert in een ander tempo.
De gecombineerde hit rate van drie providers achter elkaar verslaat de beste losse provider in elke test die we hebben gedaan.
De waterfall die we standaard gebruiken, is LeadMagic, Findymail en FullEnrich. Soms nemen we ook Hunter.io en Snov.io mee. Het gaat er vooral om welke tool op dit moment het beste werk levert.
LeadMagic verrijkt de firmografische gegevens en legt de contactgegevens vast, met de LinkedIn-URL, het zakelijke e-mailadres en de firmografische data die elke rij nodig heeft.
Findymail vangt de contacten op die LeadMagic heeft gemist en voegt daar bulkverificatie aan toe. De dekking is het sterkst bij kleinere bedrijven en EU-domeinen.
FullEnrich is de zwaarste provider in de waterfall, vooral voor telefoonnummers. Het haalt data uit meer dan 15 leveranciers om mobiele nummers in te vullen, plus de lange staart aan randgevallen die de andere twee hebben gemist.
BounceBan, DeBounce, ZeroBounce: de laag voor e-mailverificatie
Heeft de enrichment-waterfall zijn werk gedaan, dan gaan de contacten door de verificatie voordat iemand ze in een sequence zet. De verificatielaag beschermt je afzenderreputatie en behoedt de workflow voor bounces waardoor domeinen binnen een week op blacklists belanden.
Onze standaard in deze laag is BounceBan, die we bij elke campagne verkiezen boven de alternatieven. BounceBan doet de standaardchecks (ongeldig, wegwerpadres, rolgebonden, op een blacklist) en gaat verder in het valideren van catch-all-adressen dan alle alternatieven.
Catch-all-validatie is de categorie die outbound-campagnes op schaal zonder dat iemand het ziet kapotmaakt.
DeBounce en ZeroBounce zijn de alternatieven die we gebruiken als BounceBan niet beschikbaar is, meestal door een storing bij de leverancier of een eis van de klant.
ZeroBounce heeft een catch-all-check op basis van AI die kan wedijveren met die van BounceBan. DeBounce is de goedkoopste van de drie voor eenmalige opschoonrondes op hoog volume.
We hebben gemeten dat BounceBan tot 30% meer bruikbare contacten oplevert dan de alternatieven op lijsten waar catch-all-adressen de overhand hebben. Op een lijst van 50.000 records is dat verschil het verschil tussen een outbound-programma dat werkt en een dat niet werkt.
LeadsFactory schrijft zijn persona-output in dezelfde Clay-tabel die de bedrijvenlijst uit stap 1 bevat. Daarna werken de drie enrichment-providers elke rij af, en de verifier controleert diezelfde rij voordat het contact doorgaat naar de outreach-stap.
Wil je meer over deze laag lezen, ga dan naar ons artikel over diensten en bureaus voor data-enrichment, dat dieper ingaat op het ontwerp van de waterfall.
Stap 3: verstuur de outreach via e-mail en LinkedIn
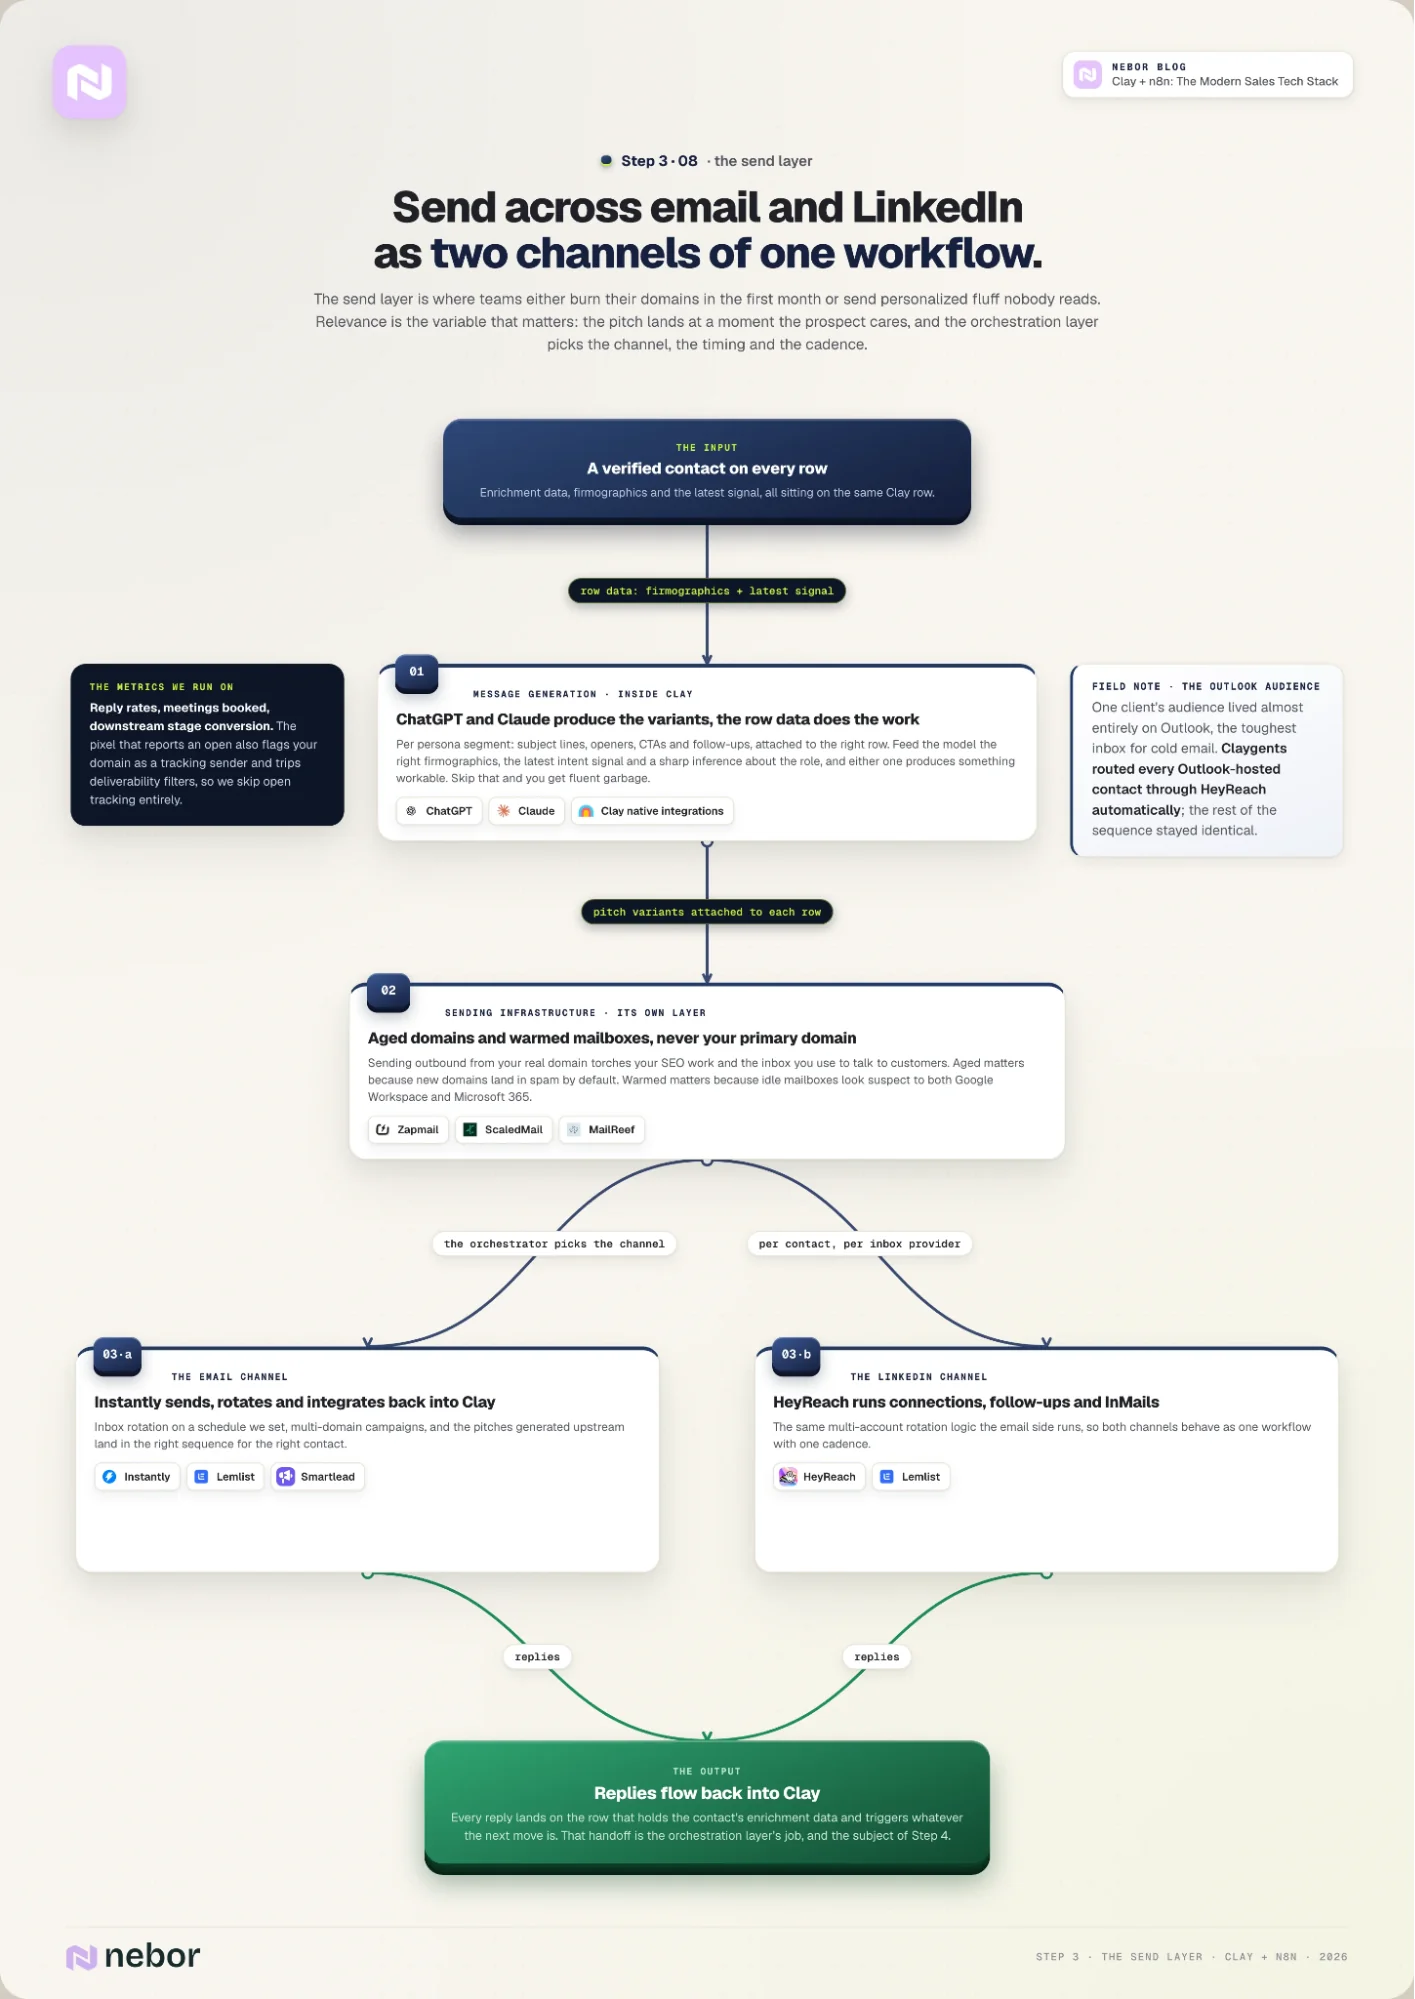
Met een schone en geverifieerde contactlaag is de volgende taak de outreach versturen. In de verzendlaag branden de meeste teams in de eerste maand hun domeinen op, of versturen ze gepersonaliseerde praatjes die niemand leest.
De meeste teams investeren te veel in personalisatie en te weinig in relevantie, en relevantie is de belangrijkste variabele in deze laag.
Personalisatie betekent dat je drie regels schrijft over een recente post van een prospect voordat je je pitch doet. Relevantie betekent dat je pitch aankomt op een moment dat de prospect geeft om wat je verkoopt, ongeacht hoeveel regels naar zijn LinkedIn-activiteit verwijzen.
ChatGPT en Claude: outreach-berichten of pitchvarianten genereren in Clay
We gebruiken ChatGPT en Claude via native integraties om de pitchvarianten automatisch in de Clay-sheets te genereren. Beide zijn prima voor dit werk, en we wisselen als een van de twee een model uitbrengt dat voorloopt.
Belangrijker dan de keuze van het model is de data die we erin stoppen.
Haal je de juiste firmografische data op, het laatste intentiesignaal en een scherpe inschatting van waar de rol van de prospect om geeft, dan levert elk van beide modellen iets bruikbaars op.
Sla je dat over, dan krijg je alleen vloeiende onzin die precies leest als de vloeiende onzin van iedereen.
Uit dezelfde data op elke rij laten we het LLM varianten per personasegment maken, met onderwerpregels, openingszinnen, CTA's en follow-ups.
We koppelen elke variant aan de juiste rij in de Clay-tabel en zetten hem via de orkestratielaag door naar de verzender die de workflow voor dat contact heeft gekozen.
Zapmail, ScaledMail, MailReef: oudere domeinen en opgewarmde mailboxen
Niets hiervan werkt als de verzendinfrastructuur op het hoofddomein van het bedrijf draait. Outbound versturen vanaf je echte domein is de manier om je SEO-werk op te blazen, op spam-blacklists te belanden en de inbox kwijt te raken die je gebruikt om met klanten te praten.
We gebruiken Zapmail, ScaledMail of MailReef om oudere verzenddomeinen en opgewarmde mailboxen te kopen voor zowel Google Workspace als Microsoft 365.
De leeftijd telt, omdat nieuwe domeinen standaard in de spam belanden. Het opwarmen telt ook, omdat mailboxen zonder recente activiteit verdacht lijken voor beide providers (Google Workspace en Microsoft 365).
In onze gids over e-maildeliverability gaan we dieper op deze laag in. De korte versie is dat de verzendinfrastructuur een eigen laag van de stack is en dezelfde zorg krijgt als de contactlaag erboven.
Instantly, Lemlist, Smartlead: de laag voor het versturen van e-mail
Aan de e-mailkant versturen we via Instantly, met Lemlist en Smartlead als alternatieven als de opzet van een klant dat vraagt.
Ze roteren allemaal inboxen volgens een schema dat we kunnen instellen, ondersteunen campagnes over meerdere domeinen en integreren met Clay, zodat de pitches die we eerder in de keten hebben gemaakt in de juiste sequence voor het juiste contact belanden.
Wat metrics betreft meten we geen open rates, en we raden je aan dat ook niet te doen. De pixel die een open registreert, is ook de pixel die je verzenddomein markeert als afzender die tracking gebruikt, en daar slaan de deliverability-filters van de meeste grote inboxproviders op aan.
We optimaliseren de outreach-berichten (of pitches, zo je wilt) op reply rates, geboekte meetings en conversie naar latere stages, en dat zijn toch al de metrics die ertoe doen.
HeyReach en Lemlist: de laag voor het versturen via LinkedIn
Voor LinkedIn versturen we via HeyReach of Lemlist. Beide tools regelen connectieverzoeken, vervolgberichten en InMails, met dezelfde rotatielogica over meerdere accounts die we aan de e-mailkant in de e-mailtools gebruiken.
Het idee is dat e-mail en LinkedIn werken als twee kanalen van dezelfde workflow, in plaats van als losse sequences. De orkestratielaag kiest welk kanaal, wanneer en in welk ritme.
Het wanneer is belangrijker dan de meeste teams denken, en we hebben ons standpunt over de timing van outreach in een apart artikel uitgelegd.
We hadden een klant van wie de doelgroep bijna volledig op Outlook zat, en dat is de slechtste inboxprovider voor de deliverability van cold email. We stuurden elk contact met een Outlook-mailbox via HeyReach in plaats van via Instantly, en de rest van de sequence was identiek.
Zonder een orkestratielaag (met Claygents in het midden) die die keuze automatisch maakt, had een SDR twee parallelle campagnes moeten bouwen en moeten onthouden welk contact welke kreeg.
Dit zit allemaal in dezelfde Clay-tabel waarin de contactlaag schreef. De berichten die het LLM maakte, de kanaalkeuze, het verzendmoment, de inboxrotatie en het bijhouden van reacties staan allemaal op de rij met de enrichment-data van het contact en de firmografische gegevens van het bedrijf.
Reactiedata stroomt terug naar Clay en zet de volgende stap voor dat contact in gang. Dat is het werk van de orkestratielaag en het onderwerp van stap 4. Samen vormt dit systeem hoe geautomatiseerde sales prospecting eruitziet als je het van begin tot eind hebt gebouwd.
Stap 4: bouw de orkestratielaag op Clay en n8n
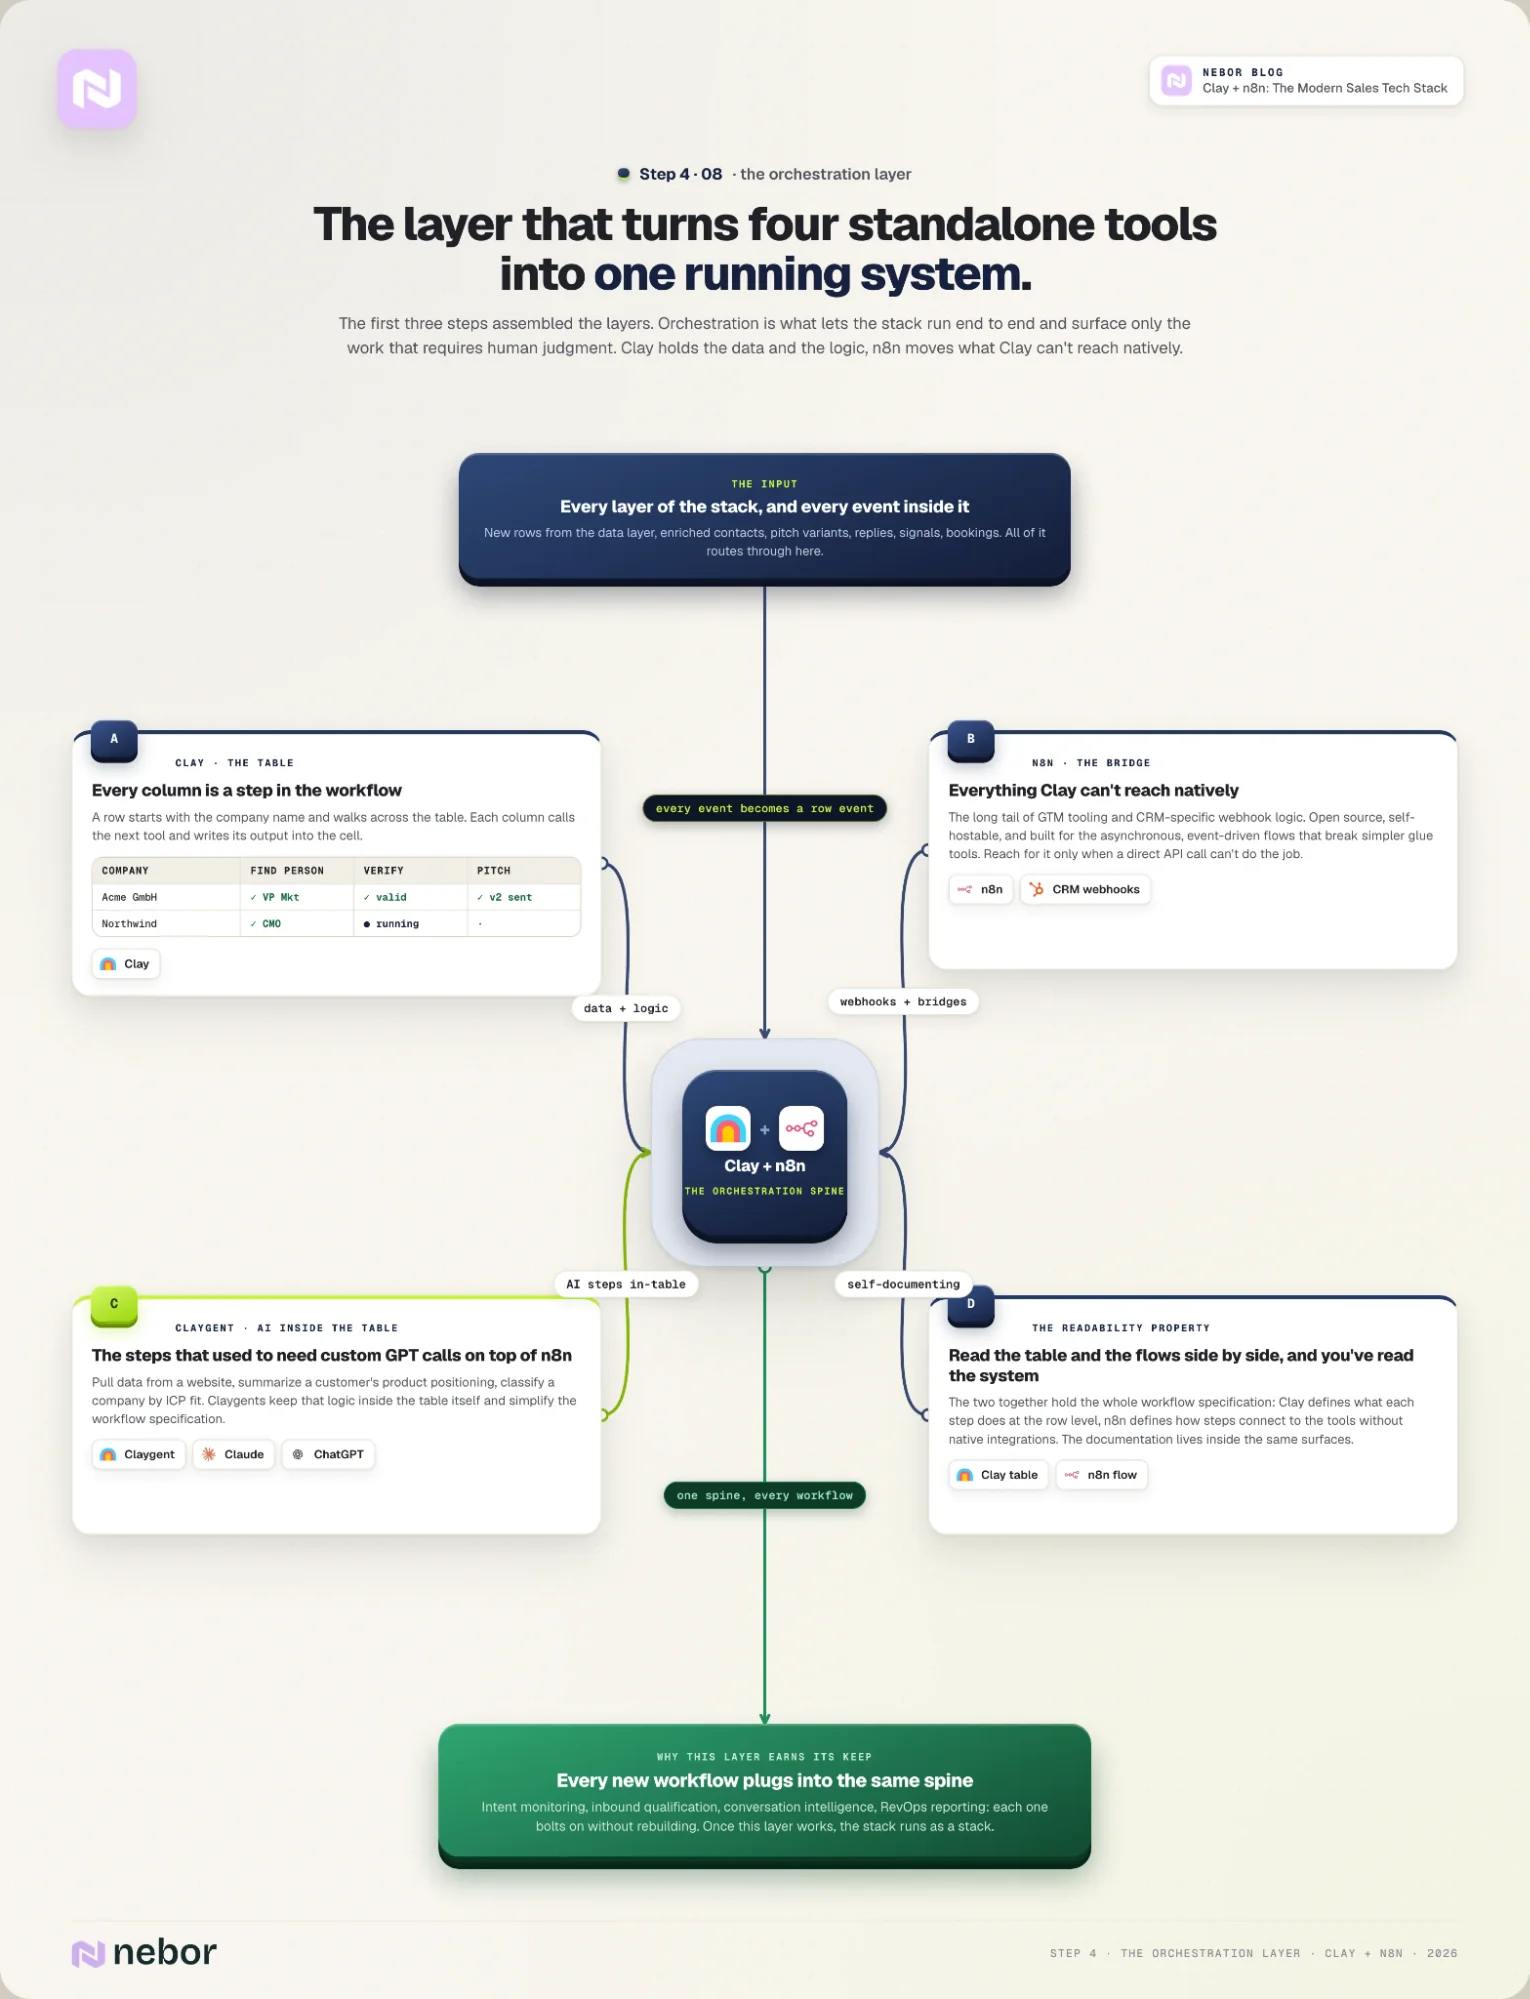
De eerste drie stappen zetten de lagen van de stack neer. De orkestratielaag maakt van die lagen een systeem, in plaats van vier losse tools die tussen elk paar een mens nodig hebben.
Clay houdt de data en de workflowlogica vast. n8n verplaatst data tussen Clay en elke andere tool. Samen laten ze de stack van begin tot eind werken en halen ze alleen het werk naar boven waar menselijk oordeel voor nodig is.
Clay: de tabel met de data en de workflowlogica
Clay is de tabel waarin de data staat en waarin we de workflowlogica bouwen. Elke kolom in een Clay-tabel is een stap in de workflow.
Een rij begint met de bedrijfsnaam uit de databron en loopt de tabel door. Elke kolom roept de volgende tool aan (LeadMagic, BounceBan, het LLM enzovoort) en schrijft de output in de cel.
n8n: de brug voor alles wat Clay niet native bereikt (tegenover Zapier en Make)
n8n is de laag eronder die alles regelt wat Clay niet native kan bereiken. Clay heeft goede native integraties met de meeste grote tools in deze stack, maar de lange staart aan GTM-tools en CRM-specifieke webhooklogica vraagt om een flexibelere brug.
We gebruiken n8n omdat het open source is, zelf te hosten is en de asynchrone, event-gedreven workflows aankan waar Zapier en Make slecht mee overweg kunnen.
Samen bevatten ze de specificatie van de workflow. Clay bepaalt wat elke stap op rijniveau doet. n8n bepaalt hoe die stappen verbinding maken met tools die geen native Clay-integratie hebben.
Lees de Clay-tabel en de n8n-workflow naast elkaar, en je kunt het hele systeem lezen zonder het te vragen aan degene die het heeft gebouwd.
Hier betaalt de combinatie die we eerder noemden zich ook uit. Een Clay-tabel ziet er aan de buitenkant uit als een spreadsheet en werkt eronder als een programmeerbare workflow. Wie er goed een wil bouwen, moet dus in beide modi kunnen denken.
Mensen met beide vaardigheden zijn nog steeds zeldzaam, en daarom lopen Clay-implementaties bij de meeste bureaus die het proberen stuk of vast. We hebben genoeg klanten bij ons zien komen na een eerdere Clay-build die om precies deze reden misging.
Claygent: AI-agents in de Clay-tabel
We noemden het al een paar keer, maar Clay heeft AI-agents die Claygent heten en die in de tabel zelf werken.
Claygent-agents kunnen data van een website halen, de productpositionering van een klant samenvatten of een bedrijf indelen op ICP-fit. Daar was vroeger allemaal met de hand geschreven n8n-logica voor nodig.
We gebruiken Claygent voor de stappen waarvoor we vroeger een eigen GPT-call bovenop n8n nodig hadden. Het vereenvoudigt de specificatie van de workflow en houdt meer logica binnen één tool.
Clay en n8n zijn samen de reden dat de rest van de stack zich als stack gedraagt, en niet als een lijst tools. Werkt deze laag eenmaal, dan sluit elke nieuwe workflow die je toevoegt aan op dezelfde orkestratieruggengraat, zonder dat je opnieuw hoeft te bouwen.
Dat geldt voor de intent-monitoring in stap 5, de inbound-kwalificatie in stap 6, de conversation intelligence in stap 7 en de RevOps-rapportage in stap 8.
Dezelfde logica geldt voor het van begin tot eind automatiseren van je leadgeneratie-pipeline, en daar komen de meeste klanten in eerste instantie voor bij ons.
Stap 5: bouw intent-monitoring voor nieuwe logo's (gloednieuwe klantaccounts) en expansion-accounts
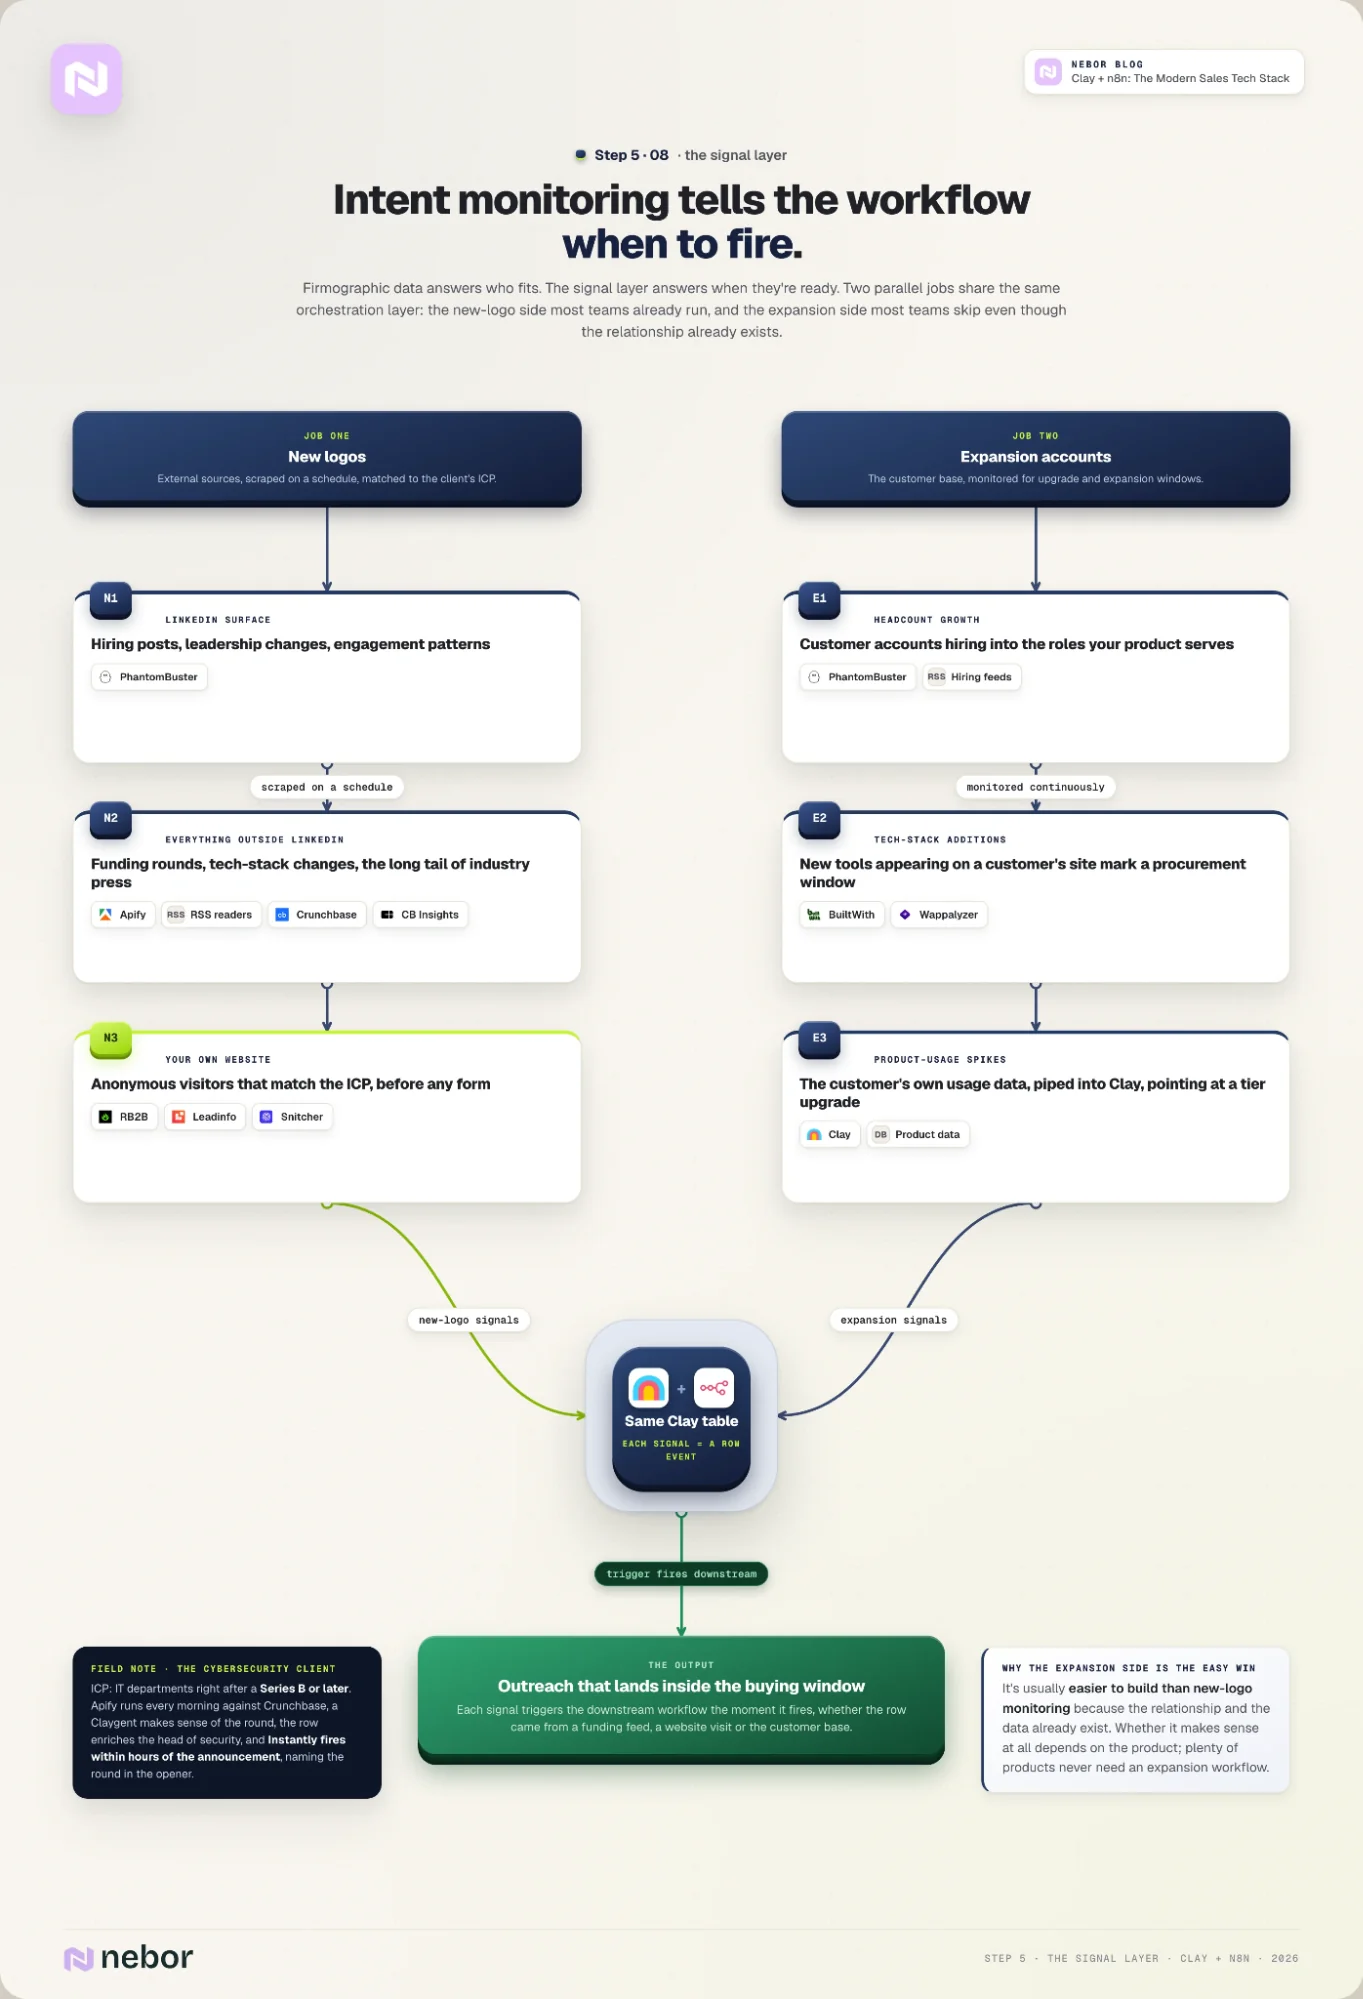
De signaallaag vertelt de workflow wanneer hij in actie moet komen. Firmografische data beantwoordt de vraag wie er past, en laat de vraag open wanneer ze er klaar voor zijn.
De signaallaag is het deel van de stack dat die tweede vraag afdekt. Zonder die laag stuur je outreach naar de juiste accounts op willekeurige momenten en hoop je dat een paar ervan toevallig in de markt zijn.
We zien de signaallaag als twee parallelle taken die dezelfde orkestratielaag delen. De kant van de nieuwe logo's is de versie die de meeste teams al bouwen, vaak als onderdeel van signal-based outbound-campagnes.
De expansion-kant slaan de meeste teams over, terwijl die meestal makkelijker te bouwen is omdat de relatie met het account al bestaat.
De kant van nieuwe logo's: PhantomBuster, Apify en RSS-readers voor externe intentie
Aan de kant van nieuwe logo's is de build eenvoudig zodra Clay en n8n staan. We kiezen de signaalbronnen die bij het ICP van de klant passen, scrapen ze volgens een schema en schrijven elke nieuwe gebeurtenis in de Clay-tabel die de rest van de workflow afhandelt.
De bronnen verschillen per klant, en dat is juist het punt van dit werk. PhantomBuster scrapet LinkedIn op vacatures, wisselingen in het leiderschap of patronen in content-engagement bij doelaccounts.
Voor alles buiten LinkedIn leunen we op Apify en RSS-feedreaders. Beide kunnen financieringsnieuws uit Crunchbase of CB Insights halen, wijzigingen in de tech stack uit BuiltWith of Wappalyzer, en alles wat verder publiek op het web staat.
Met RSS-feedreaders dekken we de lange staart aan vakpublicaties zonder nette API's af. We hebben de workflow voor RSS-monitoring uitgebreid beschreven.
RB2B, Leadinfo, Snitcher: identificatie van websitebezoekers
De tools voor websitebezoekers (RB2B, Leadinfo, Snitcher) horen ook in deze laag. Ze identificeren anonieme bezoekers die bij het ICP passen en zetten het bezoek in Clay, nog voordat de bezoeker een formulier invult.
Dit behandelen we ook in onze artikelen over de workflow voor het tracken van websitebezoekers en een paar voorbeelden van workflows voor websitebezoekers.
Hier is een concreet voorbeeld van de kant van nieuwe logo's. We hadden een klant in cybersecurity met als ICP de IT-afdelingen van bedrijven die net een Series B of latere ronde hadden opgehaald, vanuit het idee dat financieringsrondes het betrouwbaarste signaal zijn dat er securitybudget aankomt.
We stelden Apify zo in dat het elke ochtend Crunchbase controleert en elke nieuwe ronde in Clay zet. Daar zetten we een claygent in om de data te duiden, waarna de workflow het bedrijf en de head of security verrijkt in dezelfde kolomstructuur als in stap 4.
Is die fase doorlopen en alles gecontroleerd, dan zetten we die data door naar Instantly, dat binnen een paar uur na de bekendmaking de sequence verstuurt, met in de opening de nieuwe ronde en de data die we in Clay over ze hebben verzameld.
De expansion-kant: PhantomBuster, RSS, BuiltWith, Wappalyzer plus productgebruiksdata van klanten
De expansion-kant gebruikt dezelfde orkestratielaag met andere input. Houd er rekening mee dat dit alleen zinvol is afhankelijk van het type product. Voor veel producten hoeven we geen workflow voor expansion of upsells te bouwen.
Toch monitoren we in dat geval, in plaats van externe bronnen te volgen voor nieuwe accounts die bij het ICP passen, het klantenbestand op signalen dat een bestaand account klaar is voor een upgrade, een uitbreiding of een nieuwe productlijn.
Welke expansion-signalen je moet volgen, verschilt per product, maar een paar patronen zien we bij de meeste klanten terug.
De betrouwbaarste zijn groei in het aantal medewerkers bij klantaccounts, toevoegingen aan de tech stack die op een inkoopmoment wijzen, en pieken in productgebruik uit de eigen data van de klant die op een upgrade naar een hoger pakket wijzen.
Voor het signaal rond personeelsgroei gebruiken we PhantomBuster op LinkedIn en RSS op vacatureberichten. Voor toevoegingen aan de tech stack leunen we op BuiltWith en Wappalyzer. Het gebruikssignaal komt uit de eigen productdata van de klant, die naar Clay wordt doorgezet.
We hebben een apart artikel geschreven over wat als intent data telt en hoe je eraan komt, dat dieper op de indeling ingaat dan dit deel.
Elke signaalbron in deze stap schrijft in dezelfde Clay-tabel waarin stap 1 tot en met 3 schreven. De orkestratielaag behandelt elk signaal als een rij-event dat de workflow verderop in gang zet.
Dat geldt of de rij nu uit een firmografische databron komt, uit de identificatie van een websitebezoeker of uit een expansion-trigger in het klantenbestand. Stap 6 pakt de inbound-kant van dezelfde orkestratielaag op.
Stap 6: sluit inbound aan op dezelfde workflow die je voor outbound hebt gebouwd
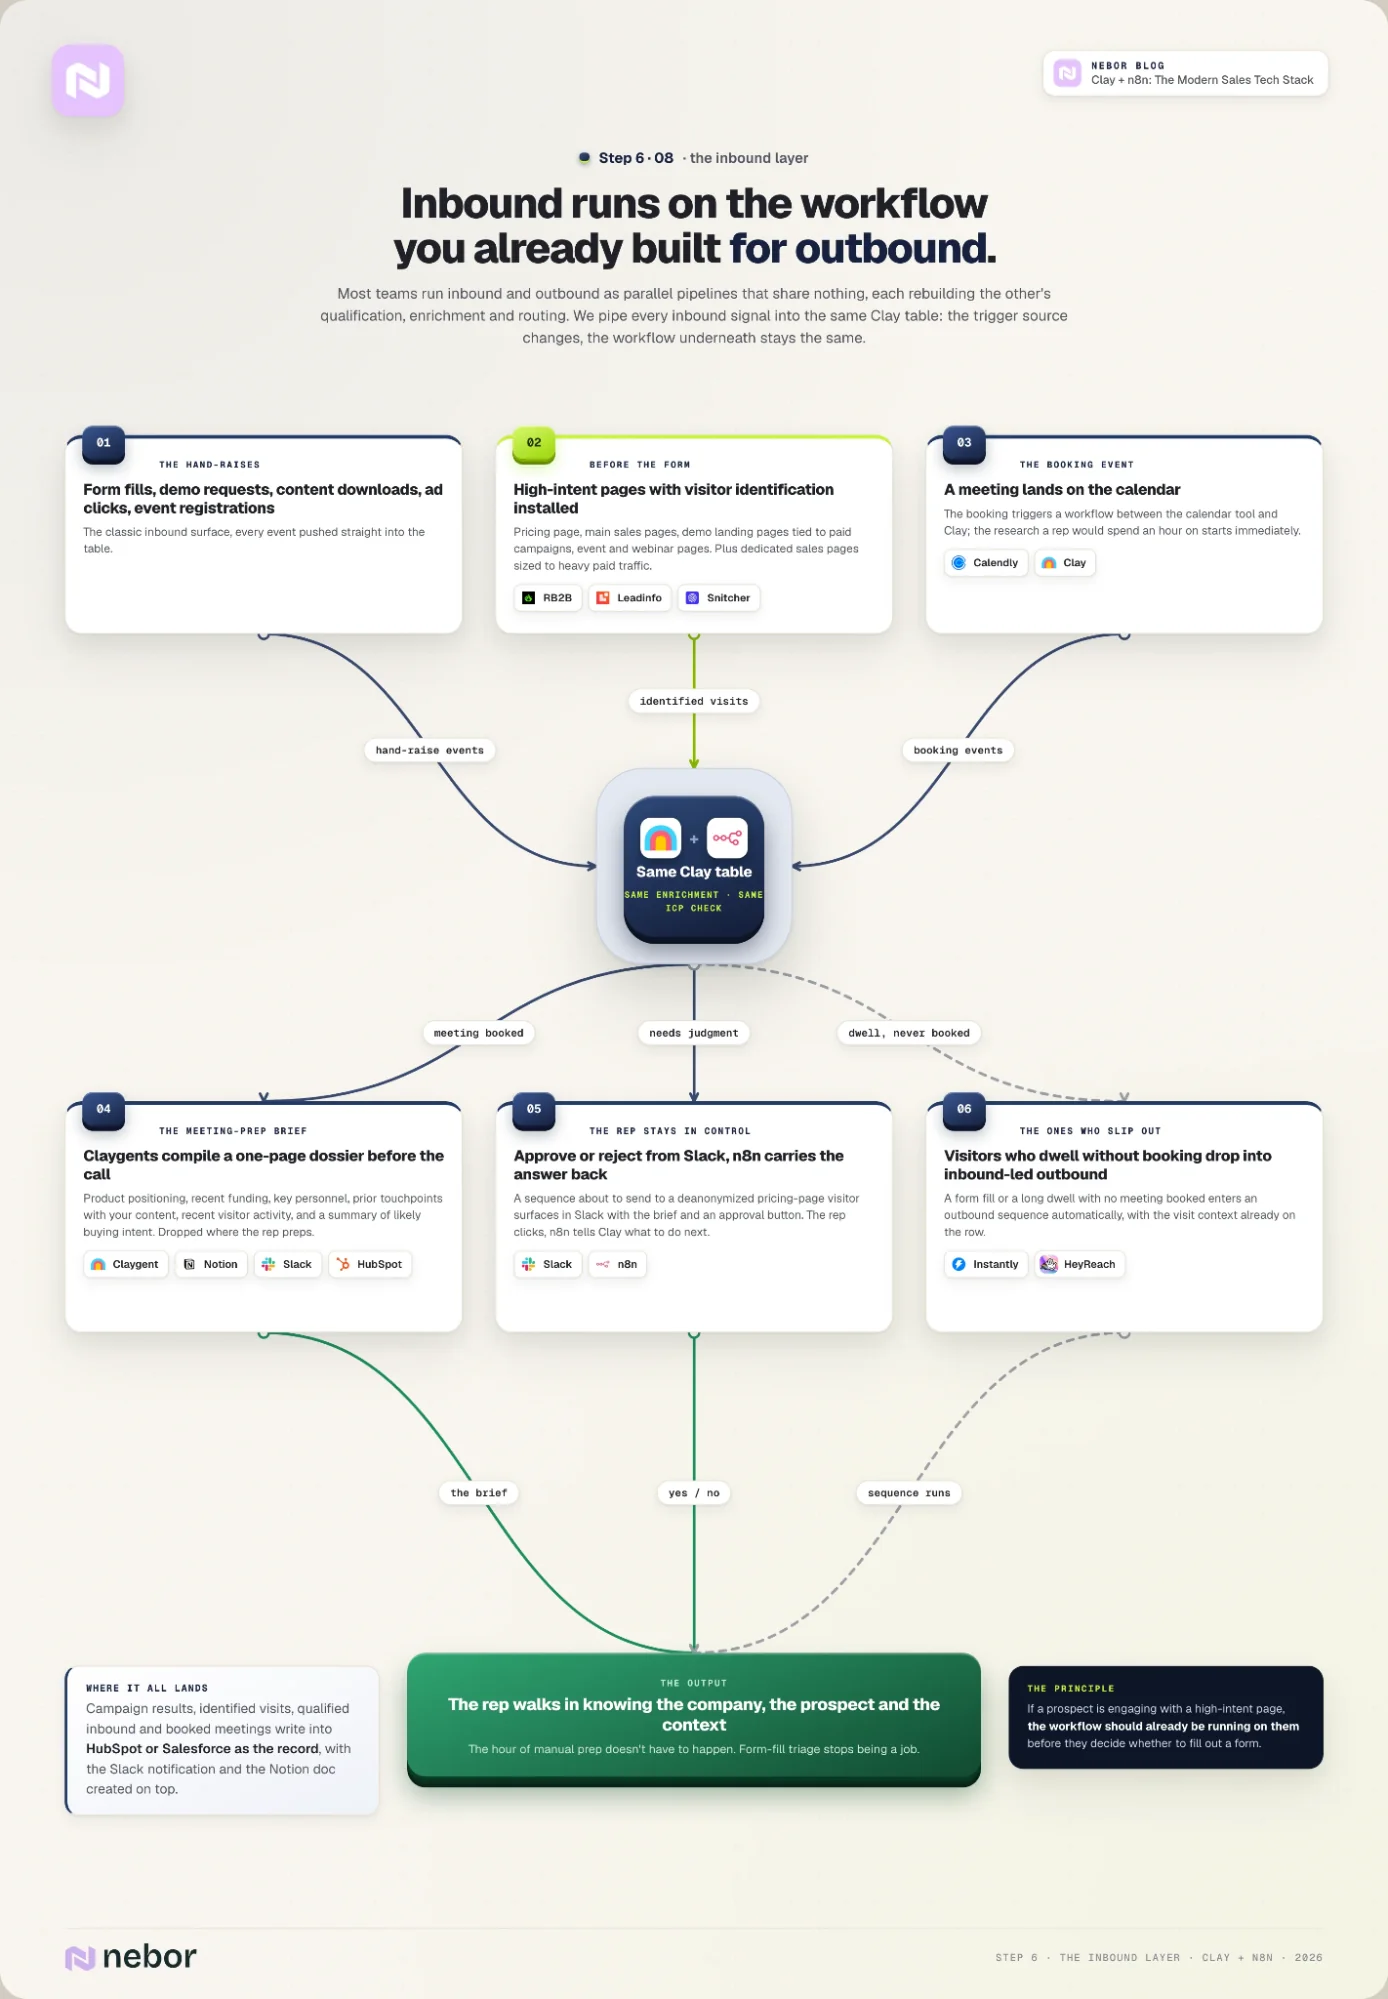
Eén Clay-tabel voor de kwalificatie en routing van inbound en outbound
De inbound-kant van de stack gebruikt dezelfde orkestratielaag als outbound, met andere input.
Inbound begint bij een prospect die op de een of andere manier al zijn hand heeft opgestoken, via een ingevuld formulier, een demo-aanvraag, een bezoek aan de prijspagina, een download van content, een klik op een advertentie of een aanmelding voor een event.
De meeste teams behandelen inbound en outbound als parallelle pipelines die niets delen. Het team dat inbound doet, bouwt eigen kwalificatielogica, een eigen enrichment-proces en eigen routingregels.
Het outbound-team bouwt aan zijn eigen kant hetzelfde nog een keer, omdat de twee systemen niet met elkaar kunnen praten.
Wij zetten elk inbound-signaal in dezelfde Clay-tabel die de outbound-workflow bevat. De bron van de trigger verandert, maar de workflow eronder blijft hetzelfde. De enrichment die stap 2 op outbound-contacten toepast, geldt ook voor inbound-contacten.
De ICP-classificatie werkt op dezelfde manier, en de workflow stelt de overdrachtsbriefing op dezelfde manier samen, hoe de meeting ook binnenkwam. Door die opzet hoeft het inbound-team formulieren niet meer met de hand te sorteren.
RB2B, Leadinfo, Snitcher op de pagina's met hoge intentie: inbound vastleggen vóór het formulier
Veel inbound-verkeer met hoge intentie komt überhaupt nooit bij een formulier. Het lid van het buying committee dat op je prijspagina landt, die vier minuten leest en het tabblad sluit, is precies de prospect met wie je wilt praten, maar een workflow die op een aanmelding of formulier wacht, raakt die persoon meestal kwijt.
De tools voor het identificeren van websitebezoekers uit stap 5 (RB2B, Leadinfo, Snitcher) dichten dat gat. We installeren ze op de pagina's die op intentie wijzen, meestal de prijspagina, de belangrijkste salespagina, de demo-landingspagina's van betaalde campagnes en pagina's van events of webinars die geconcentreerde pieken in verkeer opleveren.
Voor klanten met veel betaald verkeer en demand generation maken we soms aparte salespagina's naast de bestaande site, afgestemd op het intentieprofiel van de campagne, en ook daar installeren we de identificatietools.
Elk geïdentificeerd bezoek wordt een rij in dezelfde Clay-tabel. De workflow verrijkt het bedrijf van de bezoeker en de persona die we daar belangrijk vinden, voert de ICP-check uit en zet het contact in de outreach-sequence of legt het voor aan de rep die dat segment beheert.
Het principe is hetzelfde als bij stap 5. Bezoekt een prospect een pagina met hoge intentie, dan hoort de workflow al met die persoon bezig te zijn voordat hij besluit of hij een formulier invult.
Claygent, Notion, Slack, HubSpot: de briefing ter voorbereiding en de overdracht aan de rep
En als iemand een meeting met je boekt, stopt de workflow niet bij de agendamelding. De boeking start een workflow die we tussen je agendatool en Clay opzetten, en die het onderzoek doet waar de rep anders een uur handwerk aan kwijt zou zijn.
Clay zoekt de prospect en het bedrijf op. Claygent-agents halen de productpositionering van het bedrijf, recente financiering en de belangrijkste mensen op.
De workflow verzamelt ook eerdere contactmomenten van de prospect met de content van de klant of recente activiteit op de website uit de identificatietools, plus een samenvatting van Claygent over de waarschijnlijke koopintentie op basis van wat er publiek over het account bekend is.
Wat er in de briefing komt, hangt af van het bedrijf en van wat elke klant nodig vindt om de deal te sluiten. De workflow bundelt alles in een briefing van één pagina en zet die op de plek waar de rep het liefst werkt, voordat de meeting begint.
Voor de meeste klanten is dat een Notion-document dat in Slack wordt gedeeld, soms een HubSpot-record met de briefing als bijlage, afhankelijk van waar de rep het grootste deel van zijn voorbereiding doet. Het kan zelfs zo simpel zijn als een spreadsheet.
De rep begint aan de call terwijl hij al weet wat het bedrijf doet, waar de prospect om geeft en welke context de workflow over het account heeft. Het uur aan handmatige voorbereiding dat anders nodig was, valt weg.
We hebben de workflow voor inbound-meetings in een apart artikel beschreven, inclusief de precieze kolomstructuur van de briefing en hoe de workflow die samenstelt.
Alles wat de workflow oplevert, komt terecht in de platforms die de reps overdag al gebruiken. Clay schrijft campagneresultaten, geïdentificeerde bezoeken, gekwalificeerde inbound en geboekte meetings als record in HubSpot of Salesforce, stuurt een Slack-melding met de link naar de briefing en maakt het Notion-document aan als dat nodig is.
Op diezelfde plekken kan de rep de keuze van de workflow goedkeuren of afwijzen. Een campagne die op het punt staat een sequence te sturen naar een gedeanonimiseerde bezoeker van de prijspagina, verschijnt in Slack met de briefing en een goedkeuringsknop. De rep klikt ja of nee, n8n pakt het antwoord op en vertelt Clay wat de volgende stap is.
Dezelfde logica vangt prospects op die weglopen zonder te boeken. Een bezoeker die een formulier invult of lang op de site blijft, maar nooit een meeting boekt, komt in een inbound-led outbound-sequence terecht zonder dat iemand aan de workflow hoeft te komen.
Zo werkt de inbound-kant van begin tot eind, zonder dat het team tien keer per dag van tabblad hoeft te wisselen.
De orkestratielaag doet het meeste werk, en de reps besteden hun tijd aan de meetings in plaats van aan het sorteren van formulieren en de handmatige voorbereiding die daar vroeger aan voorafging.
De inbound- en outbound-workflows staan in dezelfde Clay-tabel en lopen door dezelfde pipeline voor enrichment en overdracht. De signalen die bij de rep aankomen, zien er anders uit. Het werk dat de rep na de call doet, is hetzelfde, en dat is het terrein van stap 7.
Stap 7: voeg conversation intelligence toe en maak van calls workflow-triggers
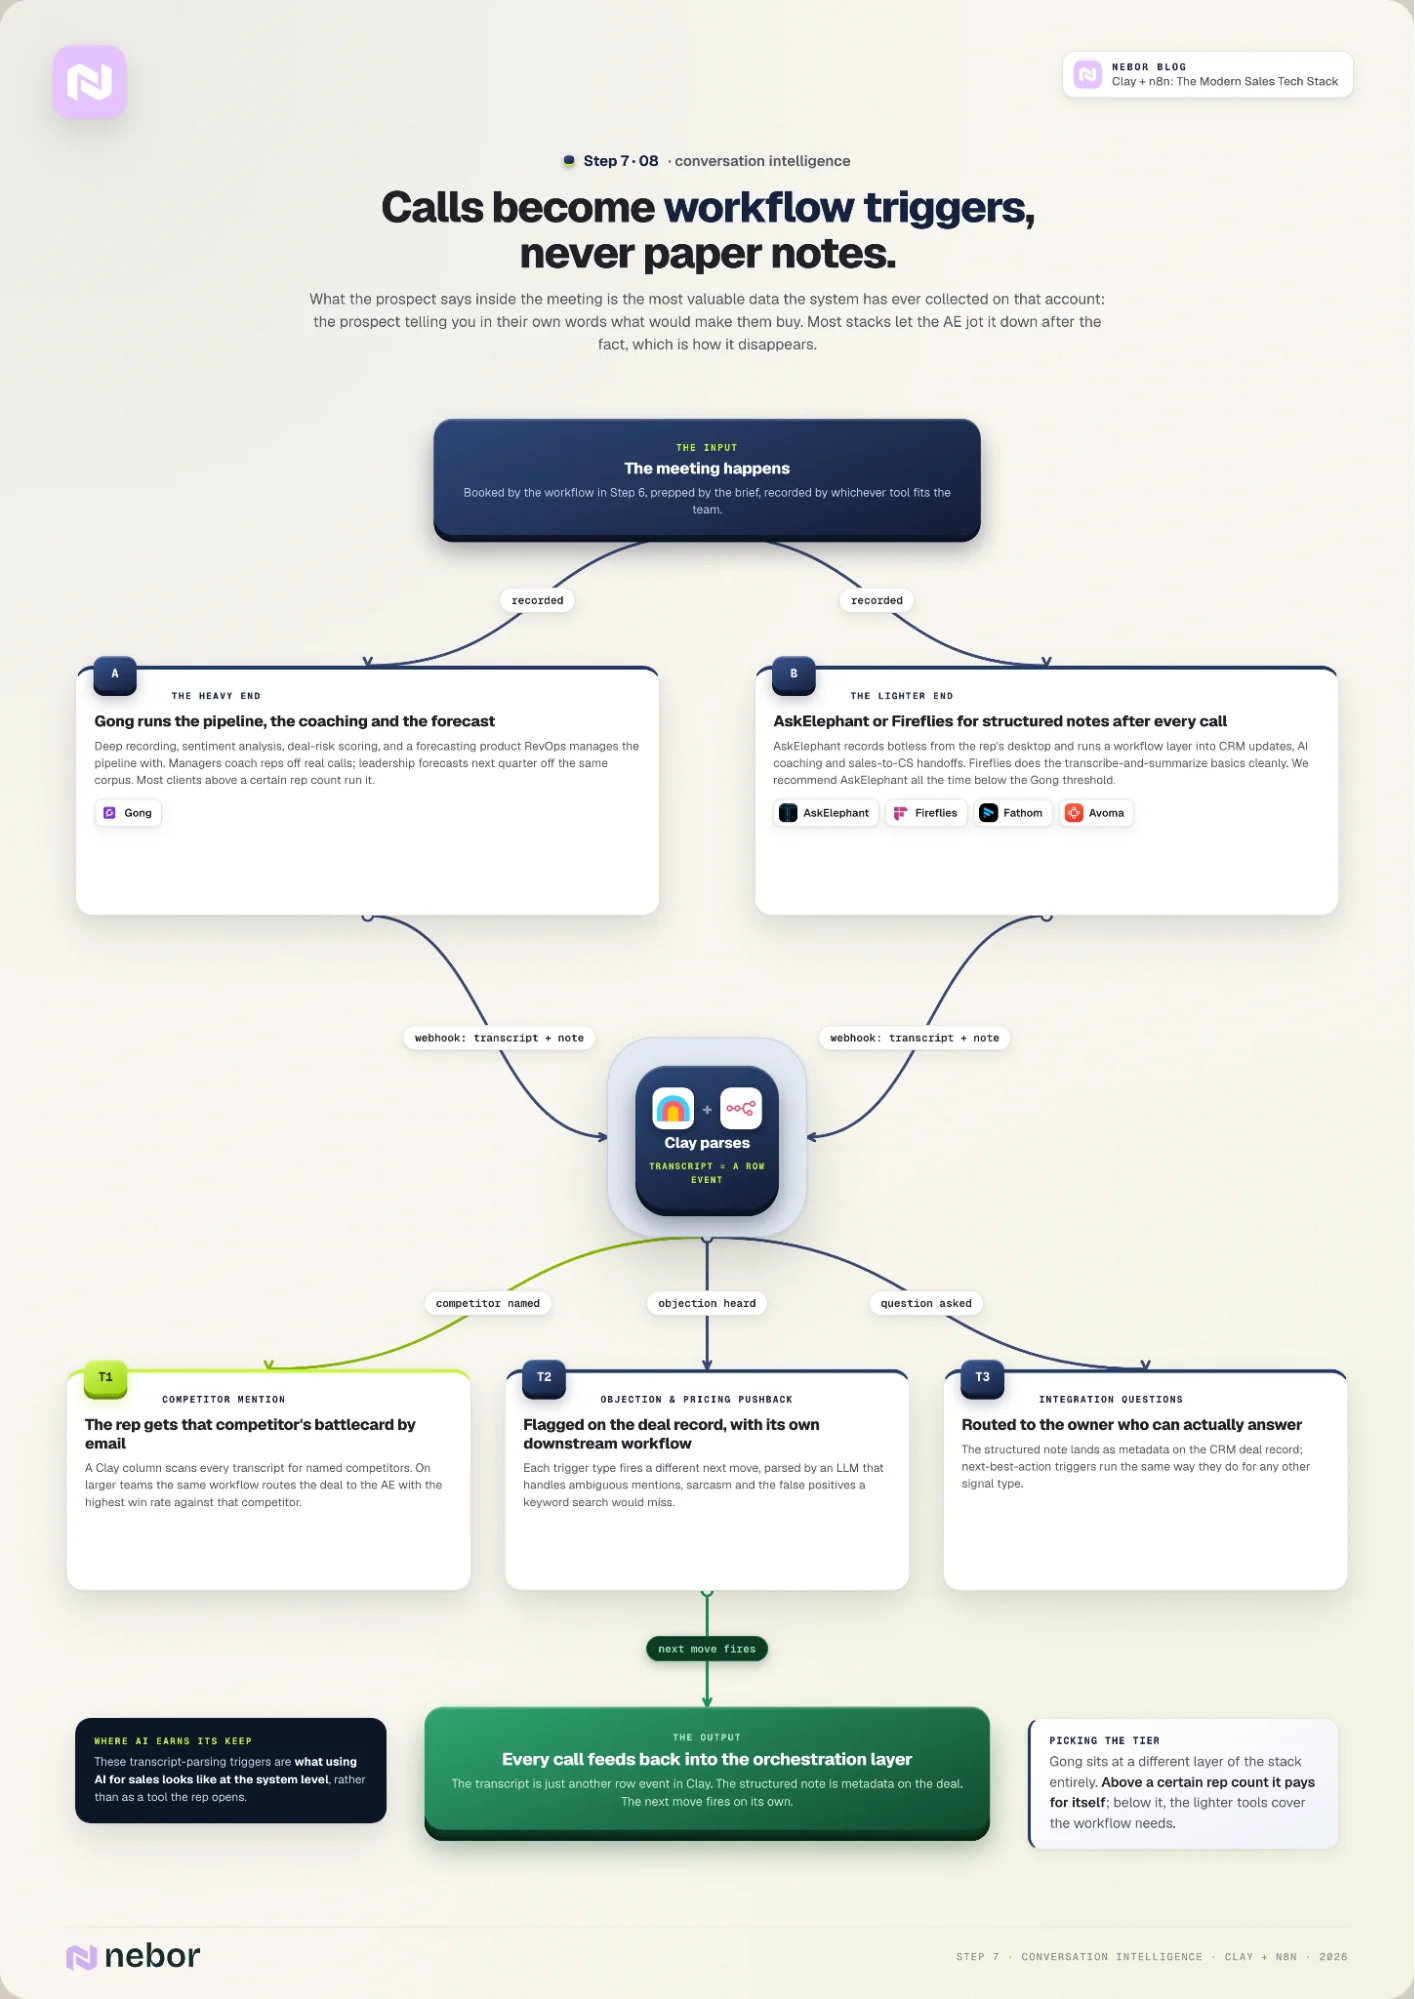
Na de meeting houdt de workflow niet op. Wat de prospect in de meeting zegt, is de waardevolste data die het systeem ooit over dat account heeft verzameld.
Het is de prospect die je in eigen woorden vertelt waar hij om geeft en wat hem over de streep zou trekken. De meeste stacks behandelen die data als papieren aantekeningen die de AE achteraf neerkrabbelt, en zo verdwijnt ze.
Tools voor conversation intelligence vallen in twee kampen die verschillende problemen oplossen.
Gong: de zware kant van conversation intelligence
Gong is met ruime afstand de zwaarste van het stel, met uitgebreide opnames, sentimentanalyse, scoring van dealrisico en een forecastingproduct waarmee het RevOps-team de pipeline beheert.
AskElephant, Fireflies, Fathom, Avoma: de lichtere kant van de markt voor conversation intelligence
AskElephant, Fireflies, Fathom en Avoma zitten aan de lichtere kant van de markt. De rep krijgt na elke call een gestructureerde set aantekeningen, en de beter geïntegreerde tools zetten die data automatisch door naar het CRM en de workflowlaag.
Aan de lichtere kant van de markt raden we AskElephant of Fireflies aan, afhankelijk van je huidige opzet.
AskElephant biedt opname op de desktop zonder bot tijdens de call. Er komt geen bot bij de call. De computer van de rep luistert gewoon mee met de audio die wordt afgespeeld.
Daarbovenop voegt AskElephant een workflowlaag toe die calldata koppelt aan CRM-updates, AI-coaching en de overdracht van sales naar CS.
Fireflies ligt dichter bij de traditionele bot die transcribeert en samenvat. Het doet de basis goed en integreert netjes met de meeste stacks waarin we werken.
Gong zit in een heel andere laag van de stack. RevOps gebruikt het om de pipeline te beheren en managers gebruiken het om reps te coachen op basis van echte calls. Het leiderschap gebruikt dezelfde verzameling opnames bij de forecast voor het volgende kwartaal.
De meeste van onze klanten boven een bepaald aantal reps hebben Gong, en de meeste daaronder gebruiken de lichtere tools. Wij raden dan steevast AskElephant aan.
Calldata terugzetten in Clay als workflow-triggers
De echte workflow zit na de tool die de call heeft vastgelegd. Na elke meeting zetten onze webhooks de transcriptie en de gestructureerde aantekening terug in Clay en het CRM, en de orkestratielaag doorzoekt beide op triggers die voor ons tellen.
Een trigger die we vaak bouwen, is het herkennen van concurrenten die worden genoemd. De Clay-kolom scant elke transcriptie op namen van concurrenten, en zodra er een voorbijkomt, start een workflow die de rep een battlecard voor die specifieke concurrent mailt.
Dezelfde workflow kan de deal ook doorzetten naar de AE in het team met de hoogste win rate tegen die concurrent, als het team groot genoeg is voor specialisten.
Het patroon werkt ook voor het herkennen van bezwaren, signalen van weerstand tegen de prijs en het doorsturen van vragen over integraties. Elke trigger start een andere workflow verderop.
Bij deze triggers die transcripties uitpluizen, gaan AI-salestools zich terugbetalen, omdat het LLM dat het uitpluizen doet, moet omgaan met dubbelzinnige vermeldingen, sarcasme en valse positieven die een zoekopdracht op trefwoorden zou missen.
Elk gesprek dat in het systeem plaatsvindt, stroomt op dezelfde manier terug naar de orkestratielaag als de inbound- en outbound-signalen. De transcriptie is gewoon nog een rij-event in Clay.
De gestructureerde aantekening is metadata op het dealrecord in het CRM. De triggers voor de next best action werken op dezelfde manier als bij elk ander type signaal.
Zo ziet AI voor sales er grotendeels uit op systeemniveau, in plaats van als een tool die de rep opent. Stap 8 sluit de cirkel aan de RevOps-kant, waar al deze data zich eindelijk uitbetaalt.
Stap 8: sluit de cirkel met pipelinehygiëne, een RevOps-ruggengraat en rapportage
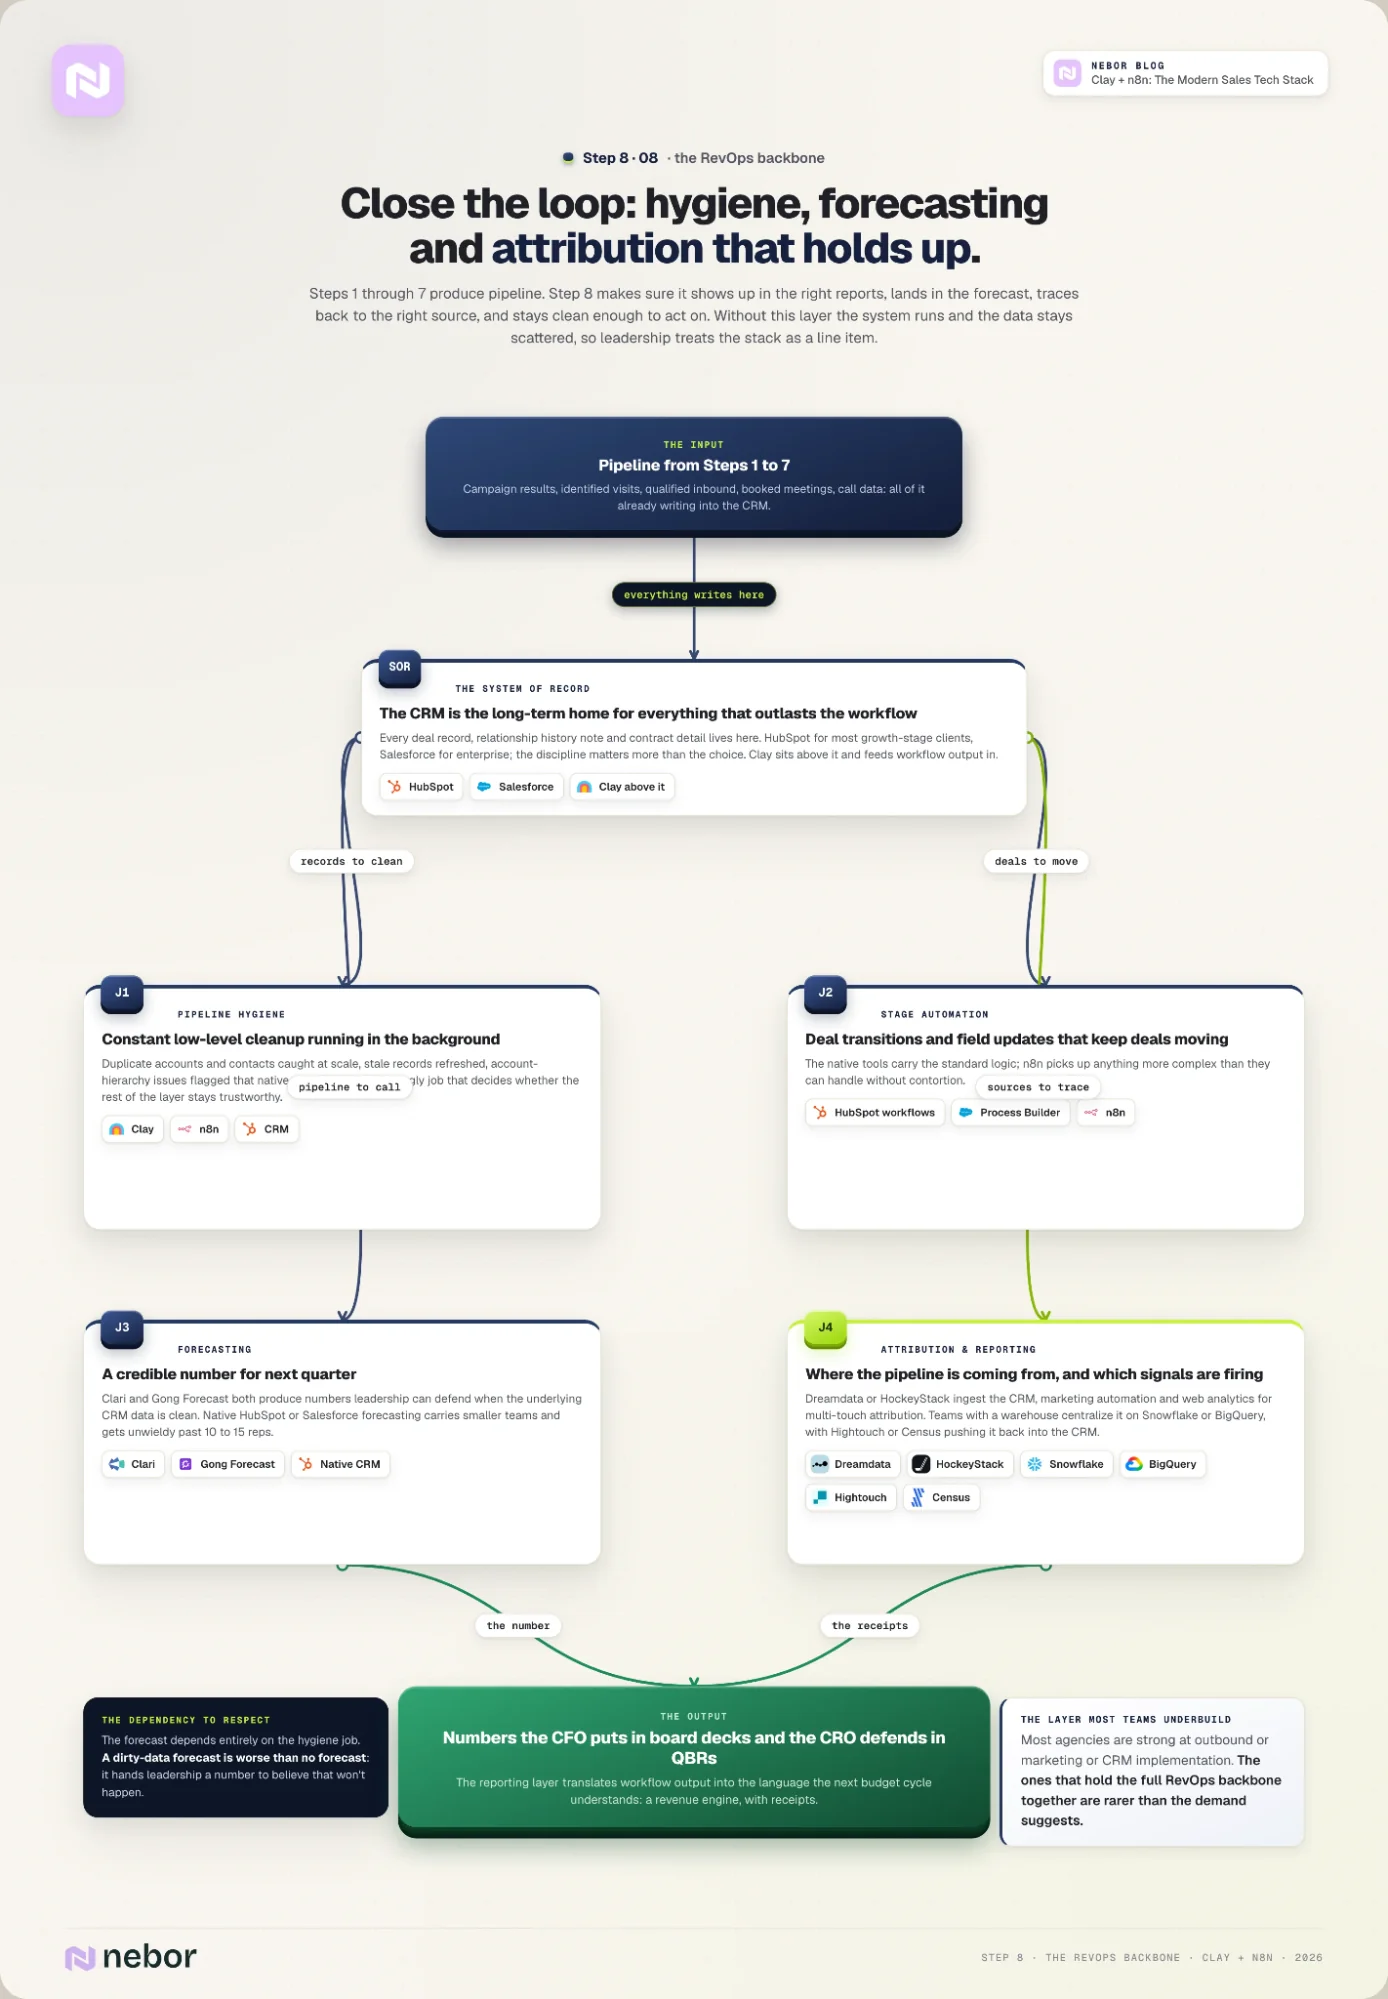
De zeven stappen hierboven bouwen allemaal workflows die pipeline opleveren. Stap 8 zorgt dat die pipeline in de juiste rapportages verschijnt, in de forecast belandt, terug te voeren is naar de juiste bron en schoon genoeg blijft om er iets mee te doen.
Zonder deze laag werkt het systeem, maar blijft de data verspreid. Het leiderschap ziet nooit welke bronnen impact hebben, en in de volgende budgetronde wordt de stack behandeld als kostenpost in plaats van als de omzetmotor die hij is.
In deze laag lopen vier taken tegelijk. Je krijgt:
pipelinehygiëne die de data schoon en de records kloppend houdt
automatisering van CRM-stages, die de overgangen van deals regelt en de veldupdates doet die deals in beweging houden
forecasting die je leiderschap een geloofwaardig getal voor het volgende kwartaal geeft
attributie en rapportage die het team vertellen waar de pipeline vandaan komt, welke signalen aanslaan en wat werkt
HubSpot en Salesforce: het CRM als system of record
Het CRM is in deze laag het system of record. Elk dealrecord, elke notitie over de relatie en elk contractdetail staat daar voor de lange termijn. Dat behandelden we in stap 4, waar Clay boven het CRM staat en de output van workflows erin zet.
Welk CRM je kiest (HubSpot voor de meeste klanten in de groeifase, Salesforce voor enterprise) telt minder dan de discipline om het te behandelen als de vaste plek voor alles wat langer moet bestaan dan de workflow die het maakte.
CRM + n8n + Clay: workflows voor pipelinehygiëne
Pipelinehygiëne is het vervelende werk dat bepaalt of de rest van de stack betrouwbaar blijft. Dubbele records, verouderde contacten, verkeerde accounthiërarchieën en verlaten dealstages vergiftigen het CRM langzaam, tot de dashboards niet meer kloppen met de werkelijkheid.
De oplossing is een constante, kleine schoonmaak op de achtergrond, in plaats van een schoonmaakproject per kwartaal dat het team steeds naar het volgende kwartaal doorschuift.
We bouwen workflows tussen je CRM, n8n en Clay die dubbele accounts en contacten op schaal opsporen en problemen in de accounthiërarchie signaleren die de native CRM-tools missen.
HubSpot-workflows en Salesforce Process Builder (met n8n): automatisering van stages en veldupdates
Voor de automatisering van stages en de logica voor veldupdates gebruiken we de native workflows van HubSpot of Process Builder van Salesforce. n8n pakt alles op wat complexer is dan de native tools zonder kunstgrepen aankunnen.
Clari, Gong Forecast en de native forecasting van je CRM
De forecastinglaag bepaalt hoe serieus de rest van het bedrijf het getal van het salesteam neemt. Tools als Clari en Gong Forecast leveren allebei geloofwaardige getallen op als de onderliggende CRM-data schoon is (en vallen allebei door de mand als dat niet zo is).
De native forecasting van HubSpot of Salesforce werkt voor kleinere teams die de basisfuncties nog niet zijn ontgroeid, en wordt onhandig voorbij de 10 à 15 reps.
De forecastinglaag hangt volledig af van de hygiënelaag. Een forecast op vuile data is erger dan geen forecast, omdat het leiderschap dan een getal krijgt om in te geloven dat niet laat zien wat er gaat gebeuren.
Attributie is de taak die de meeste teams stil opgeven. De traditionele aanpak (UTM-tags, last-touch-attributie in Google Analytics, met de hand terugkoppelen naar deals in het CRM) breekt op schaal en blijft kapot.
Dreamdata en HockeyStack: moderne multi-touch-attributie
De moderne aanpak gebruikt tools als Dreamdata of HockeyStack om data op te halen uit het CRM, de marketingautomatiseringstool en de website-analytics. Het platform past daarna multi-touch-attributie toe die weergeeft hoe deals in de praktijk sluiten.
Snowflake, BigQuery, Hightouch, Census: attributie vanuit het warehouse voor datateams
Voor bedrijven met een datateam en een bestaand warehouse is het flexibelere patroon om attributie centraal in het warehouse zelf te regelen, op Snowflake of BigQuery. Hightouch of Census zet de attributiedata daarna terug in het CRM en de marketingtools.
Die opzet kost vooraf meer werk, maar levert attributie op waar het datateam op kan vertrouwen en die het leiderschap kan verdedigen.
Hier betaalt de rest van de stack zich uit. Het werk uit stap 1 tot en met 7 levert pipeline op, maar pipeline die niemand geloofwaardig kan toeschrijven, voorspellen of rapporteren, is onzichtbaar voor het leiderschap. De rapportagelaag vertaalt de output van de workflows naar de getallen die de CFO in board decks zet en de CRO in QBR's verdedigt.
Dit is ook de laag die de meeste teams in de groeifase te weinig uitbouwen. Dat is een deel van de reden dat we een aparte vergelijking schreven van de beste RevOps-bureaus in Europa.
De meeste bureaus in die markt zijn sterk in outbound, marketing of CRM-implementatie. De bureaus die de hele RevOps-ruggengraat bij elkaar houden, zijn zeldzamer dan de vraag doet vermoeden.
We hebben nu alle acht stappen tot één systeem verbonden. De data van elke stap voedt de volgende, en de laatste stap sluit de cirkel door de impact zichtbaar te maken.
In een apart artikel hebben we de statistieken over sales-automatisering verzameld die laten zien wat goed gebouwde systemen doen met je top-of-funnel en je conversie. Het komt het dichtst in de buurt van een benchmark voor het werk dat dit artikel beschrijft.
Het overzicht hieronder brengt alle acht stappen samen.
Hoe de acht stappen samen je revenue-pipeline aandrijven en je team efficiënter maken
Het patroon is in alle acht stappen hetzelfde. Elke stap schrijft in dezelfde Clay-tabel, en de n8n-flows eronder verbinden elke stap met de volgende.
Het geheel zit in documentatie die een nieuwe medewerker zes maanden later kan lezen en volgen zonder het te vragen aan degene die het heeft gebouwd. Dat is de test of het systeem een echte stack is, of gewoon een lijst tools die toevallig een scherm met logo's deelt.
We wisselen regelmatig tools in deze stack. De lijst met tools die we in 2026 in dit artikel aanraden, leest in 2027 anders, en in 2028 bijna helemaal anders.
We kunnen elke tool wisselen zonder het systeem te breken, omdat de workflow de eenheid is en de tool vervangbaar. Het maakt de Clay-tabel niet uit welke provider de kolom voor e-mailadressen vult, zolang er iets is dat het doet.
En dit werkt op implementatieniveau alleen omdat de mensen die het bouwen beide helften van het werk kennen.
Eerst verkopers, dan pas automatiseringsexperts.
Die twee vaardigheden samen maken van een verzameling tools een systeem, en de mensen die beide tegelijk beheersen, zijn nog altijd zo zeldzaam dat de rest van de bureaumarkt nog niet is bijgebeend.
Dezelfde logica geldt voor elke bedrijfsgrootte. Een startup met één BDR op het gratis abonnement van Clay, een basis-CRM en LeadMagic krijgt dezelfde workflowlogica als een compleet revenue team dat elke laag hierboven gebruikt. De tools schalen mee, maar het ontwerp van de workflow verandert weinig.
Heb je alle acht stappen gelezen en concludeer je dat dit vooral over Clay en n8n gaat, met een hoop andere tools erbovenop, dan klopt dat.
Het langere antwoord is dat de orkestratielaag van de rest een stack maakt in plaats van een lijst. Die laag goed bouwen is het werk dat een leadgeneratiesysteem op basis van Clay onderscheidt van een Clay-licentie die stof ligt te verzamelen.
We hebben de bredere markt van Clay-bureaus voor sales-automatisering in een apart artikel behandeld, inclusief hoe je er een beoordeelt als je dit niet zelf in huis bouwt.
Er bestaat geen enkele juiste tech stack voor een revenue team, en geen versie van dit artikel is over een jaar nog compleet. De logica eronder blijft hetzelfde, welke tools we dit kwartaal ook gebruiken.
Ontwerp eerst de workflows en kies daarna de tools die ze dragen. Verbind alles met één orkestratielaag en zoek mensen die in beide modi kunnen denken om het te bouwen.
Gerelateerde artikelen


Door op Registreren te klikken bevestig je dat je akkoord gaat met onze Algemene Voorwaarden.