In this post:
Twee mensen in een salesteam kunnen een hele middag discussiëren over welke onderwerpregel beter is. De een zweert bij kort en krachtig, de ander bij een vraag, en ze zijn allebei volkomen zeker van hun zaak, terwijl geen van beiden het weet.
A/B-testen beslecht die discussie met data in plaats van met meningen. Je verstuurt twee versies, meet welke meer reacties krijgt en laat de cijfers beslissen in plaats van de hardste stem in de kamer.
A/B-testen van cold email is het versturen van twee versies van een e-mail die op één onderdeel verschillen, waarna je de resultaten vergelijkt om te zien welke beter presteert. Het vervangt gokken over wat werkt door bewijs.
Wat vaak over het hoofd wordt gezien, is dat het slecht doen erger is dan het helemaal overslaan. Een test op te weinig e-mails levert willekeurige ruis op die eruitziet als een resultaat, waardoor je vol vertrouwen de verkeerde les leert en daar nog verder op inzet.
TL;DR
A/B-testen van cold email betekent dat je twee versies die op één variabele verschillen, zoals de onderwerpregel of de openingszin, naar een vergelijkbaar publiek stuurt en meet welke beter scoort.
De waarde zit erin dat het meningen vervangt door bewijs. In plaats van te raden wat aanslaat, leer je wat je reply rate echt beweegt, en daar bouw je op verder.
De discipline zit in het goed uitvoeren, door één variabele tegelijk te testen, een steekproef te gebruiken die groot genoeg is en te controleren of het resultaat echt is en niet toevallig.
Bij de steekproefgrootte gaat het meestal mis. De reply rates van cold email zijn laag, dus kleine tests leveren ruis op die eruitziet als een signaal, en daardoor leren de meeste losse A/B-tests je de verkeerde les.
Wat is A/B-testen in cold email, en hoe werkt één test precies?
A/B-testen is een simpel idee dat je zorgvuldig toepast. Je maakt twee versies van een e-mail, de A en de B, die identiek zijn op één onderdeel na, en stuurt elke versie naar een vergelijkbare groep.
Dat ene verschil is waar het om draait. Doordat je maar één ding verandert, kun je elk verschil in resultaat aan die ene variabele toeschrijven, in plaats van te gokken tussen een hoop veranderingen tegelijk.
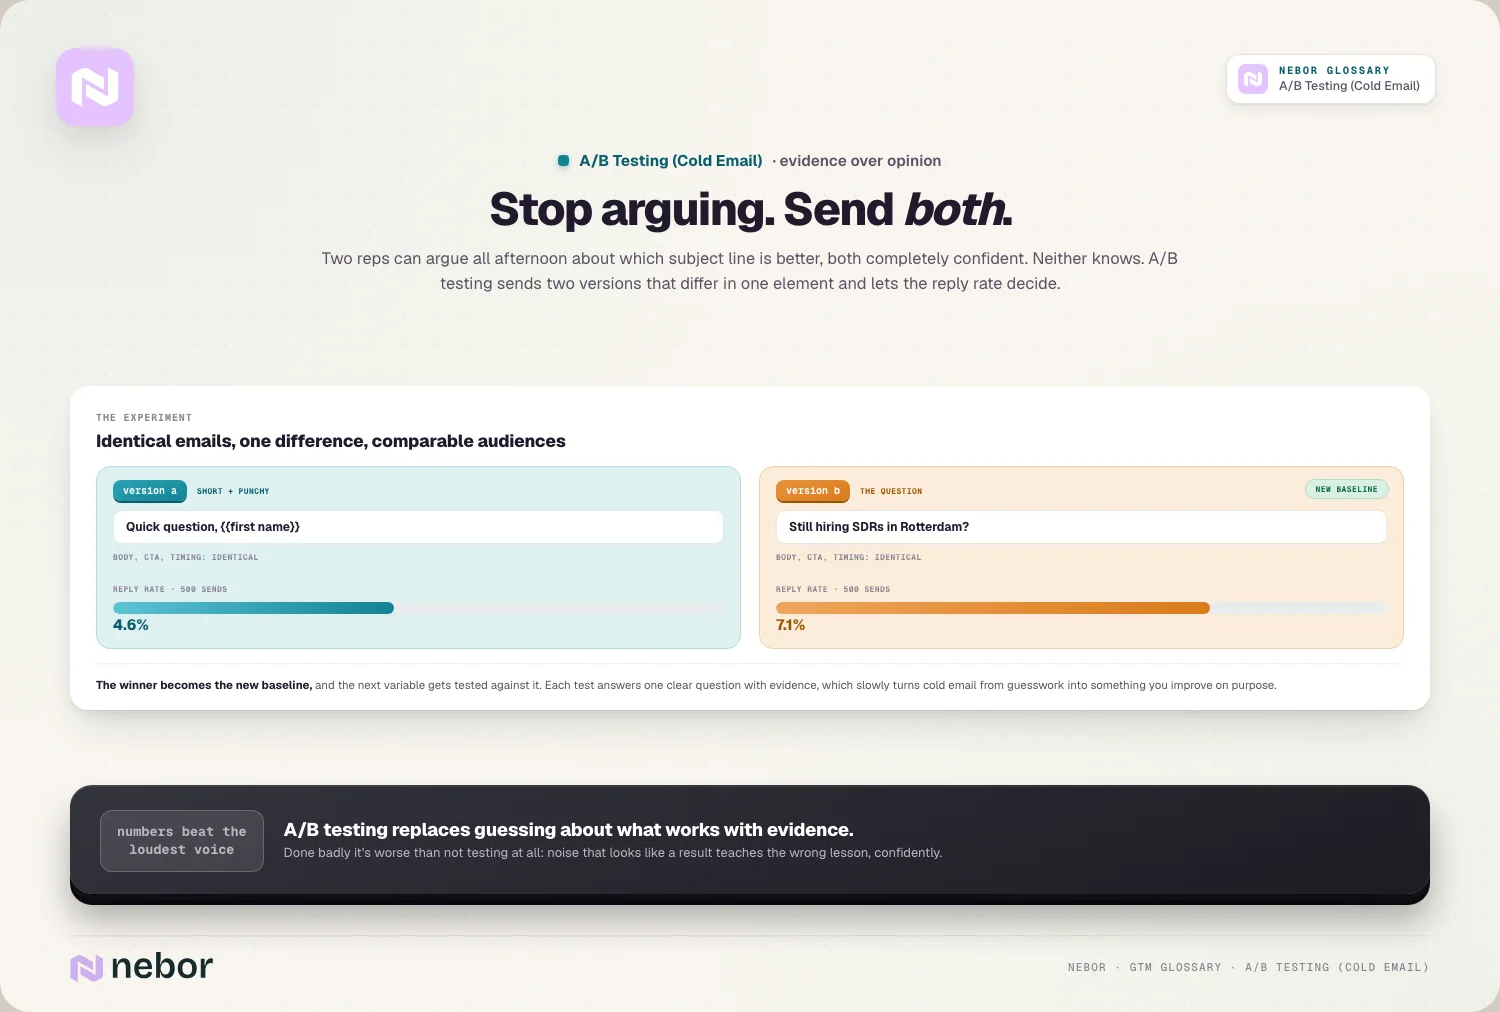
Daarna meet je hoe elke versie heeft gepresteerd. Meestal vergelijk je de reply rate van elke versie, omdat reacties de eerlijkste maatstaf zijn voor of een cold email heeft gewerkt.
De versie die beter presteert wint en wordt je nieuwe basis. Daarna test je de volgende variabele tegen die winnaar, zodat je stap voor stap beter wordt.
A/B-testen is dus in de kern gestructureerd leren. Elke test beantwoordt één duidelijke vraag met bewijs, en zo verandert je cold email langzaam van giswerk in iets wat je actief verbetert.
Wat test je als eerste als alles eraan het testen waard lijkt?
Lang niet alles verdient een test, en als je weet wat het verschil maakt, bespaar je testbudget. Wij zien in cold email steeds weer dezelfde paar onderdelen het zwaarst wegen.
De onderwerpregel is de klassieke plek om te beginnen, omdat die bepaalt of je e-mail wordt geopend, dus het testen van lengte, een vraag tegenover een stelling of personalisatie is een gebruikelijke eerste stap.
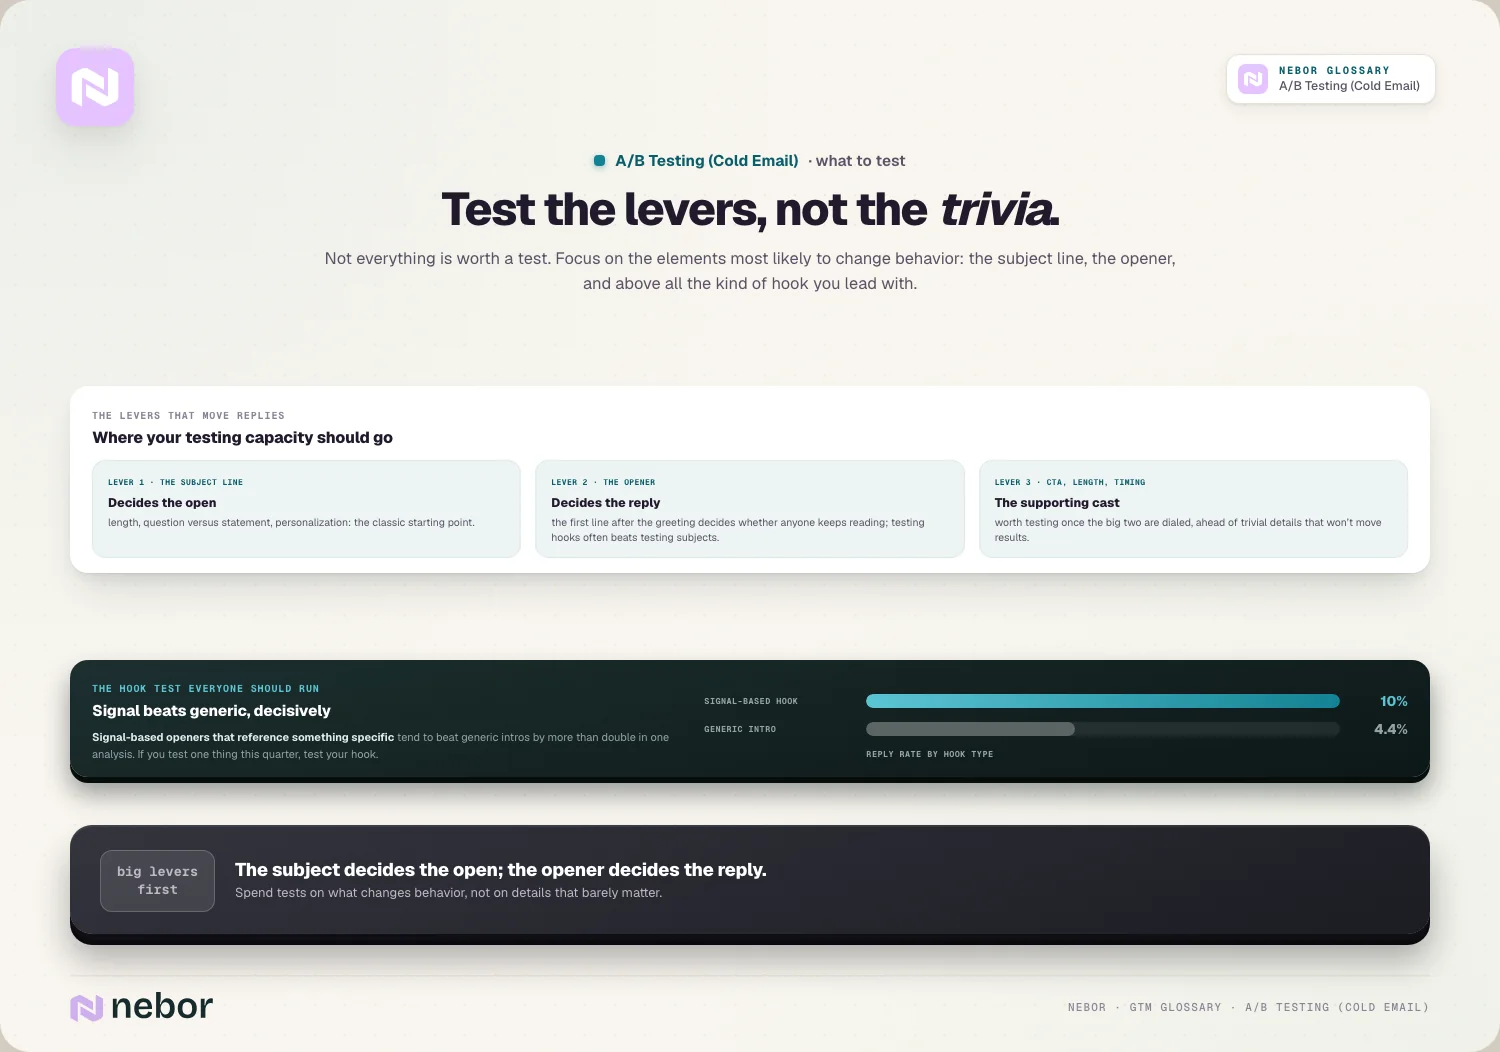
Voor reacties is de openingszin nog belangrijker, omdat de eerste regel na de aanhef bepaalt of iemand verder leest, en het testen van verschillende hooks heeft vaak meer effect dan de onderwerpregel.
Het type hook verdient eigen tests, omdat openingszinnen die op een signaal inspelen en iets specifieks noemen het meestal beter doen dan algemene intro's, met een analyse die zo'n 10% reply rate voor signaal-hooks liet zien tegenover 4,4% voor algemene hooks.
Daarnaast kun je de call to action, de lengte en de timing testen. De regel is dat je je richt op de onderdelen die het gedrag van mensen het meest kunnen veranderen, in plaats van kleine details te testen die je resultaten niet bewegen.
Waarom is het zo belangrijk om één variabele tegelijk te testen?
De meest gemaakte fout bij testen is te veel tegelijk veranderen. Als je begrijpt waarom dat de test breekt, weet je ook hoe je het goed doet.
Als je de onderwerpregel, de openingszin en de call to action allemaal tegelijk verandert en versie B wint, heb je niets bruikbaars geleerd. Je kunt dan niet zien welke verandering het verschil maakte.
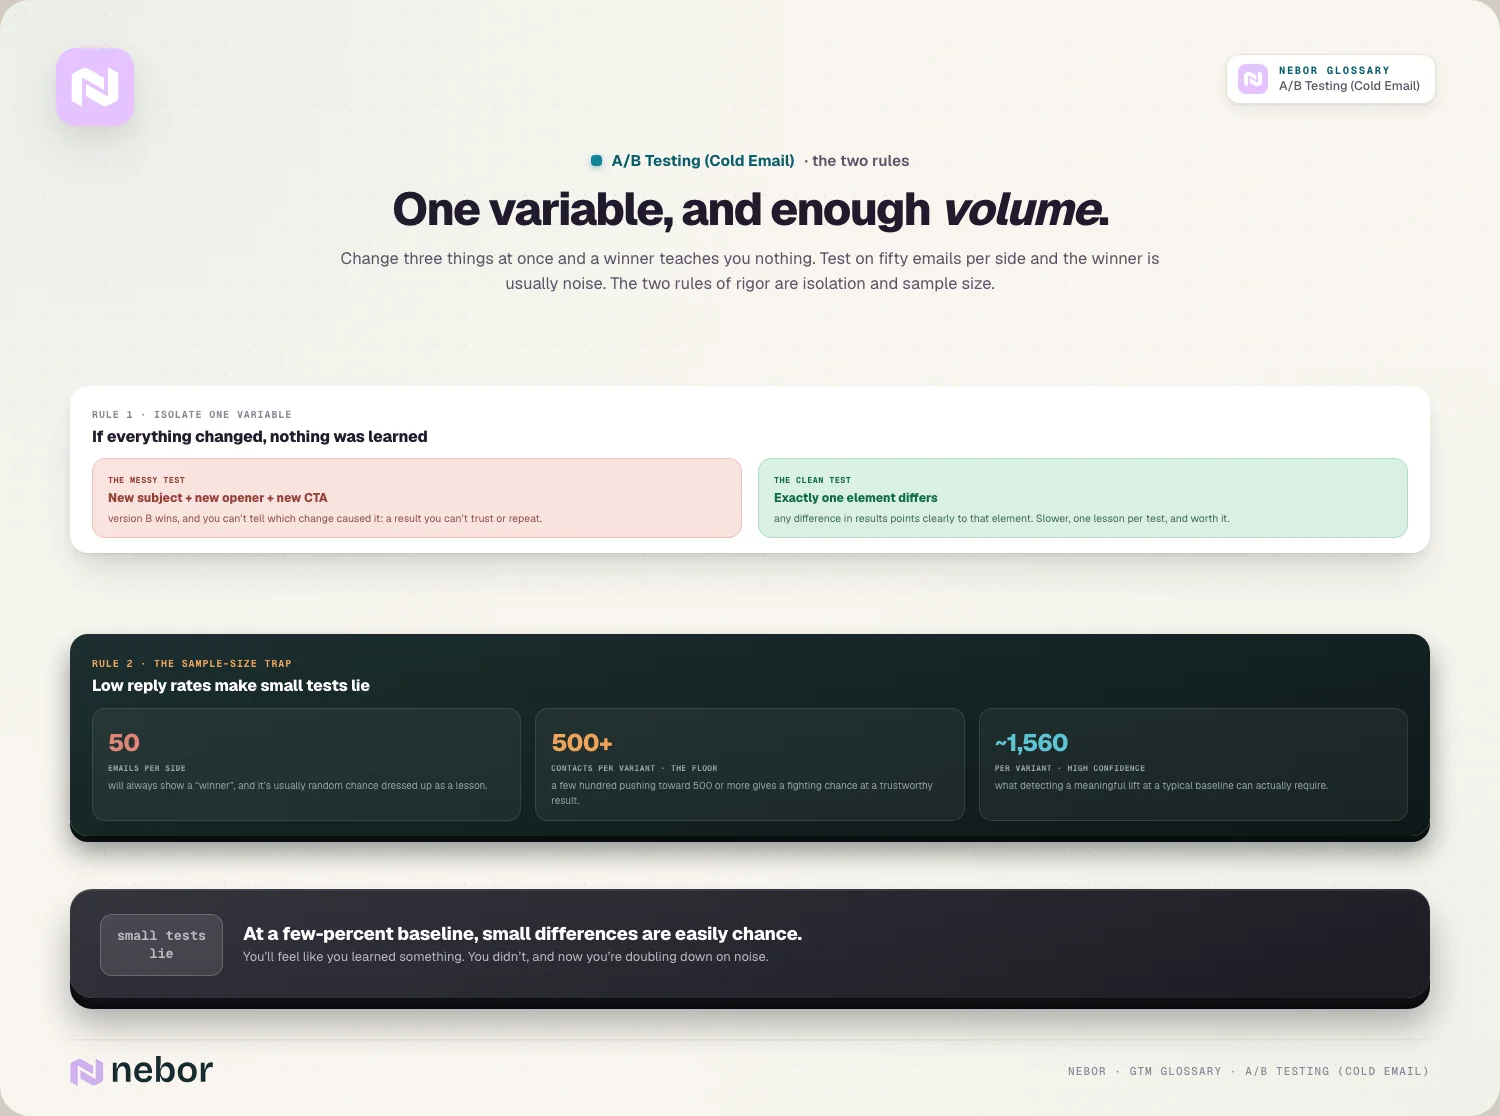
Eén variabele isoleren lost dit op. Als de twee versies precies op één onderdeel verschillen, wijst elk verschil in resultaat duidelijk naar dat onderdeel, en daar is de hele test voor bedoeld.
Het betekent wel dat je trager leert, omdat je per test maar één ding kunt leren, dus een hele e-mail verbeteren kost een reeks tests in plaats van één groot experiment.
In dit hoekje van outbound wint discipline het dus van snelheid. Een reeks schone tests met één variabele leert je echte lessen, terwijl één rommelige test met meerdere variabelen je een resultaat geeft dat je niet kunt vertrouwen of herhalen.
Waarom maakt of breekt de steekproefgrootte elke cold email-test?
Hier gaat de meeste A/B-testing van cold email onderuit, en in onze ervaring verdient dit meer aandacht dan al het andere bij elkaar. Het probleem is dat de reply rates van cold email laag zijn.
Lage percentages betekenen direct ruis, omdat kleine verschillen tussen versies makkelijk puur toeval kunnen zijn in plaats van een echt effect als je basis-reply rate maar een paar procent is.
De rekensom kent hier geen genade. Bij een gemiddelde basis kan het vinden van een zinvolle verbetering al zo'n 1.560 e-mails per variant vragen voor een hoge betrouwbaarheid, veel meer dan de meeste teams in een test versturen.
Een praktische ondergrens houdt de hele oefening eerlijk. Als je begint met een paar honderd contacten per variant en richting de 500 of meer gaat, maak je een eerlijke kans op een betrouwbaar resultaat.
De harde waarheid is dus dat kleine tests liegen. Een test op vijftig e-mails per kant laat heus een winnaar zien, maar die winnaar is meestal ruis, en dan heb je niets geleerd terwijl het voelt alsof je wel iets hebt geleerd.
Hoe weet je dat een resultaat echt is en geen toevalstreffer?
Naast de steekproefgrootte heb je een manier nodig om te beoordelen of een verschil betekenis heeft. Daar is statistische significantie voor.
Statistische significantie stelt je data één vraag. Is het verschil tussen A en B, gezien je steekproefgrootte, groot genoeg om waarschijnlijk geen puur toeval te zijn?
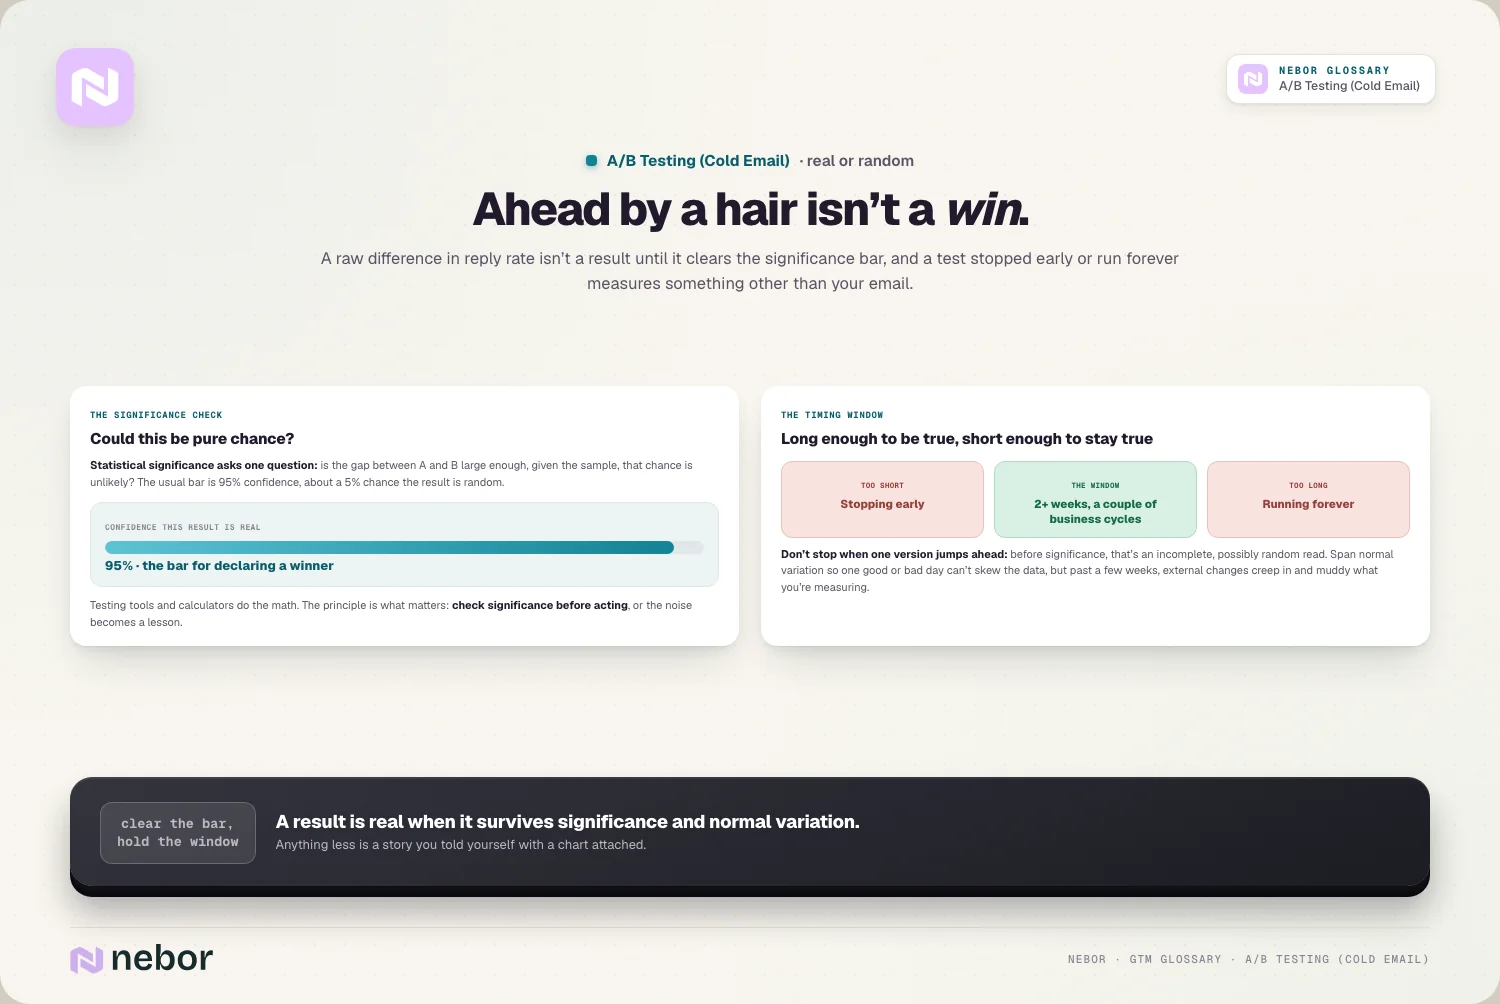
De gebruikelijke grens is 95% betrouwbaarheid. Op dat niveau is er maar zo'n 5% kans dat het resultaat toeval is, en dat is de gangbare lat om een echte winnaar aan te wijzen.
Je hoeft de rekensom niet met de hand te maken. Testtools en significantiecalculators doen dat voor je, maar het principe is wat telt, namelijk dat een ruw verschil in reply rate pas een resultaat is als het die lat haalt.
De gewoonte is dus om de significantie te controleren voordat je ergens op handelt. Een versie die op een kleine steekproef een haar voorligt, heeft nog niet gewonnen en geeft vooral ruis, en wie dat als les behandelt, houdt zichzelf voor de gek.
Hoe lang laat je een cold email-test lopen voordat je een winnaar kiest?
Steekproefgrootte is niet de enige eis, want ook timing telt. Een test die te kort of te lang loopt, brengt zijn eigen fouten mee.
De eerste regel is dat je niet te vroeg stopt. Ook als een versie snel voor komt te liggen, betekent een test beëindigen voordat hij significant is dat je handelt op een onvolledig resultaat dat misschien toeval is.
Je wilt ook de normale schommelingen meenemen. Als je een test minstens twee weken over een paar zakelijke cycli laat lopen, voorkom je dat één goede of slechte dag de data scheeftrekt.
Een test eindeloos laten doorlopen werkt ook averechts, omdat er na een paar weken externe veranderingen insluipen die vertroebelen wat je meet.
Het juiste tijdvak houdt dus rekening met allebei. Lang genoeg om een echte steekproef te verzamelen over normale schommelingen heen, en kort genoeg dat de wereld onder je test niet verandert.
Hoe past A/B-testen in de rest van je outbound-systeem?
A/B-testen is een gewoonte die over je hele aanpak heen oploopt, veel meer dan een losse truc. Het werkt het best als het is ingebouwd in hoe je outbound doet.
Het is de motor achter continu verbeteren, omdat het testen van variabelen in je e-mailsequence en sales cadence over tijd is hoe elke stap steeds scherper wordt in plaats van hetzelfde te blijven. Systematisch testen is ook de kern van sequence-optimalisatie, het verfijnen van je hele outreach-flow op basis van bewijs.
Het stuurt ook je personalisatie, omdat testen welke invalshoeken meer reacties opleveren je vertelt waar personalisatie op schaal de moeite waard is en waar niet.
Testen hoort dus als vaste gewoonte in je outbound playbook. De teams die winnen, behandelen hun outreach als iets wat je test en verbetert in plaats van iets wat je één keer schrijft en daarna laat liggen.
Hoe zet je vanaf het begin een schone cold email-test op?
Een betrouwbare test draait vooral om een paar keuzes bij de opzet, en elke test die we voor klanten bouwen houden we aan dezelfde vier. Als je die goed maakt, weet je het verschil tussen een echt resultaat en ruis.
De eerste is je publiek willekeurig en gelijk verdelen. Elke versie hoort naar een vergelijkbare groep te gaan, zodat het enige verschil tussen de twee de variabele is die je test, en niet wie de e-mail kreeg.
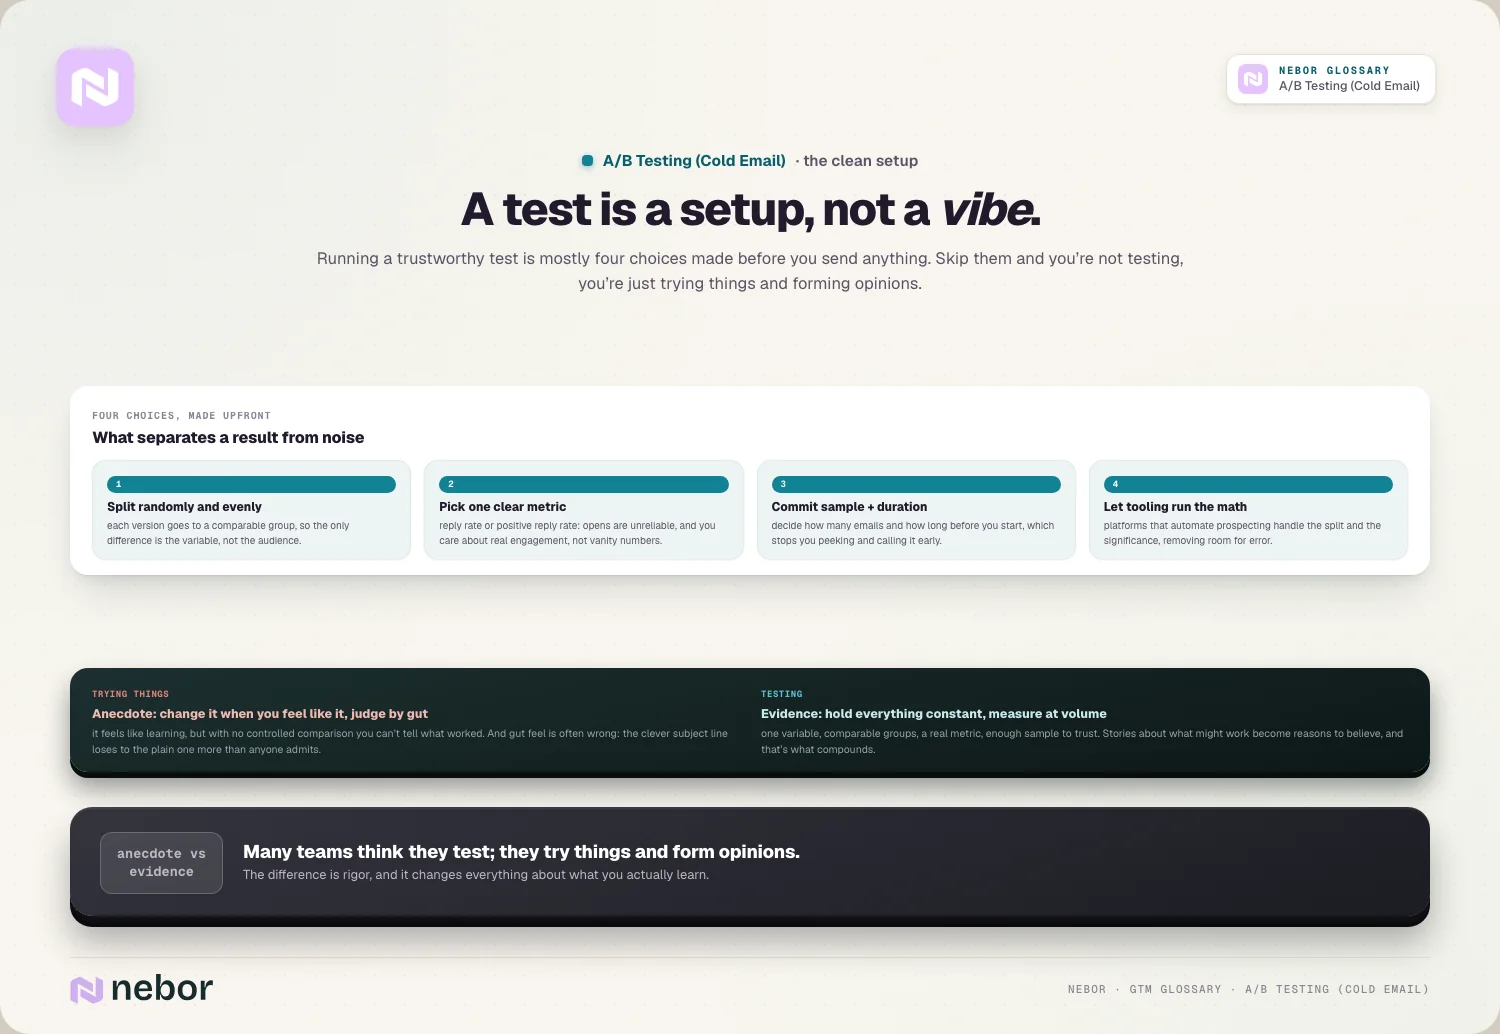
De tweede is één duidelijk meetpunt kiezen. Voor cold email is dat meestal de reply rate of de positieve reply rate, omdat opens onbetrouwbaar zijn en het je om echte betrokkenheid gaat in plaats van ijdele cijfers.
De derde is vooraf vastleggen hoe groot de steekproef is en hoe lang de test loopt. Als je voor de start bepaalt hoeveel e-mails en hoe lang, voorkom je dat je tussendoor gaat kijken en te vroeg een winnaar kiest.
De vierde is tooling gebruiken die de verdeling en de rekensom afhandelt. Platforms die sales prospecting automatiseren regelen vaak de test, verdelen het publiek en berekenen de significantie, en dat haalt veel ruimte voor fouten weg.
Wat is het verschil tussen echt testen en gewoon dingen uitproberen?
Veel teams denken dat ze testen, terwijl ze vooral dingen uitproberen en daar een mening over vormen. Het verschil zit in de grondigheid, en dat verandert alles aan wat je leert.
Dingen uitproberen is je e-mail aanpassen wanneer je daar zin in hebt en op je gevoel beoordelen. Het voelt als leren, maar zonder gecontroleerde vergelijking kun je niet zien wat werkte.
Testen is daarentegen gecontroleerd en gemeten. Je houdt alles gelijk behalve één variabele, verstuurt naar vergelijkbare groepen en beoordeelt op een echt meetpunt, met genoeg volume om het te kunnen vertrouwen.
Het onderscheid doet ertoe, omdat je gevoel in cold email vaak verkeerd zit. Een onderwerpregel die slim voelt, kan het slechter doen dan een simpele, en alleen een echte test laat dat zien.
De grens ligt dus tussen anekdote en bewijs. Uitproberen geeft je verhalen over wat misschien werkt, terwijl testen je redenen geeft om iets te geloven, en dat is wat zich over tijd opstapelt.
Welke veelgemaakte fouten bij het A/B-testen van cold email vermijd je?
A/B-testen gaat op een paar voorspelbare manieren mis, en de meeste hebben met grondigheid te maken. Als je ze vooraf kent, blijven je tests eerlijk.
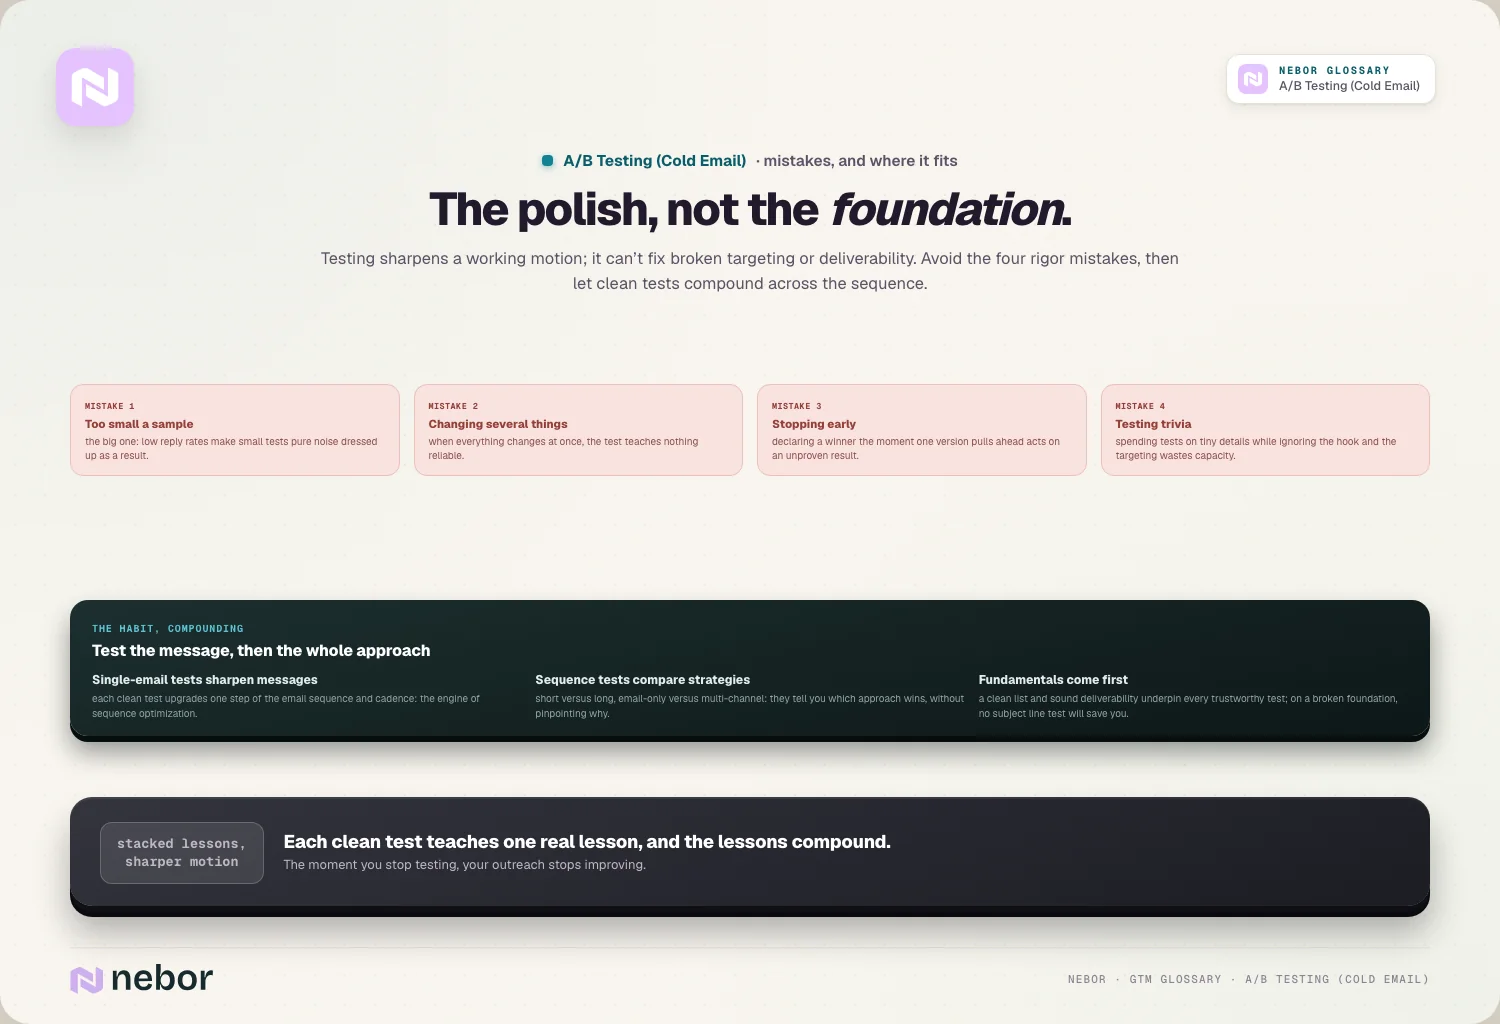
De grootste is testen op een te kleine steekproef, omdat lage reply rates van kleine tests pure ruis maken die zich voordoet als een resultaat.
Kort daarachter komt meer dan één variabele veranderen, omdat je bij meerdere veranderingen tegelijk niet kunt zien wat het verschil veroorzaakte, dus de test leert je niets betrouwbaars.
Daarna komt te vroeg stoppen, waarbij een winnaar wordt uitgeroepen zodra een versie voor komt te liggen, en je handelt op een resultaat dat nog niet heeft bewezen dat het echt is.
En dan is er het testen van onbelangrijke dingen, waarbij je je tests besteedt aan kleine details terwijl je de grote hendels negeert, zoals de hook of de targeting, en zo je testcapaciteit verspilt aan veranderingen die nauwelijks iets uitmaken.
Hoe hangt testen samen met de rest van je werk aan de kwaliteit van je outreach?
A/B-testen verbetert wat je al hebt, maar het kan een kapotte basis niet repareren. Het werkt het best bovenop de basis.
Testen optimaliseert een aanpak die al werkt. Als je targeting en deliverability in orde zijn, maakt testen je boodschap scherper, maar als die kapot zijn, redt geen enkele test met onderwerpregels je.
Het gaat ook goed samen met technieken als rotatie en variatie. Tools als spintax variëren je woordkeuze om je deliverability te beschermen, en dat is een ander doel dan testen, maar het hoort bij hetzelfde vak van cold email verfijnen.
En het hangt af van een schoon publiek. Testen op een slecht gebouwde lijst geeft onbetrouwbare resultaten, dus goede list building ligt onder betrouwbare tests.
Testen is dus de afwerking bovenop en niet de basis eronder. Het maakt goede outreach beter, en daarom betaalt het zich het meest uit als de basis eronder al stevig staat.
Kun je een hele sequence A/B-testen in plaats van één losse e-mail?
A/B-testen richt zich meestal op één e-mail, maar dezelfde logica werkt ook voor hele sequences. De uitdaging is om het grondig te houden als de test groter wordt.
Je kunt sequences tegen elkaar testen. De ene versie gebruikt dan bijvoorbeeld een andere cadans, een andere mix van kanalen of een andere opbouw, en je vergelijkt welke sequence in totaal meer meetings oplevert.
Toeschrijven wordt op die grotere schaal een stuk lastiger. Met veel variabelen over een hele sequence is het moeilijker om te weten wat een verschil veroorzaakte, dus sequence-tests vertellen je welke aanpak wint zonder precies uit te leggen waarom.
Op een hoger niveau is dat nog steeds nuttig. Een korte sequence testen tegen een lange, of een flow met alleen e-mail tegen een multichannel-flow, beantwoordt echte strategische vragen, ook als je de oorzaak niet precies kunt aanwijzen.
De sterkste programma's testen dus op beide niveaus. Tests met één e-mail maken losse berichten scherper, terwijl sequence-tests hele aanpakken vergelijken, en met allebei verbeter je de details en de strategie tegelijk.
Waarom gedisciplineerd testen van cold email iets maakt wat je kunt verbeteren
A/B-testen bestaat om meningen te vervangen door bewijs op een plek waar meningen meestal winnen. In plaats van te discussiëren over wat werkt in cold email, zoek je het uit en bouw je erop verder.
De grootste waarde zit in het opstapelen. Elke schone test leert je één echte les, en als je die over tijd op elkaar stapelt, maken die lessen van een middelmatige outreach-aanpak een scherpe.
De eerlijke eis is grondigheid, omdat de reply rates van cold email laag zijn, en zonder een steekproef die groot genoeg is, één variabele tegelijk en een echte significantiecheck leveren je tests ruis op die als inzicht voelt.
Als je team dus blijft discussiëren over onderwerpregels en openingszinnen, is die discussie zelf het teken dat je zou moeten testen. Met discipline maakt A/B-testen van outbound iets wat je bewust verbetert, en worden de discussies eindelijk door data beslecht.
Die gewoonte om op bewijs te sturen is precies wat een serieus go-to-market-systeem aandrijft. Het is ook een gewoonte die de beste outbound-experts nooit loslaten, omdat je outreach ophoudt met beter worden zodra je stopt met testen.
Deel dit bericht
Outbound
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen

Klaar om je pipeline te bouwen