In this post:
Prompt engineering voor GTM is het schrijven van de instructies waarmee AI-modellen go-to-market-werk betrouwbaar doen: accounts onderzoeken, leads sorteren, openingszinnen schrijven en replies lezen. In de meeste sales- en marketingteams staan die instructies niet in een chatvenster. Ze zitten in een Clay-kolom, een stap in n8n of het AI-veld van een sequencer, en ze draaien op elke rij van een lijst.
Dat verandert wat een goede prompt is. Een vraag die je in ChatGPT typt, hoeft maar één keer te werken, voor iemand die het antwoord kan lezen en opnieuw kan vragen. Een prompt in een tabel draait een paar duizend keer zonder dat iemand meekijkt. Hij moet zich dus gedragen als een klein programma, met duidelijke input, één taak, een korte lijst met toegestane antwoorden en een manier om te zeggen dat hij niets vond.
De gebruikelijke fout zit in hoe prompts worden goedgekeurd. Iemand draait een nieuwe prompt op drie rijen, is blij met wat eruit komt en zet hem op de volledige lijst. De problemen duiken later op, in rij 400, als een verzonnen feit of als de twintigste opener die met dezelfde vier woorden begint.
TL;DR
Een prompt die op een lijst draait, lijkt meer op code dan op een gesprek. Houd de instructies en de data van de prospect in aparte secties met een label, geef het model één taak, som de antwoorden op die het mag geven en sta "not found" toe.
Onderzoeksprompts stellen één gerichte vraag, en elk antwoord moet de pagina noemen waar het vandaan komt en hoe oud die pagina is, zodat een rep een claim binnen een paar seconden kan checken.
Classificatieprompts werken met een vaste lijst labels, elk met een definitie van één regel, plus een label "unclear" dat het record naar een mens stuurt.
Prompts voor openingszinnen krijgen één gecontroleerd feit en geven één zin terug, gestuurd door drie tot vijf gevarieerde voorbeeldzinnen. Prompts voor reply-triage halen eruit wat een rep nodig heeft (het label, een datum, een doorverwezen collega) en laten het antwoord aan een mens over.
Test elke prompt op een vaste set van 30 tot 50 records waarvan je de juiste antwoorden kent, lastige gevallen inbegrepen, en draai dezelfde set opnieuw na elke wijziging. Anthropic en OpenAI beschrijven allebei een versie hiervan in hun eigen documentatie.
De twee fouten waartegen je ontwerpt, zijn verzonnen feiten (op te lossen met de regel "een bron of niets" en betere inputdata) en eenheidsworst (op te lossen met gevarieerde voorbeelden en minder, scherpere regels).
Nebor schrijft en test deze prompts in de eigen Clay en automatiseringstools van de klant, en laat de testset en een wijzigingslog achter, zodat het team veilig kan blijven aanpassen.
Prompt engineering voor GTM lijkt meer op code dan op chat
Kijk eens wat een onderzoeks- of schrijfstap in een tabel binnenkrijgt. Eerst jouw instructies, daarna een blok tekst dat je niet zelf hebt geschreven: de homepage van een bedrijf, een vacature, de LinkedIn-headline van een prospect, een reply op een inbound-bericht. Lopen die twee door elkaar, dan kan het model niet altijd zien welk deel de opdracht is en welk deel het materiaal.

De leveranciers van de modellen zeggen hetzelfde in andere woorden. De best practices voor prompts in Claude van Anthropic raden aan om elk type content in een eigen XML-tag te zetten, zoals instructies, context en input, omdat dat misverstanden voorkomt als een prompt die door elkaar gebruikt. De gids voor prompt engineering van OpenAI stelt Markdown-koppen en lijsten voor om aparte secties te markeren. Beide werken. Waar het om gaat, is dat de data van de prospect in een duidelijk gelabeld vak staat. Dan wordt vreemde tekst op een gescrapete webpagina ook minder snel als instructie gelezen.
Binnen die structuur bevatten de meeste betrouwbare GTM-prompts dezelfde paar onderdelen: welke rol het model speelt, één nauw omschreven taak, de context die het mag gebruiken, een specificatie van de output en, waar toon ertoe doet, een voorbeeld van een goed antwoord. De specificatie slaan teams het vaakst over, en juist die bepaalt of de volgende stap in de workflow iets kan met wat er terugkomt.

Patronen voor prompt engineering bij onderzoek, classificatie, openingszinnen en replies
Vier taken dekken het meeste van wat GTM-teams een model laten doen. Elke taak vraagt om een net iets andere vorm van prompt, en de prompt van de ene taak kopiëren naar de andere is een bekende bron van zwakke output. De voorbeelden hieronder zijn gewone tekst. Vierkante haken geven aan waar de tabel de data van elke rij invoegt.

Onderzoek: één vraag, een bron en een datum
Onderzoeksprompts gaan mis als ze breed zijn. "Onderzoek dit bedrijf" levert een prettige samenvatting op die half klopt en niet te controleren is. Stel liever één vraag.
Voorbeeld van een onderzoeksprompt: Je onderzoekt een B2B-bedrijf voor een salesteam. Gebruik alleen de tekst in [careers page] en [company news page] en beantwoord één vraag: hoeveel vacatures voor sales development heeft dit bedrijf openstaan, en in welke steden? Geef drie velden terug: answer, source_url en date_seen. Staat het niet in de tekst, geef dan in alle drie de velden "not found" terug. Maak geen schatting.
Drie details doen het meeste werk. De vraag is nauw genoeg om één juist antwoord te hebben. Het model mag alleen de tekst gebruiken die je het gaf. En "not found" is een geldig antwoord, dus het model heeft geen reden om iets te verzinnen. Dit is prospect research, kolom voor kolom, en het bouwt voort op de velden die data enrichment al heeft gevuld.
Classificatie: een vaste lijst labels
Bij sorteren verslaan modellen regels die met punten werken, omdat ze een rommelige functietitel of een vrij antwoord in een formulier kunnen lezen en kunnen inschatten wat het betekent. Dat doen ze alleen consequent als de labels vastliggen.
Voorbeeld van een classificatieprompt: Lees hieronder de functietitel en het antwoord op "what are you looking for". Kies precies één label uit deze lijst. economic_buyer: beheert het budget voor salestools, meestal op VP- of Head-niveau. user: gaat dagelijks met de tool werken. evaluator: technische of operationele rol die beoordeelt of het past. not_relevant: student, werkzoekende, leverancier of concurrent. unclear: dat kun je niet uit de tekst opmaken. Geef alleen het label terug. [job title] [form answer]
Het label "unclear" is het belangrijkste. Zonder dat label duwt het model elk twijfelgeval in het dichtstbijzijnde label, en zie je nooit waar het moeite had. Met dat label gaan die records naar een mens, en het aantal antwoorden met "unclear" vertelt je of de definities werk nodig hebben. Labels als deze voeden lead qualification en routing aan de inbound-kant, naast de numerieke score die je al gebruikt.
Openingszinnen: één feit erin, één zin eruit
De prompt die een opener schrijft, hoort de simpelste van de keten te zijn, omdat het zware werk al eerder is gedaan. Het onderzoek vond het feit, een aparte stap koos het beste feit, en deze stap schrijft alleen.
Voorbeeld van een prompt voor een openingszin: Schrijf de openingszin van een cold e-mail aan [first name], [job title] bij [company]. Gebruik alleen dit feit: [fact] (bron: [source_url]). Eén zin, minder dan 25 woorden, geen aanhef, geen compliment, geen vraag. Zeg niets wat niet in het feit staat. Sluit aan bij de toon van deze voorbeelden: [drie tot vijf zinnen die een reply kregen, elk over een ander soort feit]. Is het veld met het feit leeg, geef dan EMPTY terug.
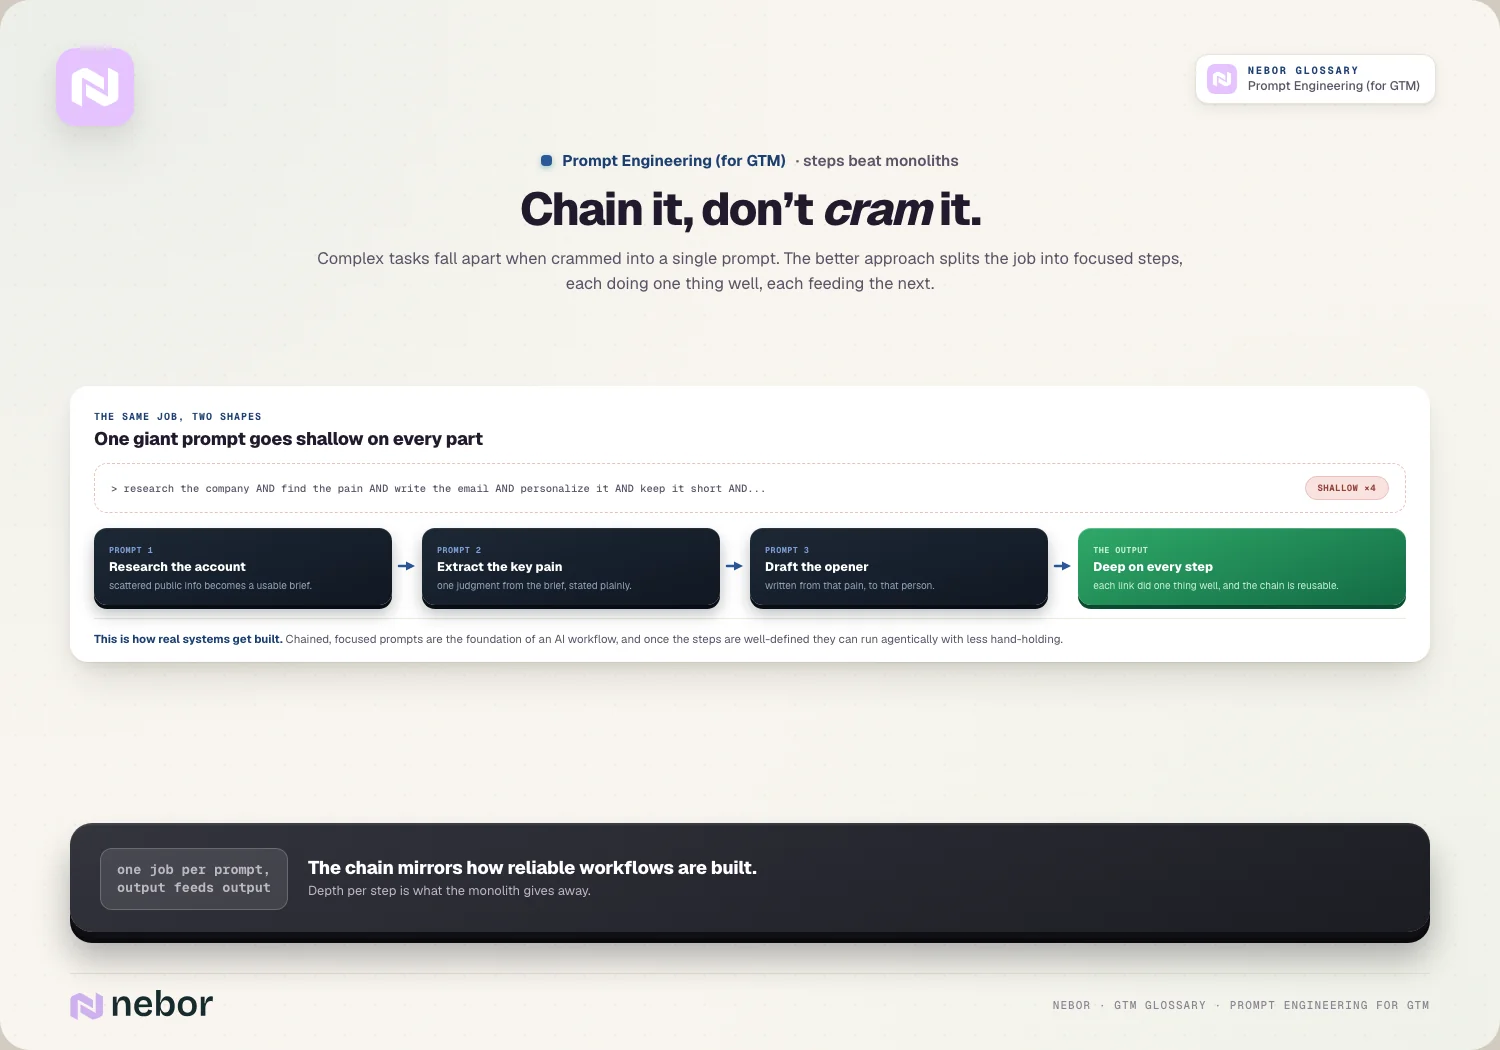
De taak zo opsplitsen is wat Google beschrijft in zijn strategieën voor promptontwerp voor Gemini, waar het voorstelt om van elke stap een prompt te maken en de prompts in een reeks aan elkaar te koppelen. Gekoppelde stappen zoals deze vormen de ruggengraat van een AI-workflow. Zodra elke stap goed is omschreven, kun je een deel van de routing ertussen overlaten aan een AI-agent in een agentic workflow. Het antwoord EMPTY telt net zo zwaar als de zin zelf: daardoor kan de tabel een terugvalzin invoegen in plaats van een gat te versturen. De copykant hiervan, de stem en wat AI-e-mail verraadt, behandelen we onder AI-copywriting.
Reply-triage: haal eruit wat de rep nodig heeft
Leest een prompt replies, dan is zijn taak informatie eruit halen. Een gesprek voeren hoort daar niet bij. Een rep moet weten wat voor reply het is, of er een datum is om op terug te komen en of er iemand anders is genoemd.
Voorbeeld van een prompt voor reply-triage: Lees de reply hieronder. Geef terug: label (een van wants_meeting, refers_colleague, later_with_date, not_interested, out_of_office, unclear), follow_up_date als de reply een moment noemt, in de vorm YYYY-MM-DD, en referred_name en referred_email als de reply naar een collega verwijst, precies overgenomen zoals ze er staan. Schrijf geen antwoord. [reply text]
Out-of-office-replies zijn meer waard dan teams denken. Ze noemen vaak een datum waarop iemand terug is en een collega die de rol waarneemt, en een prompt als deze maakt van allebei velden waarop een sequence kan handelen. De workflow rond de prompt, inclusief welke replies nooit bij een model in de buurt komen, staat uitgewerkt in het artikel over de AI-workflow hierboven.
Bouw een testset voordat je een prompt vertrouwt
Drie outputs bekijken vertelt je dat een prompt kan werken. Hoe vaak hij faalt en of je laatste aanpassing het beter of slechter maakte, zie je daar niet aan. Daarvoor heb je een vaste set records nodig waarop je elke versie draait.
Kies 30 tot 50 echte records, en met opzet ook lastige. Neem rijen op met lege velden, een bedrijf zonder nieuws, een Nederlandstalige site, iemand die van baan is gewisseld en een boze reply. De gids van Anthropic over succescriteria bepalen en evaluaties bouwen noemt irrelevante of ontbrekende inputdata en te lange input als randgevallen die je hoort mee te nemen.
Schrijf eerst het juiste antwoord op. Voor een label of een uitgelezen datum is dat één waarde. Voor een openingszin is het een korte set criteria: trouw aan de bron, specifiek voor dit record, iets wat je zelf zou versturen.
Beoordeel met code waar dat kan. Labels, datums en "not found" kun je controleren op een exacte match, en dat kost seconden. Geschreven zinnen moeten worden gelezen door een mens, of door een tweede model met uitgeschreven criteria.
Verander één ding en draai daarna alles opnieuw. Labelt de oude prompt 31 van de 40 replies goed en haalt de nieuwe er 36, dan ga je van 78% naar 90% en weet je dat de aanpassing hielp. Met drie met de hand gekozen rijen had je dat nooit kunnen zien.
Leg de modelversie vast. De gids van OpenAI waarschuwt dat verschillende snapshots van modellen uit dezelfde familie verschillende resultaten kunnen geven, en raadt testsets aan die het gedrag van prompts meten terwijl je itereert. Een update van de aanbieder is een promptwijziging die je niet zelf hebt gedaan, dus draai de set opnieuw als dat gebeurt.
De gids van Anthropic is duidelijk over de afweging: meer vragen met automatische beoordeling die iets minder zegt, zijn beter dan minder vragen die zorgvuldig met de hand zijn beoordeeld. Voor GTM-werk betekent dat: een testset van 40 gelabelde rijen die je elke keer draait, is beter dan een zorgvuldige review van vijf.
Waarom verzint het model feiten over prospects?
Meestal omdat de prompt erom vroeg. "Schrijf een gepersonaliseerde opener voor deze prospect", plus een record met een naam en een bedrijf, is een verzoek om iets specifieks zonder iets specifieks om mee te werken. Het model doet braaf wat je vraagt, met een geloofwaardig podcastoptreden of een investeringsronde die nooit heeft plaatsgevonden.
Drie aanpassingen halen er het meeste van weg. Sta in elke prompt voor onderzoek en schrijven een leeg antwoord toe, zoals in de voorbeelden hierboven. Beperk het model tot de tekst die je aanleverde en eis bij elke claim een bron. En vraag bij lange input, zoals een jaarverslag of een lange vacaturepagina, eerst om de relevante citaten en pas daarna om het antwoord. De pagina met best practices van Anthropic raadt precies dat aan voor taken met lange documenten, omdat het model zo bij de delen van de tekst blijft die ertoe doen.
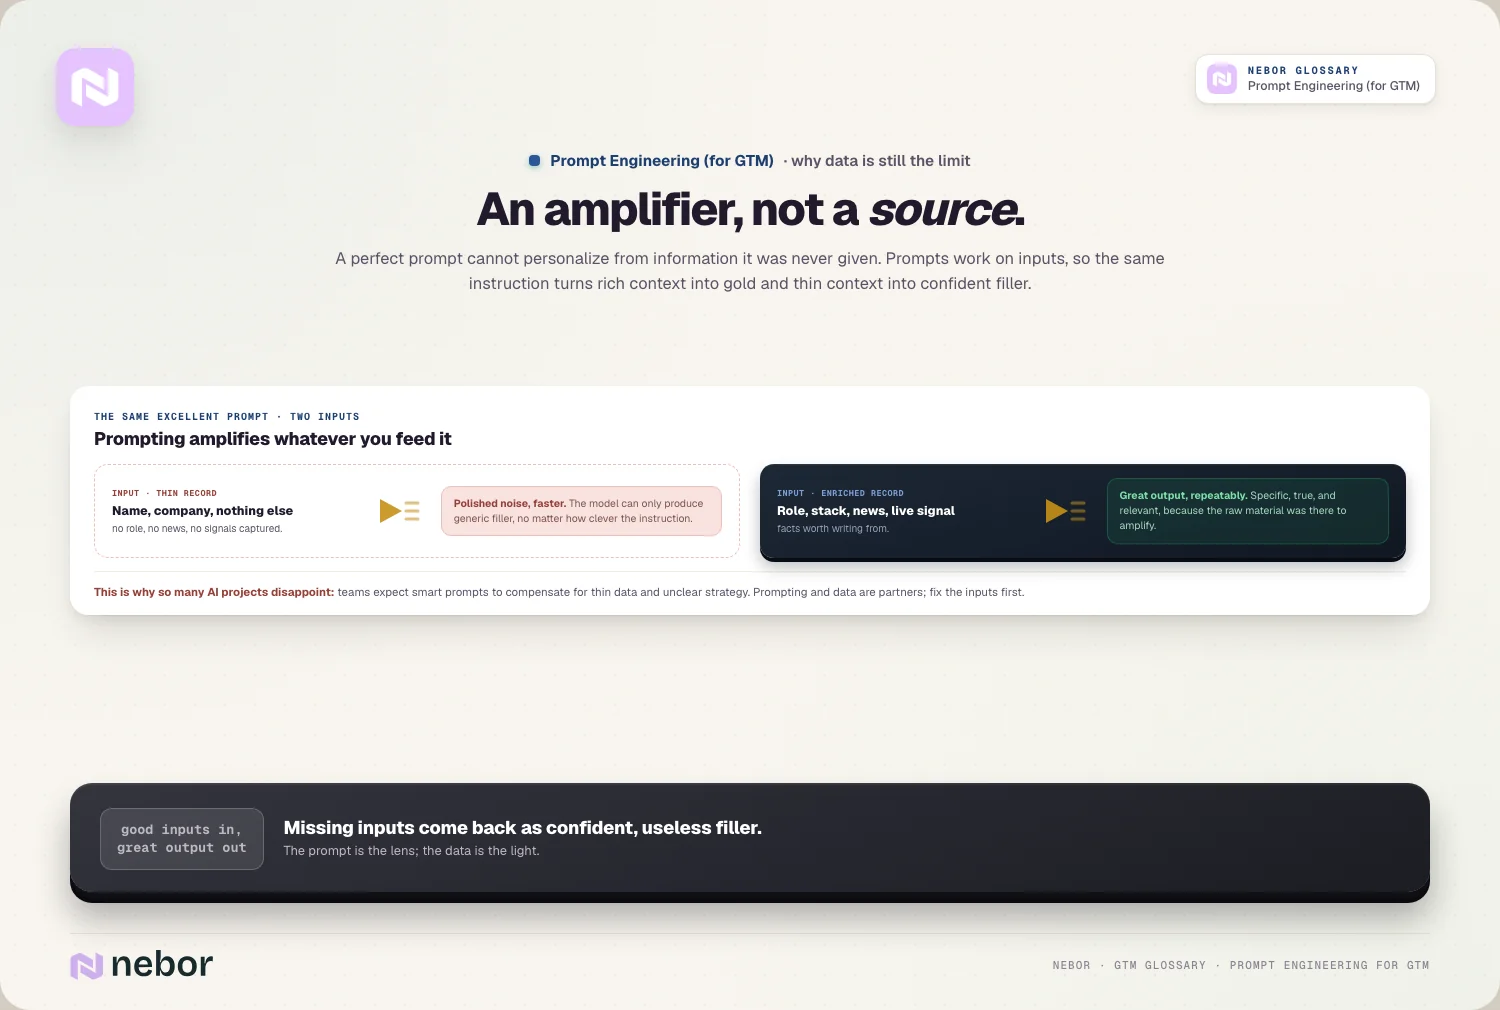
De rest zit eerder in de keten. Een prompt versterkt wat hij binnenkrijgt, en geen enkele formulering maakt van een leeg record personalization at scale. Teams die verwachten dat slimme prompts dunne data en een vage doellijst goedmaken, zijn een van de redenen dat Clay-implementaties en vergelijkbare builds mislukken. De oplossing is daar betere input. Een langere instructie helpt niet.
Eenheidsworst komt binnen via de voorbeelden
De tweede fout valt minder op. Elke zin klopt, en elke zin klinkt hetzelfde. Vijftig openers in een kolom beginnen allemaal met "Ik zag dat jullie aan het werven zijn", zijn allemaal even lang en eindigen allemaal met dezelfde wending. Een prospect die één e-mail krijgt, ziet het niet. Je reply rate ziet het wel.
Meestal liggen de voorbeelden eraan. Modellen nemen patronen over uit de voorbeelden die je ze geeft, ook patronen die je ze niet wilde leren. De Gemini-gids van Google merkt op dat een model zich bij te veel voorbeelden te sterk naar die voorbeelden kan gaan richten. Anthropic vraagt om voorbeelden die gevarieerd genoeg zijn om te voorkomen dat Claude onbedoelde patronen oppikt, en de gids van OpenAI zegt hetzelfde over het tonen van een brede reeks mogelijke inputs met de gewenste outputs.
In de praktijk betekent dat voorbeeldzinnen op basis van verschillende soorten feiten (een nieuwe medewerker, een lancering, een nieuwe markt, een wisseling in de leiding), met verschillende zinsbouw en verschillende lengtes. Het betekent ook minder opgestapelde regels. Een prompt met vijftien regels die met "nooit" beginnen, duwt elk antwoord meestal in hetzelfde smalle kanaal. Lees elke batch als kolom, van boven naar beneden, in plaats van rij voor rij. Zo valt eenheidsworst direct op. Rij voor rij zie je het nooit.
Prompts die zonder toezicht draaien, hebben een eigenaar nodig
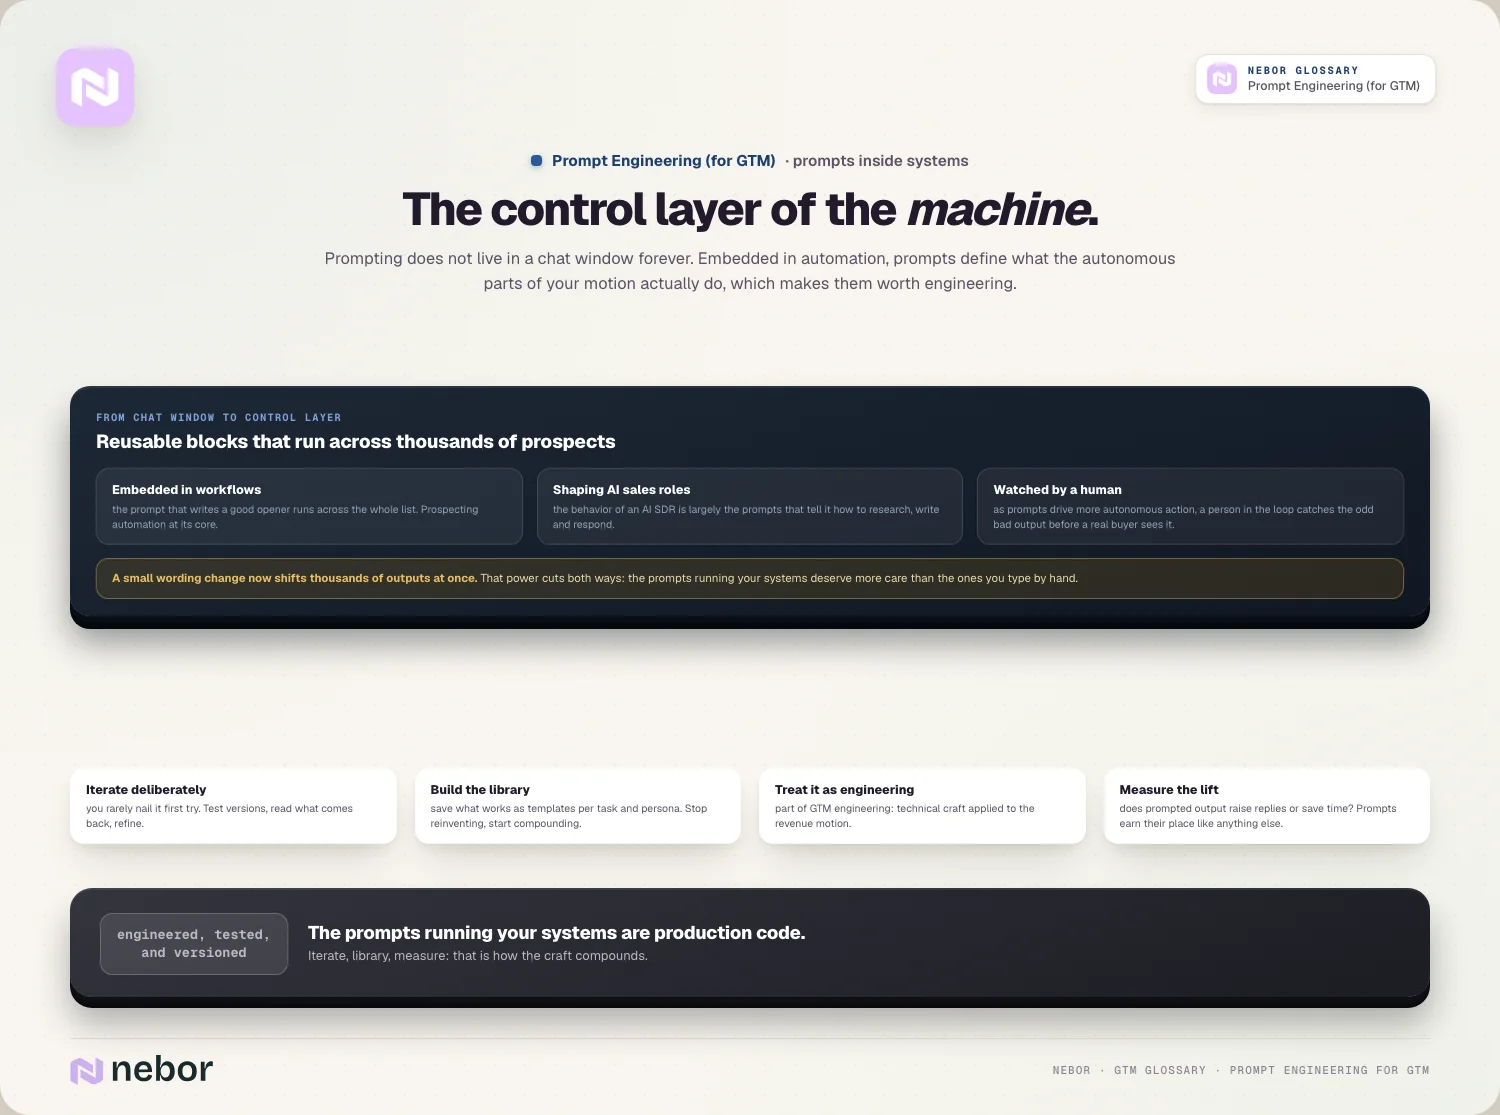
Zodra een prompt in een automatisering zit, verandert een aanpassing van één woord bij de volgende run duizenden outputs. De prompts achter een AI SDR, of achter autonomous outbound die afgaat zodra er een signaal verschijnt, bepalen wat je bedrijf de hele dag tegen kopers zegt. Ze verdienen de zorg die je aan productiecode zou geven.
Dat betekent een opgeslagen bibliotheek met één actuele versie van elke prompt, een eigenaar met een naam, een notitie van wat er veranderde en waarom, en de testset ernaast. Het betekent een human in the loop op elk punt waar de output van een prompt ongelezen bij een koper kan belanden. En het betekent dat je elke prompt beoordeelt op het cijfer waarvoor hij is gebouwd, zoals positieve replies voor openers of correcte routing voor classificatie. Hoe slim de output eruitziet, telt daarbij niet mee. Dit is gewone discipline uit GTM engineering, toegepast op tekst. Zo blijft een prospectingpipeline die draait zonder handmatig onderzoek betrouwbaar, ook als de persoon die hem bouwde iets anders gaat doen.
De kern
Goed prompten voor go-to-market-werk draait minder om slimme formuleringen en meer om zorgvuldige specificatie. Elke prompt heeft één taak, een gelabelde plek voor zijn input, een korte lijst met toegestane outputs en toestemming om leeg terug te komen. Elk patroon (onderzoek, classificatie, openingszinnen, replies) krijgt de vorm die erbij past, en geen enkel patroon wordt vertrouwd voordat het op een vaste set lastige records heeft gedraaid.
Het vak heeft ook een plafond. Een prompt kan geen feiten vinden die niet in de data staan, en hij kan niet bepalen wat het waard is om tegen een markt te zeggen. Dat zijn allebei beslissingen van mensen, eerder in de keten genomen, bij targeting, enrichment en messaging. Zie prompts als de instructies die die beslissingen naar elke rij brengen, en ze worden een betrouwbaar onderdeel van hoe je GTM-stack dag in dag uit draait.
Het promptwerk van Nebor voor klanten eindigt met de prompts, testsets en terugvalzinnen in hun eigen Clay- en automatiseringsaccounts. Ze zijn zo eenvoudig geschreven dat een nieuwe collega een prompt kan openen, kan zien waarom elke regel er staat en hem kan aanpassen zonder de rest kapot te maken.
Veelgestelde vragen
Moet je kunnen programmeren om aan prompt engineering voor GTM te doen?
Nee. De prompts zelf zijn gewone taal, en met tools als Clay, n8n en de meeste sequencers voeg je de data van een rij in zonder code te schrijven. Wat wel helpt, is denken als een programmeur: je inputs benoemen, precies vastleggen welke output je verwacht, rekening houden met lege of vreemde data, en wijzigingen testen op dezelfde set records in plaats van te oordelen op een paar gelukkige voorbeelden.
Is prompt engineering net zo belangrijk voor inbound als voor outbound?
Ja. Aan de inbound-kant classificeren prompts formulierinzendingen, vatten ze samen waar een lead om vroeg, onderzoeken ze het bedrijf voordat een rep belt en schrijven ze een eerste reply die verwijst naar wat de persoon echt op je site deed. Dezelfde regels gelden als bij outbound: één taak per prompt, een vaste lijst labels als je sorteert, en een mens die alles controleert wat een koper gaat lezen.
Werkt een prompt die voor ChatGPT is geschreven op dezelfde manier in Claude of Gemini?
Meestal werkt hij, alleen zelden precies hetzelfde. Elke modelfamilie reageert net anders op structuur, voorbeelden en lengtegrenzen, en zelfs een nieuwere versie van hetzelfde model kan andere resultaten geven. Stap je over naar een andere aanbieder of een ander model, draai dan eerst je vaste testset op het nieuwe model voordat je er live verkeer naartoe stuurt. Reken erop dat je onderweg formuleringen, voorbeeldzinnen of outputformats moet bijstellen.
Hoe lang moet een GTM-prompt zijn?
Zo lang als nodig is om dubbelzinnigheid weg te nemen, en niet langer. Een classificatieprompt met heldere labeldefinities kan een korte alinea zijn, terwijl een prompt voor openingszinnen met voorbeeldzinnen langer wordt. Lengte wordt een probleem als regels zich opstapelen en elkaar gaan tegenspreken. Blijft een prompt groeien, dan is dat vaak een teken dat je hem beter in twee gekoppelde stappen kunt opsplitsen.
Wat is few-shot prompting, en wanneer gebruikt een salesteam het?
Bij few-shot prompting geef je een handvol voorbeeldinputs mee met de outputs die je wilt, zodat het model het patroon daaruit leert. Salesteams halen er het meest uit als toon of format ertoe doet, zoals bij openingszinnen of samenvattingen van replies. Gebruik drie tot vijf voorbeelden die verschillen in het soort feit, de zinsbouw en de lengte. Anders kopieert het model vaak één vorm voor elke rij.
Wat hoort in de system prompt en wat in de input per rij?
Zet alles wat voor elk record hetzelfde blijft in de system prompt of de developer-instructies: de rol, de taak, de definities van de labels, het outputformat, verboden zinnen en voorbeelden. Zet in de input per rij alleen de eigen data van het record, met een duidelijk label. Volgens de documentatie van OpenAI gaan developer messages voor op user messages. Dat is nog een reden om de regels daar te houden en de gescrapete data apart.
Kan AI inbound leads kwalificeren zonder dat een mens meekijkt?
Bij duidelijke gevallen vaak wel. Een goed omschreven classificatieprompt kan studenten, werkzoekenden en concurrenten betrouwbaar scheiden van echte kopers. Het risico zit in de twijfelgevallen, en daarom hoort de prompt een label voor onduidelijke gevallen te hebben dat naar een mens gaat. Houd bij hoeveel records daar belanden en hoe vaak reps het label overrulen, en laat het model pas meer zelf beslissen als beide cijfers laag blijven.
Is prompt engineering nog nodig nu AI-modellen beter worden?
Er gaat minder tijd naar trucs en omwegen, omdat nieuwere modellen gewone instructies goed volgen. Wat overblijft, zijn de GTM-onderdelen: bepalen welke ene vraag het onderzoek moet beantwoorden, labels definiëren die bij je salesproces passen, kiezen wat telt als bruikbaar feit en testen op echte records. Een beter model volgt een slechte specificatie alleen maar trouwer, dus de specificatie moet nog steeds kloppen.
Waar bewaart een team zijn GTM-prompts?
Op een gedeelde plek met versiebeheer, buiten het account van één persoon. Een simpel document of een repository met de actuele tekst van elke prompt, de eigenaar, een korte wijzigingslog en een link naar de testset is voor de meeste teams genoeg. De versie in Clay of je automatiseringstool hoort gelijk te zijn aan de opgeslagen versie, zodat niemand een live prompt aanpast zonder dat de wijziging wordt vastgelegd.
Deel dit bericht
AI
Guide
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen
Automatisering
AI-workflow
Een AI-workflow is een proces met meerdere stappen waarin gewone regels de meeste stappen afhandelen en een AI-model de paar stappen doet die taal of oordeel vragen, zoals een persoonlijke regel schrijven nadat een contact is verrijkt.
Automatisering
AI-copywriting
AI-copywriting is het gebruik van grote taalmodellen om sales- en marketingteksten te schrijven, zoals cold emails en onderwerpregels, op basis van een prompt en context over de prospect.

Automatisering
GTM engineering
GTM engineering is je go-to-market bouwen en automatiseren met tools, data en workflows, in plaats van met handwerk en steeds meer mensen. Een GTM engineer is de technische operator die dat systeem bouwt.
Automatisering
Personalization at scale
Personalization at scale betekent outreach relevant maken voor elke individuele prospect en toch grote aantallen bereiken, met data en automatisering die het onderzoek doen dat anders handwerk zou zijn.
Klaar om je pipeline te bouwen