In this post:
Personalization at scale betekent outreach versturen die voor elke prospect echt relevant is, naar honderden of duizenden prospects tegelijk. Data en automatisering doen daarbij het onderzoek en de eerste versie, werk dat een mens vroeger met de hand deed. Die relevantie moet echt zijn. Een voornaam in een template telt niet mee. Een zin die alleen voor deze ene persoon klopt, telt wel.
Jarenlang moest je kiezen. Je kon vijf grondig onderzochte e-mails per dag schrijven of er vijfduizend versturen die allemaal hetzelfde zeiden. Zodra de pipelinedoelen serieus werden, kozen de meeste teams zonder veel ophef voor het tweede.
Volgens ons is dit eerst een dataprobleem en pas daarna een schrijfprobleem. De gebruikelijke fout is een AI-schrijftool kopen en die loslaten op records met een naam, een bedrijf en verder niets. Wat eruit komt, is generieke e-mail die sneller wordt gemaakt. Dat is precies het probleem waarmee je begon, alleen in een groter volume.
TL;DR
De oude afweging was een handvol onderzochte e-mails of een stortvloed aan templates met merge tags. Enrichment en AI doen nu het graafwerk en de eerste versie. Mensen ontwerpen hoe berichten worden gebouwd en hoeven niet meer elk bericht zelf te schrijven.
Generieke outreach kost meer dan vroeger. Gmail vraagt afzenders om spamklachten onder 0,3% te houden, en Apple Mail laadt trackingpixels of iemand de e-mail nu leest of niet. Een reactie is dus het enige betrouwbare teken dat een bericht relevant was.
Breng het record op orde voordat je aan de schrijftool zit: de rol en hoe lang iemand die al heeft, context over het bedrijf en een actueel signaal zoals vacatures. Komt die data van een derde partij, dan moet je de persoon volgens artikel 14 van de AVG vertellen waar je die vandaan hebt, uiterlijk bij je eerste bericht.
Een werkende opzet heeft vier stations: invalshoeken die je één keer per persona vastlegt, enrichment per prospect, een AI-concept dat alleen uit die velden is opgebouwd (met een terugvalzin als ze leeg zijn) en hetzelfde inzicht via e-mail, LinkedIn en telefoon.
Gebruik de naamwisseltest. Werkt het bericht nog steeds voor honderd andere mensen met een andere naam in de aanhef, dan is het niet gepersonaliseerd.
De kwaliteit blijft overeind bij groot volume als je steekproeven leest, invalshoeken test op replies (opens zeggen te weinig), je data volgens een vast schema ververst en je belangrijkste accounts met de hand blijft schrijven.
Is personalization at scale een tegenspraak?
Dat was het vroeger wel. Zet outreach uit op twee assen, hoe diep relevant elk bericht is en hoeveel prospects het bereikt, en drie van de vier hoeken zijn makkelijk te benoemen.
Linksboven zit de ambachtsman: een founder of senior rep die een paar uitstekende e-mails per dag schrijft en eerst elke LinkedIn-post leest. Prachtig, maar veel te traag om een pipeline te vullen. Rechtsonder zit de stortvloed aan merge tags, duizenden e-mails met "Hoi {first_name}, ik kwam {company} tegen" die kopers leren om je te negeren. Linksonder zit de stille aftocht: een handvol verzendingen die nog steeds generiek zijn. Niemand plant om daar uit te komen, en toch belanden veel teams er.
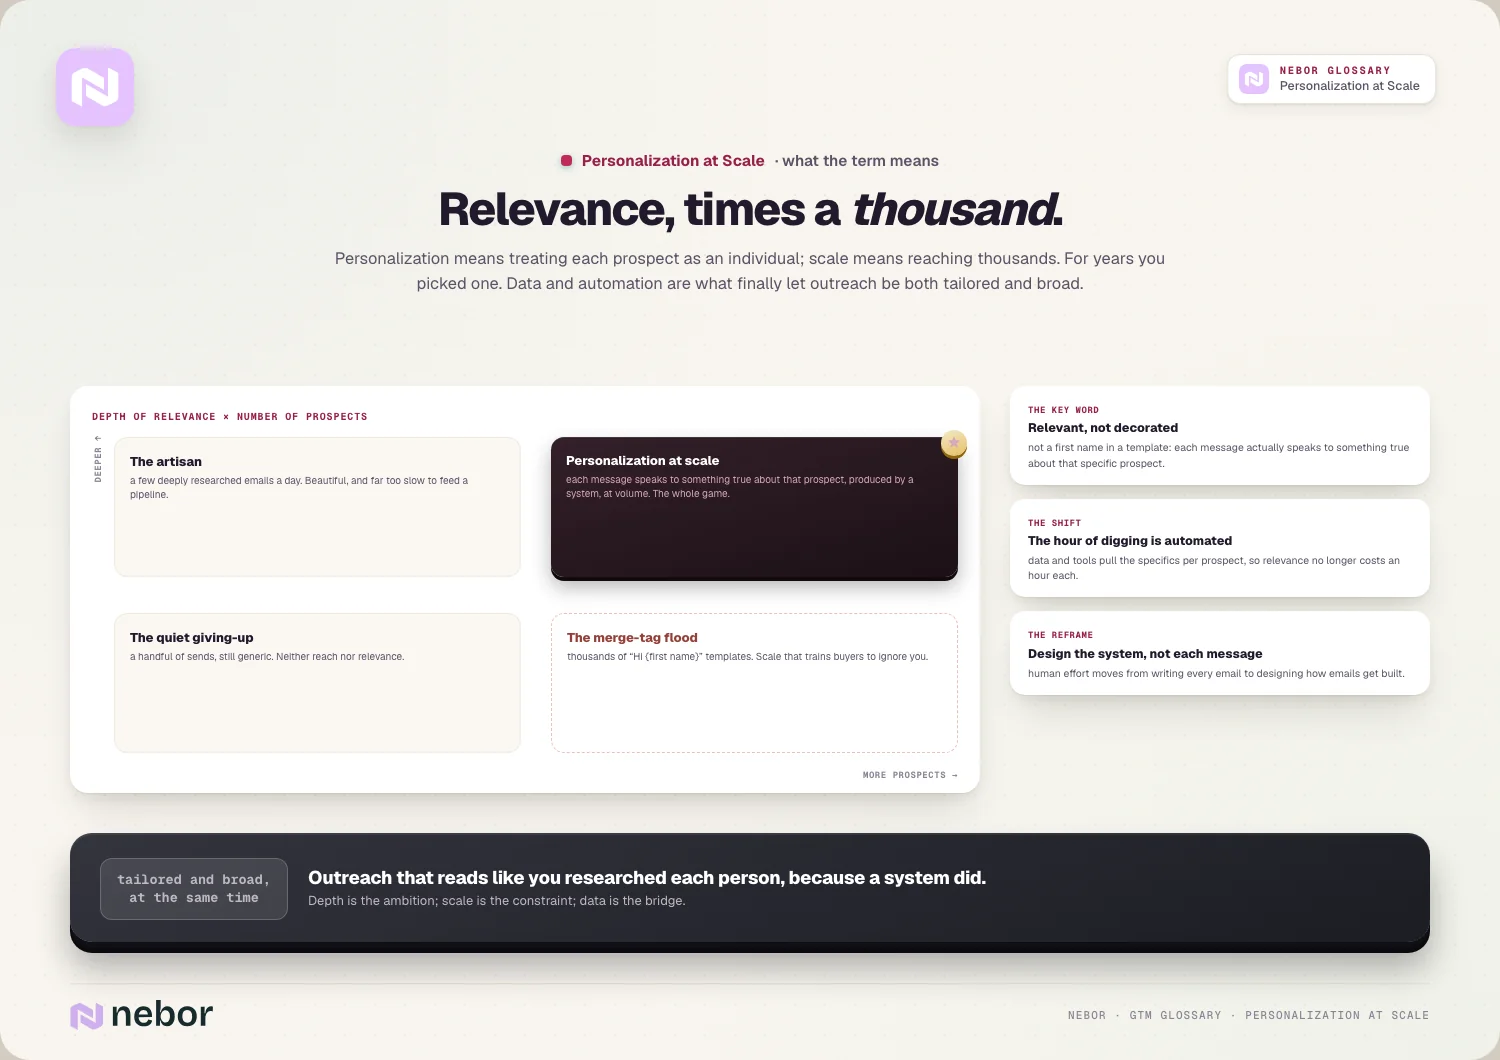
Deze term beschrijft de hoek rechtsboven. Die werd bereikbaar omdat een systeem nu het trage deel van het werk van de ambachtsman kan doen: iets specifieks en waars over elke persoon vinden. Enrichment-tools halen de feiten op, signalen vertellen wat er nu gebeurt en een taalmodel maakt er een eerste versie van. De menselijke inspanning verschuift van elk bericht schrijven naar bepalen wat een bericht relevant maakt voor elk type koper, en daarna controleren of het systeem zich daaraan houdt.
Generieke outreach is duurder geworden
Een nietszeggende e-mail kostte je vroeger alleen een gemiste reactie. Nu kost hij je ook reputatie.
Elk irrelevant bericht is een kans dat iemand op "spam melden" klikt, en generieke teksten verzamelen die klikken sneller dan wat ook. Gmail wil dat klachten onder 0,3% van je verzonden mail blijven, en liefst onder 0,1%, oftewel één per duizend e-mails. Een campagne die genoeg mensen irriteert, trekt de bezorging omlaag van alles wat vanaf hetzelfde domein wordt verstuurd, ook die van de goede e-mails. Alle regels op een rij vind je bij e-maildeliverability.
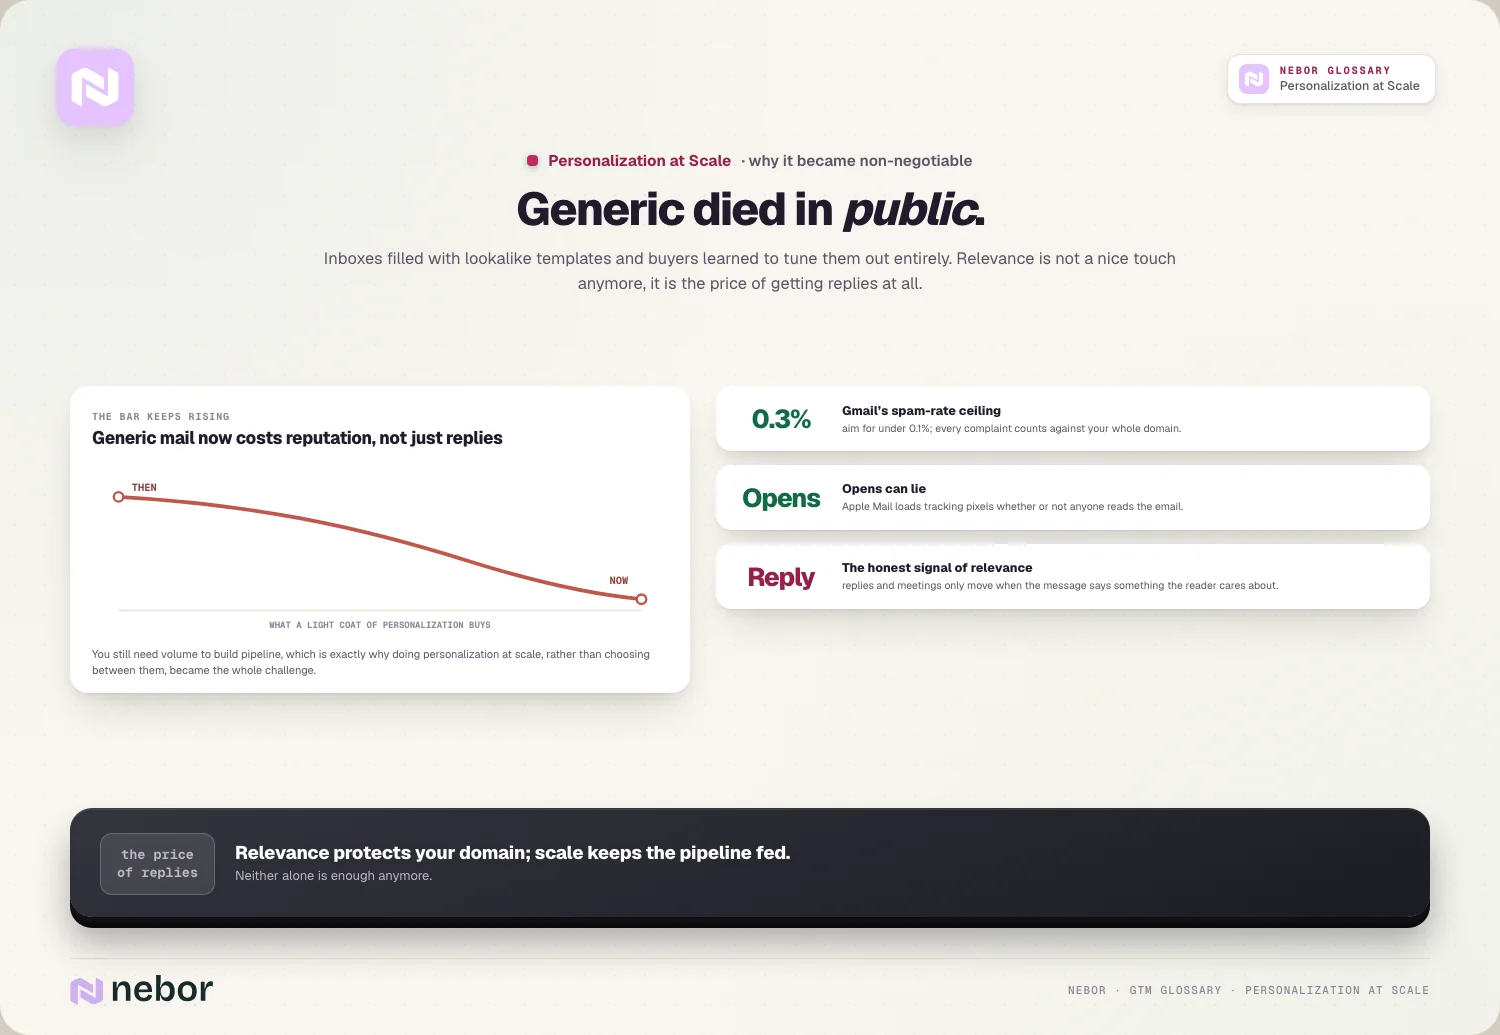
Meten of personalisatie werkt, is op één specifiek punt ook lastiger geworden. Mail Privacy Protection van Apple downloadt standaard externe content op de achtergrond, of je nu iets met de e-mail doet of niet. Daardoor gaat de openpixel af bij veel Apple Mail-gebruikers die geen woord hebben gelezen. Open rates vertellen je dat een e-mail is aangekomen. Of hij relevant was, vertellen ze je niet. Wat overblijft zijn replies, positieve replies en meetings, en die bewegen alleen als het bericht iets zegt waar de lezer om geeft.
Daarbij lopen inboxen vol met door AI geschreven e-mail die op het eerste gezicht gepersonaliseerd lijkt. Als elke leverancier "ik zag je recente post over groei" in bulk kan produceren, betekent die zin niets meer. De lat voor wat als echt relevant overkomt, blijft stijgen, dus een dun laagje personalisatie levert elk jaar minder op.
Begin bij het record en pas daarna bij de schrijftool
Je kunt een bericht niet afstemmen op feiten die je niet hebt. Hier is dezelfde prospect als twee CRM-records.
De magere versie bevat een naam, Sarah Chen, en een bedrijf, Meridian Systems. Elk ander veld is leeg en er zijn geen signalen vastgelegd. Vraag een willekeurige AI-schrijftool om daarmee te personaliseren en je krijgt "Hoi Sarah, ik vind het geweldig wat Meridian doet in de markt". Daar haalt ze alleen uit dat een machine het heeft geschreven.
De verrijkte versie weet dat ze VP Revenue Operations is en die stoel acht maanden heeft. Ze weet ook dat Meridian een B2B-SaaS-bedrijf is met 140 medewerkers dat in de EU verkoopt, dat het onlangs drie salestools naar één platform heeft verhuisd en dat het deze maand twee RevOps-analisten zoekt. Nu is er iets waars te zeggen: een nieuwe VP die net tools heeft samengevoegd en het team laat groeien, loopt waarschijnlijk als volgende tegen een gat in de rapportage aan. Dat is een gesprek dat het beginnen waard is.
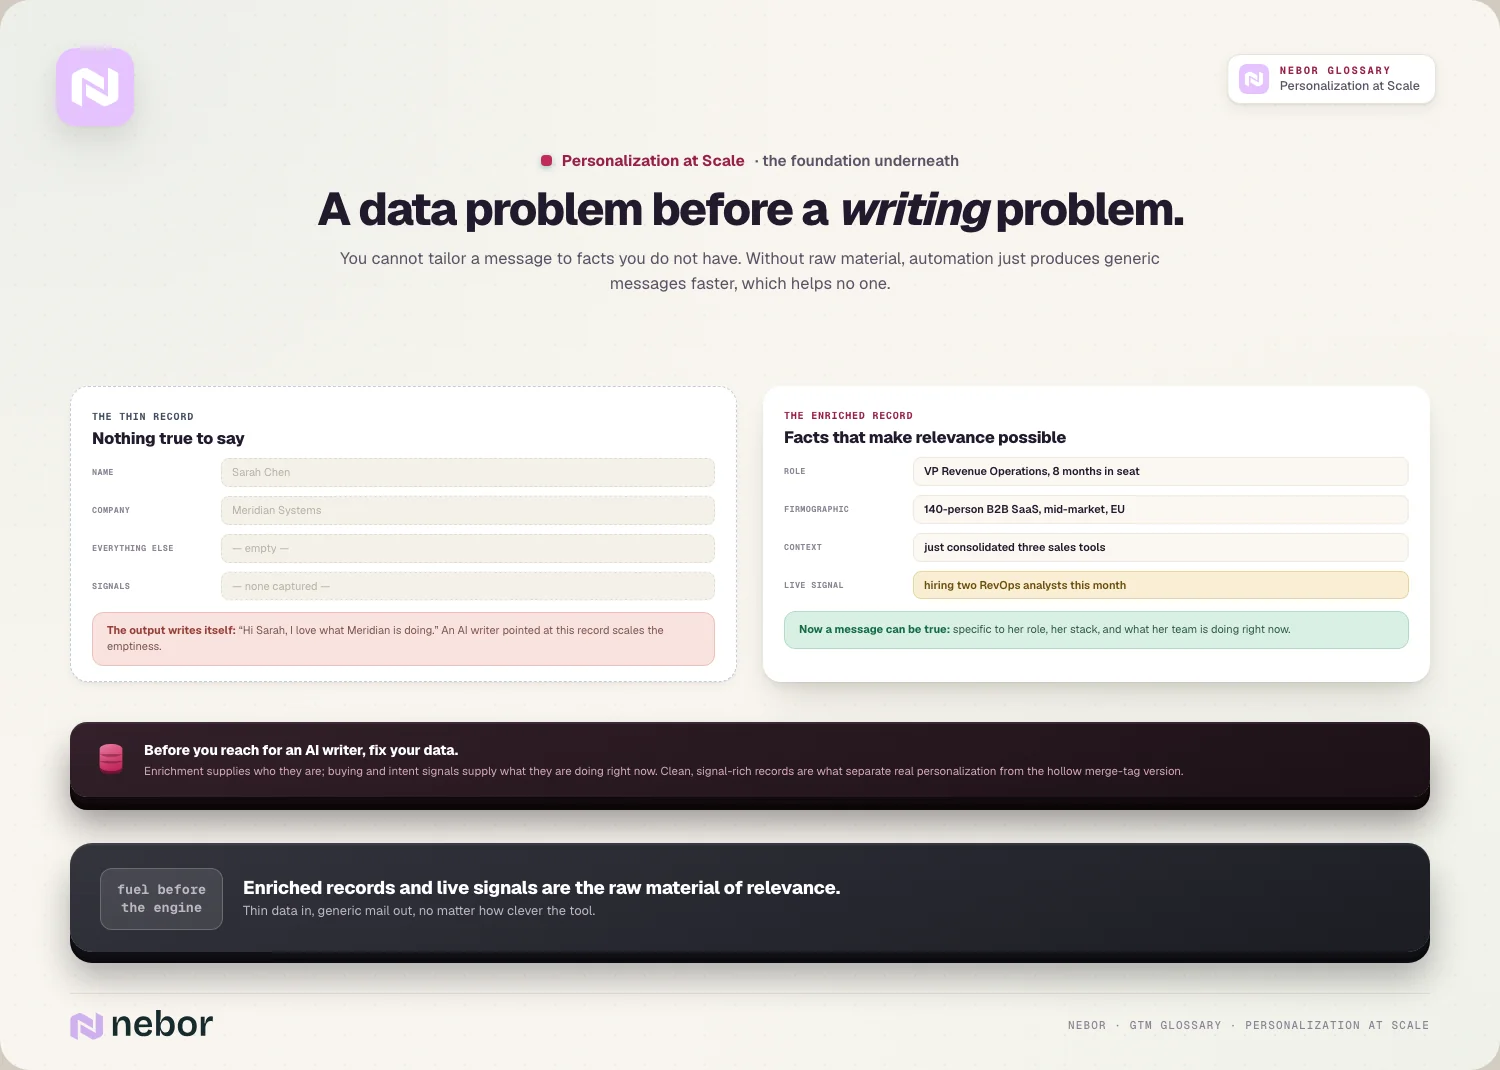
Van het eerste record naar het tweede komen is het werk van data enrichment: rol, hoe lang iemand die rol al heeft, bedrijfsgrootte, branche, techstack en recente veranderingen, automatisch opgehaald voor elk contact. De velden die de sterkste openingszinnen opleveren, zijn meestal koopsignalen en intentsignalen. Die laten zien wat een bedrijf op dit moment doet, terwijl de meeste andere velden alleen beschrijven wat het is. Een golf aan vacatures, een nieuwe leider, een investeringsronde of een piek in onderzoek naar jouw categorie geeft een bericht zowel timing als relevantie.
In Europa zit hier ook een juridische kant aan. Verzamel je persoonsgegevens van iemand uit een andere bron en wil je diegene benaderen, dan moet je volgens artikel 14 van de AVG (de GDPR) de privacyinformatie geven, inclusief waar de gegevens vandaan komen. Dat moet uiterlijk op het moment dat je voor het eerst contact hebt. De uitleg van de Britse toezichthouder over wanneer je privacyinformatie moet geven zet dit helder op een rij. In de praktijk betekent dat een korte zin en een link naar je privacyverklaring in de eerste e-mail, en enrichment-leveranciers die je ook echt kunt noemen als iemand ernaar vraagt.
Hoe een systeem voor personalization at scale draait, in vier stations
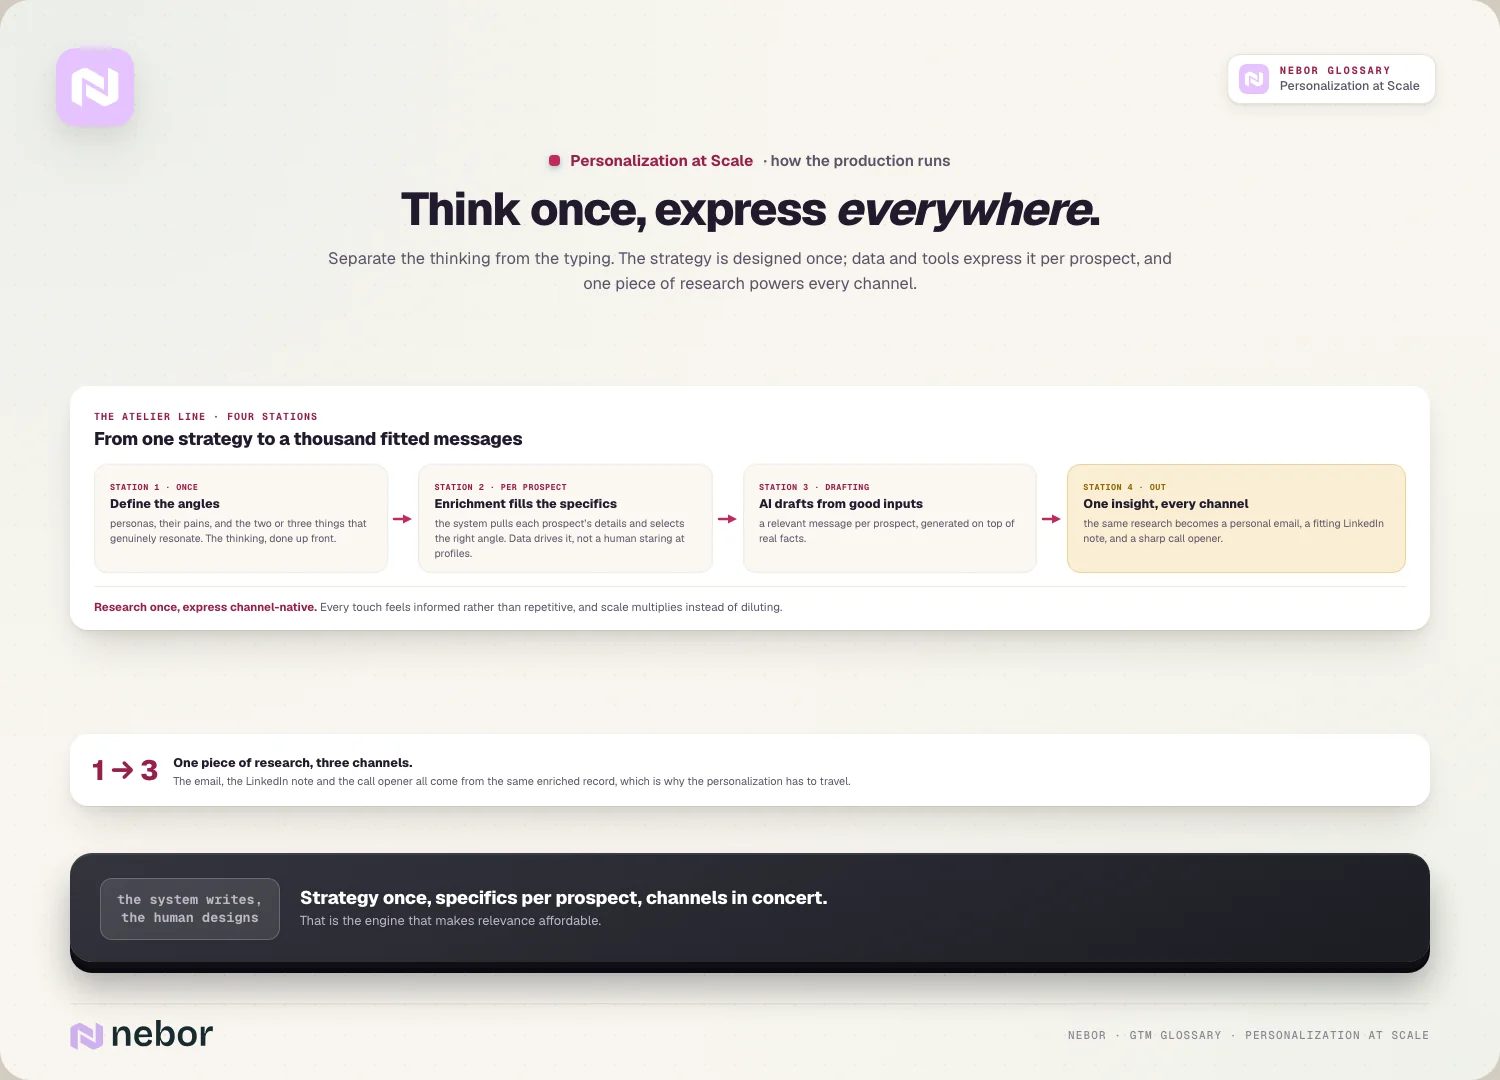
Zodra de data er is, zit de truc in het scheiden van denkwerk en typwerk. Het denkwerk gebeurt één keer. Het typwerk gebeurt per prospect, en een systeem doet daar het meeste van.
Leg de invalshoeken vast, één keer per persona. Schrijf twee of drie problemen op die elk type koper echt heeft, en welk signaal naar welk probleem wijst. Een nieuwe RevOps-leider plus het samenvoegen van tools wijst naar rapportage. Een salesteam dat snel groeit, wijst naar onboarding en territoriumplanning. Hier wordt de relevantie bepaald, en geen tool kan dat voor je doen.
Verrijk elke prospect en kies de invalshoek. Het systeem vult voor elk contact de velden in en kiest met simpele regels welke invalshoek past. Niemand hoeft naar een LinkedIn-profiel te staren om te bedenken wat hij moet zeggen.
Laat AI een concept schrijven uit die velden, en uit niets anders. Een taalmodel schrijft de openingszin of de hele e-mail op basis van de verrijkte data. Deze stap is de motor van elke AI personalization engine, en hier ontstaan de feitelijke fouten.
Hergebruik het inzicht op elk kanaal. Hetzelfde onderzoek wordt de e-mail, een kort LinkedIn-bericht en een opening voor een call. Je verstuurt ze via een afgestemde sequence voor multi-channel outreach, zodat elk contactmoment voortbouwt op het vorige.
Station drie verdient de meeste zorg. Taalmodellen produceren soms tekst die fout is of niet strookt met wat ze kregen. De gids van Anthropic over het verminderen van hallucinaties raadt twee gewoontes aan die direct op outreach van toepassing zijn: zeg tegen het model dat het alleen de aangeleverde informatie mag gebruiken, en geef het expliciet toestemming om te zeggen dat het iets niet weet. Voor een prospectingprompt betekent dat: het model schrijft alleen vanuit de verrijkte velden. Zijn die velden leeg, dan geeft het een terugvalzin die voor de persona is geschreven en verzint het geen compliment over een post die niet bestaat.
We sturen liever een goed geschreven persona-e-mail naar iemand met een mager record dan een "gepersonaliseerde" e-mail die op een gok is gebouwd. Een verkeerd feit in een openingszin doet meer kwaad dan helemaal geen persoonlijk feit. Onze gids over hoe we sales prospecting automatiseren laat zien hoe de enrichment, de prompts en de sequencer in een echte build samenhangen.
De naamwisseltest
Kopers beslissen in een seconde of twee of een e-mail voor hen is geschreven. Het loont dus om de grens tussen echte en opgepoetste personalisatie precies te trekken.
Nep-personalisatie blijft aan de oppervlakte: een voornaam in de aanhef, de bedrijfsnaam in de tweede zin en een compliment dat niets bewijst. "Hoi Sarah, ik hoop dat alles goed met je gaat. Ik kwam Meridian Systems tegen en vind het geweldig wat jullie doen." Vul een andere naam en een ander bedrijf in en het werkt nog steeds. Precies daaraan ziet de lezer dat het naar iedereen is gegaan.
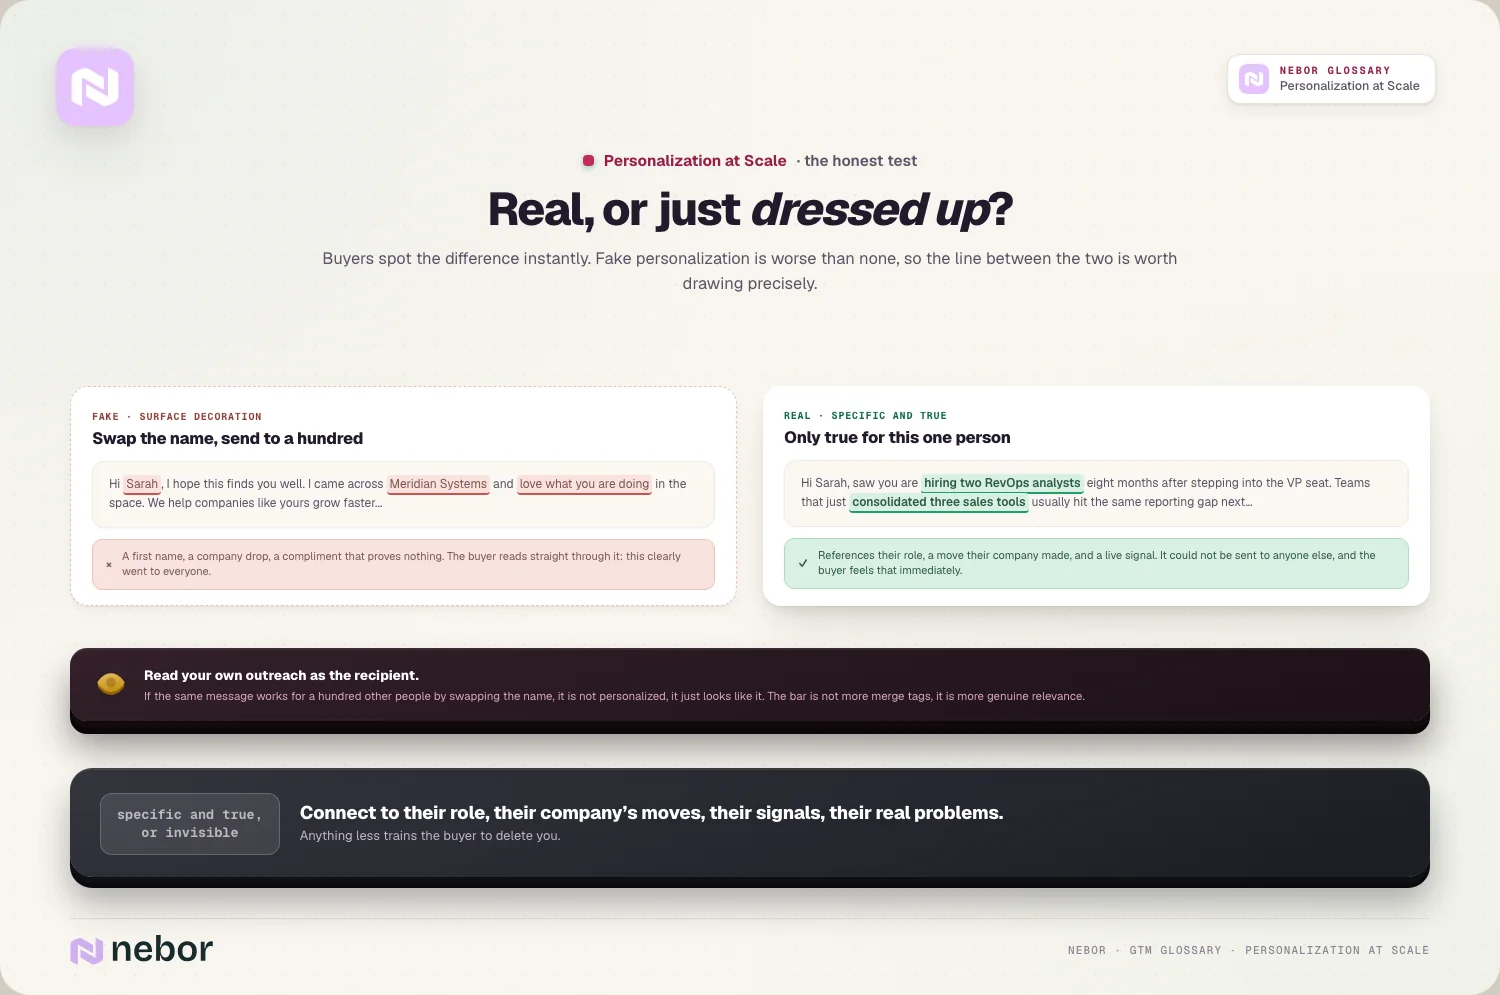
Echte personalisatie verwijst naar iets specifieks en waars. "Ik zag dat je twee RevOps-analisten zoekt, acht maanden nadat je VP werd. Teams die net drie salestools naar één platform hebben verhuisd, lopen daarna meestal tegen hetzelfde gat in de rapportage aan." Die zin kan alleen naar Sarah. Misschien krijgt hij geen reactie, maar hij belandt in elk geval niet in de prullenbak omdat hij lui is.
De gewoonte die de meeste nep-personalisatie vangt, is je eigen outreach lezen alsof je de ontvanger bent. Denk je bij de openingszin "dit is duidelijk naar iedereen gegaan", dan denkt je prospect dat ook, en krijgt de rest van de e-mail nooit een eerlijke kans.
Wat houdt de kwaliteit hoog als het volume stijgt?
De kwaliteit zakt beetje bij beetje weg naarmate het volume stijgt, tenzij je de controles vanaf het begin inbouwt. Op deze vier vertrouwen wij.
Lees steekproeven
Elke e-mail lezen hoeft niet. Wel hoort iemand er twintig of dertig uit elke batch te lezen voordat die de deur uitgaat. Zo vang je de vreemde AI-formulering, de verkeerde functietitel en de terugvalzin die veel te vaak is gebruikt (meestal een teken dat een enrichment-kolom kapot is).
Test invalshoeken op replies
Behandel elke invalshoek als een experiment en vergelijk het percentage positieve replies. Opens laat je om de redenen hierboven buiten beschouwing. Wint één invalshoek duidelijk voor een segment, zet dan meer van dat segment op die invalshoek. Hetzelfde instinct geldt eerder in het proces, bij je list building: segmenten die op geen enkele invalshoek reageren, zitten vaak op de verkeerde lijst. Een ander bericht helpt dan weinig.
Houd de data vers
Mensen wisselen van baan, bedrijven stoppen met werven en signalen koelen af. Een record dat zes maanden geleden is verrijkt, kan een openingszin opleveren die in het voorjaar klopte en nu gênant is. Verrijk opnieuw volgens een vast schema en vóór elke grote verzending.
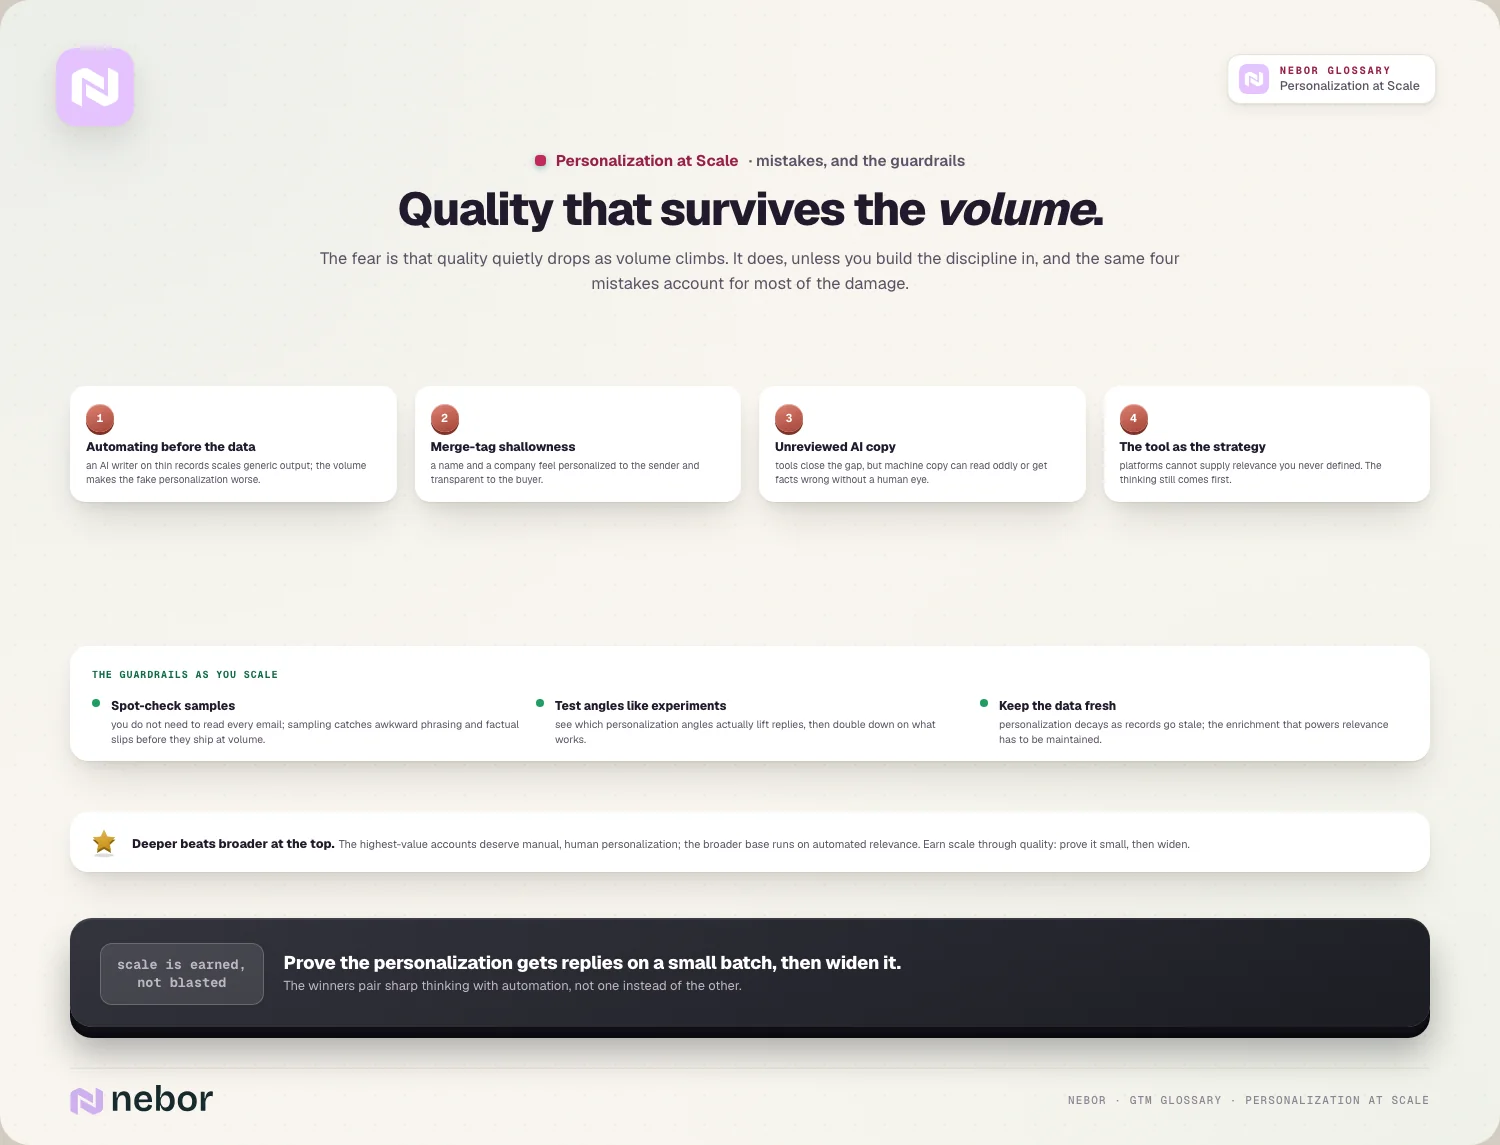
Schrijf voor je topaccounts met de hand
Niet elk account verdient dezelfde behandeling. Je ideal customer profile vertelt je welke accounts het waard zijn dat iemand er twintig minuten aan besteedt, en die krijgen handmatig onderzoek en een zelfgeschreven bericht. De bredere basis draait op het geautomatiseerde systeem. Haal je de twee lagen door elkaar, dan verspil je aan de ene kant moeite en aan de andere kant kwaliteit.
Achter alle vier zit dezelfde waarschuwing. Het platform levert geen relevantie die je zelf nooit hebt gedefinieerd, en een veelvoorkomende reden dat Clay-implementaties mislukken is dat teams verwachten dat de tool de invalshoeken bedenkt. Station één blijft werk voor een mens.
Samenvatting
Personalization at scale werkt als het systeem het graafwerk doet en een mens bepaalt wat het zeggen waard is. Draai je dat om, dan maak je alleen generieke e-mail sneller. En generieke e-mail is duurder dan vroeger, omdat spamklachten tegen je domein tellen en open rates je niet meer vertellen wie iets heeft gelezen.
De volgorde telt. Eerst komen verrijkte records en actuele signalen, daarna een paar invalshoeken die echt bij elk type koper passen, dan AI-concepten die zich aan de aangeleverde feiten houden, en tot slot hetzelfde inzicht via elk kanaal. De kwaliteitscontroles lopen vanaf het begin mee.
Daar is een goed gebouwd go-to-market-systeem voor. Wil je er een? Wij bouwen de enrichment, de prompts en het versturen in je eigen Clay, CRM en sequencer, en dragen het over met de invalshoeken op papier. Zo kan je team ze blijven aanscherpen nadat wij een stap terug hebben gedaan.
Veelgestelde vragen
Wat is het verschil tussen personalization at scale en hyperpersonalisatie?
Hyperpersonalisatie draait om diepgang: gedetailleerde, vaak actuele context over één prospect in een bericht verwerken, zodat het voelt alsof het alleen voor die persoon is geschreven. Personalization at scale draait om bereik: elk bericht relevant houden over honderden of duizenden prospects zonder dat de inspanning instort. De meeste moderne outbound mikt op allebei. Zie diepgang dus als de ambitie en volume als de beperking, met goede data als de verbinding tussen de twee.
Werkt personalization at scale ook voor inbound en warme leads?
Ja, en daar betaalt het zich vaak sneller terug. Als iemand een gids downloadt, de prijspagina bezoekt of een demo boekt, weet je al wat diegene deed en waarom het hem kan interesseren. Hetzelfde systeem dat koude prospects verrijkt, kan ook een inbound contact verrijken, de actie lezen die hem binnenbracht en een follow-up opstellen die daarop aansluit. Je ideal customer profile bepaalt daarna wie een reactie van een mens krijgt en wie een geautomatiseerde.
Hoe begin je met personalization at scale in een klein team?
Begin met één segment van een paar honderd goed passende contacten en laat de rest van je database nog even liggen. Verrijk ze goed, schrijf twee of drie invalshoeken op die echt tellen voor die persona en verstuur een kleine batch met openingszinnen die AI opstelt en een mens nakijkt. Vergelijk de positieve replies met je gebruikelijke template. Voer het volume pas op als de gepersonaliseerde versie duidelijk wint, en blijf steekproeven controleren terwijl je groeit.
Kan AI zelfstandig gepersonaliseerde cold e-mails schrijven?
AI kan ze goed opstellen, al hoort het niet zonder toezicht te draaien. Taalmodellen beweren soms dingen die niet kloppen, vooral als de input mager is en de prompt om een persoonlijke touch vraagt. Geef het model alleen de verrijkte velden, zeg dat het niets anders mag gebruiken, geef het een terugvalzin voor lege records en laat een mens uit elke batch een steekproef lezen voordat die de deur uitgaat.
Welke datapunten leveren de beste personalisatie op?
Feiten die veranderen en die aansluiten op een probleem dat jij oplost, werken meestal het best. Recente vacatures, een nieuwe leider in de rol van de koper, een investeringsronde, een overstap naar een andere tool of een uitbreiding naar een nieuwe markt geven een bericht allemaal timing en relevantie. Vaste gegevens zoals branche en bedrijfsgrootte helpen je de invalshoek te kiezen. Op zichzelf maken ze een openingszin zelden interessant.
Mag je onder de AVG outreach personaliseren met verrijkte data?
Dat kan, al brengt enrichment verplichtingen mee. Als persoonsgegevens van een derde partij komen en niet van de persoon zelf, verplicht artikel 14 van de AVG (de GDPR) je om te vertellen wie je bent, waarom je de gegevens verwerkt en waar ze vandaan komen, uiterlijk bij je eerste contact. Je hebt ook een rechtsgrond nodig, bij B2B-outreach vaak het gerechtvaardigd belang, en die moet je afwegen en vastleggen. Vraag juridisch advies voor jouw eigen situatie.
Verbetert personalisatie je e-maildeliverability?
Indirect. Mailboxproviders belonen een voornaam in de aanhef niet. Ze letten wel op hoe ontvangers reageren. Relevante e-mail krijgt minder spammeldingen en meer replies, en Gmail vraagt afzenders om de spamratio in Postmaster Tools onder 0,3% te houden. Ontbrekende SPF-, DKIM- of DMARC-records lost personalisatie wel niet op, dus authenticatie en een schone lijst komen nog steeds eerst.
Zijn merge tags nog de moeite waard in cold e-mail?
Voor de basis wel. Een juiste voornaam en bedrijfsnaam worden verwacht, en ze fout hebben (of een kale first_name-placeholder zichtbaar laten staan) is erger dan ze weglaten. Wat merge tags in hun eentje niet kunnen, is een bericht persoonlijk laten voelen. Zie ze als basishygiëne en steek je energie in één specifieke, ware zin over de situatie van de persoon die geen template had kunnen maken.
Welke tools gebruik je voor personalization at scale?
Een typische stack heeft drie lagen. Enrichment- en signaaltools, vaak aangestuurd vanuit Clay, halen de feiten over elk contact op. Een taalmodel, meestal aangeroepen vanuit Clay of de sequencer, maakt van die feiten openingszinnen of volledige concepten. Een sequencer zoals Instantly, lemlist of HeyReach verstuurt de berichten en houdt de replies bij, het liefst gesynchroniseerd met je CRM. De tools doen er minder toe dan de invalshoeken en de data die erin gaan.
Deel dit bericht
Personalization
Outbound
AI
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen
Automatisering
AI personalization engine
Een AI personalization engine is een systeem dat afstemt wat elke persoon krijgt, en bepaalt wat je zegt, tegen wie en wanneer, op basis van hun data, gedrag en live signalen.
Automatisering
Data enrichment
Data enrichment is het aanvullen van contact- en accountrecords met ontbrekende of bijgewerkte gegevens uit externe bronnen, zodat een dun record met alleen een e-mailadres of domein een volledig, bruikbaar profiel wordt.
Automatisering
Dynamische content
Dynamische content is e-mail- of pagina-inhoud die automatisch verandert per ontvanger, op basis van diens data, gedrag of context, met variabelen en voorwaardelijke blokken binnen één bericht.
Automatisering
Multi-channel outreach
Multi-channel outreach is dezelfde prospect benaderen via meerdere kanalen, zoals e-mail, LinkedIn en telefoon, in een geplande en afgestemde volgorde, zodat je kopers bereikt waar ze echt opletten.
Klaar om je pipeline te bouwen