In this post:
Een AI-agent is software die je een doel geeft in plaats van een script. Een taalmodel bepaalt de volgende stap, gebruikt een tool om die stap te zetten, bekijkt wat er terugkomt en beslist opnieuw. Zo gaat hij door tot het doel bereikt is of tot hij de taak teruggeeft aan een mens.
Dat het model zelf zijn stappen kiest, onderscheidt een agent van het meeste wat onder die naam wordt verkocht. Leg je de stappen zelf vast en doet een model alleen het werk binnen een of twee daarvan, dan heb je een AI-workflow gebouwd. Voor de meeste sales- en marketingtaken is dat het betere gereedschap.
Het label wordt flink opgerekt. Gartner heeft er zelfs een naam voor, "agent washing": chatbots, assistenten en RPA-tools die opnieuw als agent worden verpakt. Volgens een schatting van Gartner zijn maar zo'n 130 van de duizenden aanbieders van agentic AI echt. Check dus eerst of een agent wel een agent is, voordat je beoordeelt of hij goed is.
TL;DR
Een AI-agent kiest zelf zijn volgende stap. Een chatbot antwoordt en stopt, een copilot wacht op jou, een RPA-bot herhaalt een script en een AI-workflow volgt het pad dat jij hebt uitgetekend. Alleen de agent gooit het roer om als hij iets onverwachts tegenkomt.
Kijk naar één run en het verschil is meteen duidelijk. Vraag een agent om een accountbriefing en als hij het aantal medewerkers niet vindt, probeert hij een andere bron. Spreken twee cijfers elkaar tegen, dan meldt hij dat. Een vaste pijplijn laat het veld leeg of kiest er een zonder het je te vertellen.
De gids van OpenAI over het bouwen van agents noemt drie onderdelen (een model, tools en instructies). In de praktijk heb je ook geheugen nodig en een lus met een duidelijke uitgang. Het model is het makkelijkste onderdeel om te vervangen. De tools en de data die hij leest, bepalen hoe goed hij kan worden.
In GTM doen agents het best bij onderzoekswerk met een duidelijke input en een output die je kunt controleren, zoals accountbriefings, gaten in records vullen, het CRM opschonen en eerste concepten. Veel van dat voorwerk valt binnen de 70% van hun tijd die reps in de enquête van Salesforce uit 2024 naar eigen zeggen kwijt zijn aan taken die niets met verkopen te maken hebben.
Agents kosten meer per run, geven bij elke run een ander antwoord en laten kleine fouten zich opstapelen. Gartner verwacht dat eind 2027 meer dan 40% van de agentic AI-projecten is geschrapt. Zet er dus alleen een in waar het pad echt van geval tot geval verschilt.
Geef je eerste agent één smalle taak met een duidelijke finish, laat hem concepten schrijven in plaats van versturen en laat hem stoppen voor een mens vóór alles wat hij niet kan terugdraaien. Houd bij hoe vaak reps zijn output moeten aanpassen en geef hem pas meer vrijheid als dat cijfer daalt.
Agent of niet? Kijk wie de volgende stap kiest
Elke tool in deze markt gebruikt ergens een taalmodel, dus "het gebruikt AI" zegt niets. De nuttige vraag is wie bepaalt wat er daarna gebeurt, en wat de tool doet als de werkelijkheid niet met het plan overeenkomt.
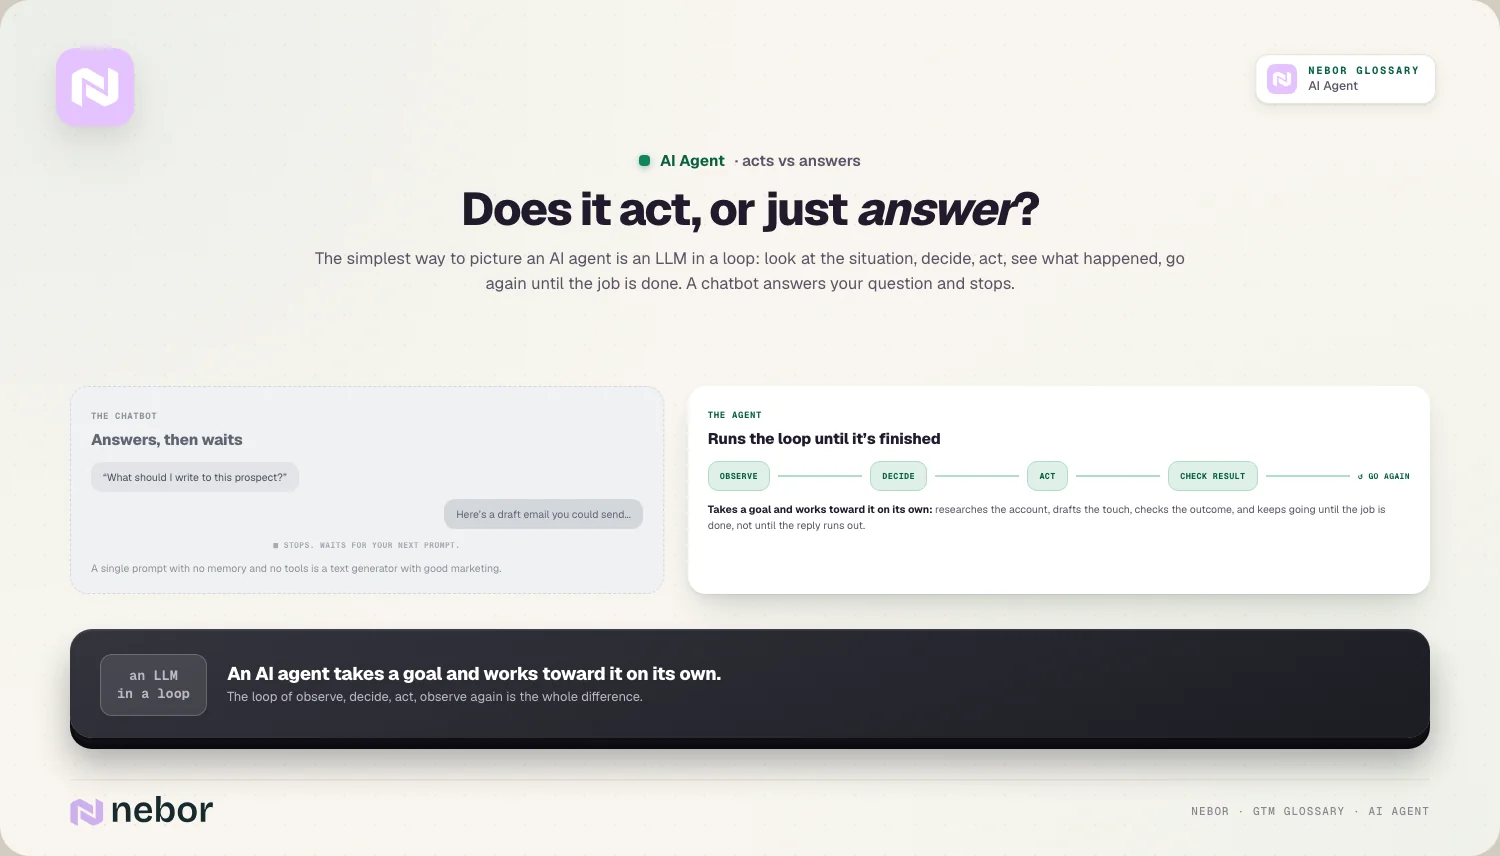
OpenAI trekt de grens op dezelfde plek. Volgens zijn praktische gids voor het bouwen van agents zijn apps die een model gebruiken zonder het te laten bepalen hoe het werk verloopt, zoals simpele chatbots, losse prompts of sentimentclassifiers, geen agents. Zet je de buren naast elkaar, dan ziet dat er zo uit.
Tool | Wie bepaalt de volgende stap | Wat er gebeurt als er iets onverwachts opduikt |
|---|---|---|
Chatbot of assistent | Jij, bij elke beurt | Hij beantwoordt je vraag en wacht op de volgende prompt |
Copilot | Jij, met suggesties van het model | Hij doet een nieuwe suggestie, en jij blijft sturen |
RPA-bot | Het script | Hij breekt zodra een paginalayout of een veld verandert |
AI-workflow | Jij, toen je hem bouwde | Een modelstap vangt een vreemde input misschien op, maar de route blijft hetzelfde |
AI-agent | Het model, terwijl hij draait | Hij kiest een andere actie en probeert het opnieuw |
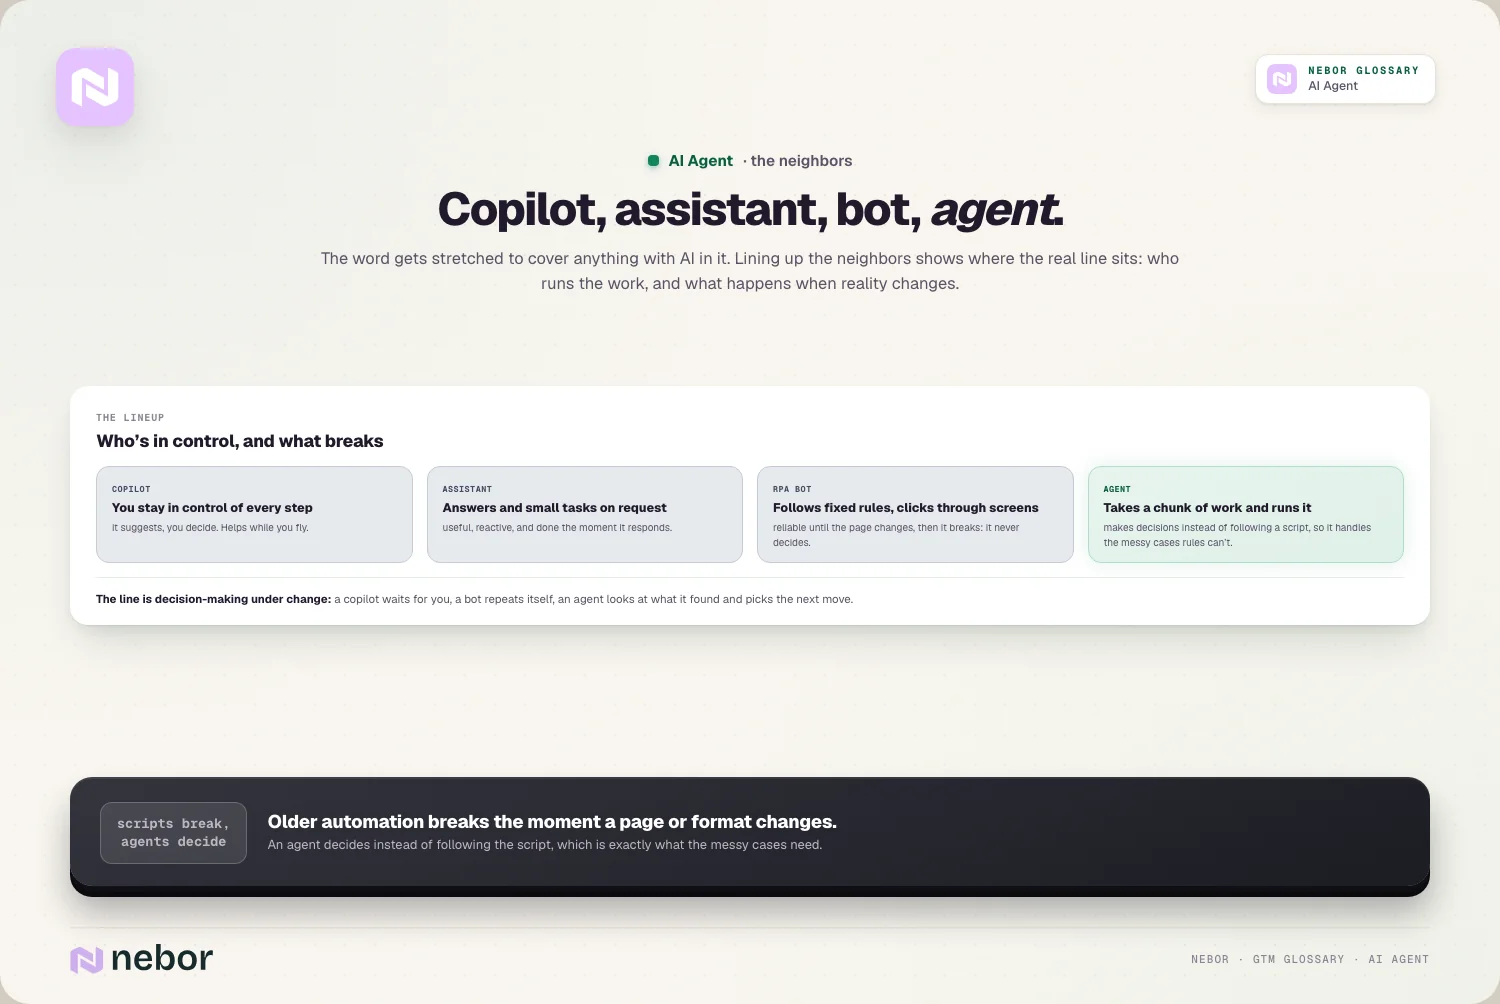
De laatste twee rijen worden het vaakst door elkaar gehaald, omdat ze hetzelfde model kunnen gebruiken en in dezelfde tool kunnen zitten. Een Clay-tabel met een kolom die een openingszin schrijft, is een workflow. Een Clay-kolom die het prijsmodel van een bedrijf moet vinden en zelf bepaalt welke pagina's hij daarvoor opent, is een agent binnen die workflow. Het verschil is of het model zijn eigen route mag kiezen.
Eén accountbriefing, van begin tot eind
Dit is een run die we typisch zouden noemen, met een verzonnen bedrijf. Een rep heeft morgen een call met Brightlane Logistics en vraagt een agent om een briefing van één pagina over vijf dingen: wat ze verkopen, het aantal medewerkers, de naam van hun salesleider, welk CRM ze gebruiken en één recente reden om contact op te nemen.
De agent begint op de website van Brightlane en heeft de productlijnen meteen te pakken. Het aantal medewerkers staat niet op de site, dus roept hij een enrichment-provider aan, die met 240 medewerkers terugkomt. Hij checkt ook de LinkedIn-pagina van het bedrijf, en daar staat 180. In plaats van er een te kiezen, houdt hij ze allebei aan en noteert hij dat ze verschillen.
De teampagina noemt geen salesleider, dus gaat de agent zoeken in vacatures. Hij vindt een vacature voor twee SDR's waarin staat dat ze aan de Head of Sales rapporteren, en die HubSpot noemt bij de functie-eisen. Daarmee is de CRM-vraag ook beantwoord, dus slaat hij de technologie-lookup over die hij anders had gedaan. Een persbericht van vorige maand over een nieuw magazijn bij Rotterdam levert de reden om contact op te nemen.
Dan stopt hij, omdat alle vijf de velden zijn ingevuld of gemarkeerd. In de briefing staat bij het aantal medewerkers "180 tot 240, bronnen spreken elkaar tegen" en bij de salesleider "Head of Sales, naam niet bevestigd".
Een vaste pijplijn had elke keer dezelfde vijf lookups in dezelfde volgorde gedraaid. Die had de salesleider leeg gelaten, het aantal medewerkers overgenomen dat de provider teruggaf en betaald voor een technologie-lookup die niet nodig was. De agent verdiende zijn kosten terug op de momenten waarop hij van plan veranderde.
Op diezelfde momenten kan het ook misgaan. Dezelfde vrijheid waarmee hij een vacature las, kan hem een persbericht van twee jaar oud laten geloven, of hem bij de verkeerde Brightlane laten uitkomen. Daarom hoort de briefing zijn bronnen te tonen en te markeren wat hij niet kon bevestigen, en daarom leest een rep hem voor de call.
De onderdelen van een AI-agent, en het onderdeel dat overschat wordt
De gids van OpenAI deelt een agent op in drie kernonderdelen. Er is het model dat redeneert en beslissingen neemt, er zijn de tools die hij kan aanroepen om te handelen, en er zijn de instructies die vastleggen hoe hij zich moet gedragen en waar zijn grenzen liggen. De documentatie van n8n zegt het korter en beschrijft een agent als een keten die weet hoe hij beslissingen neemt.
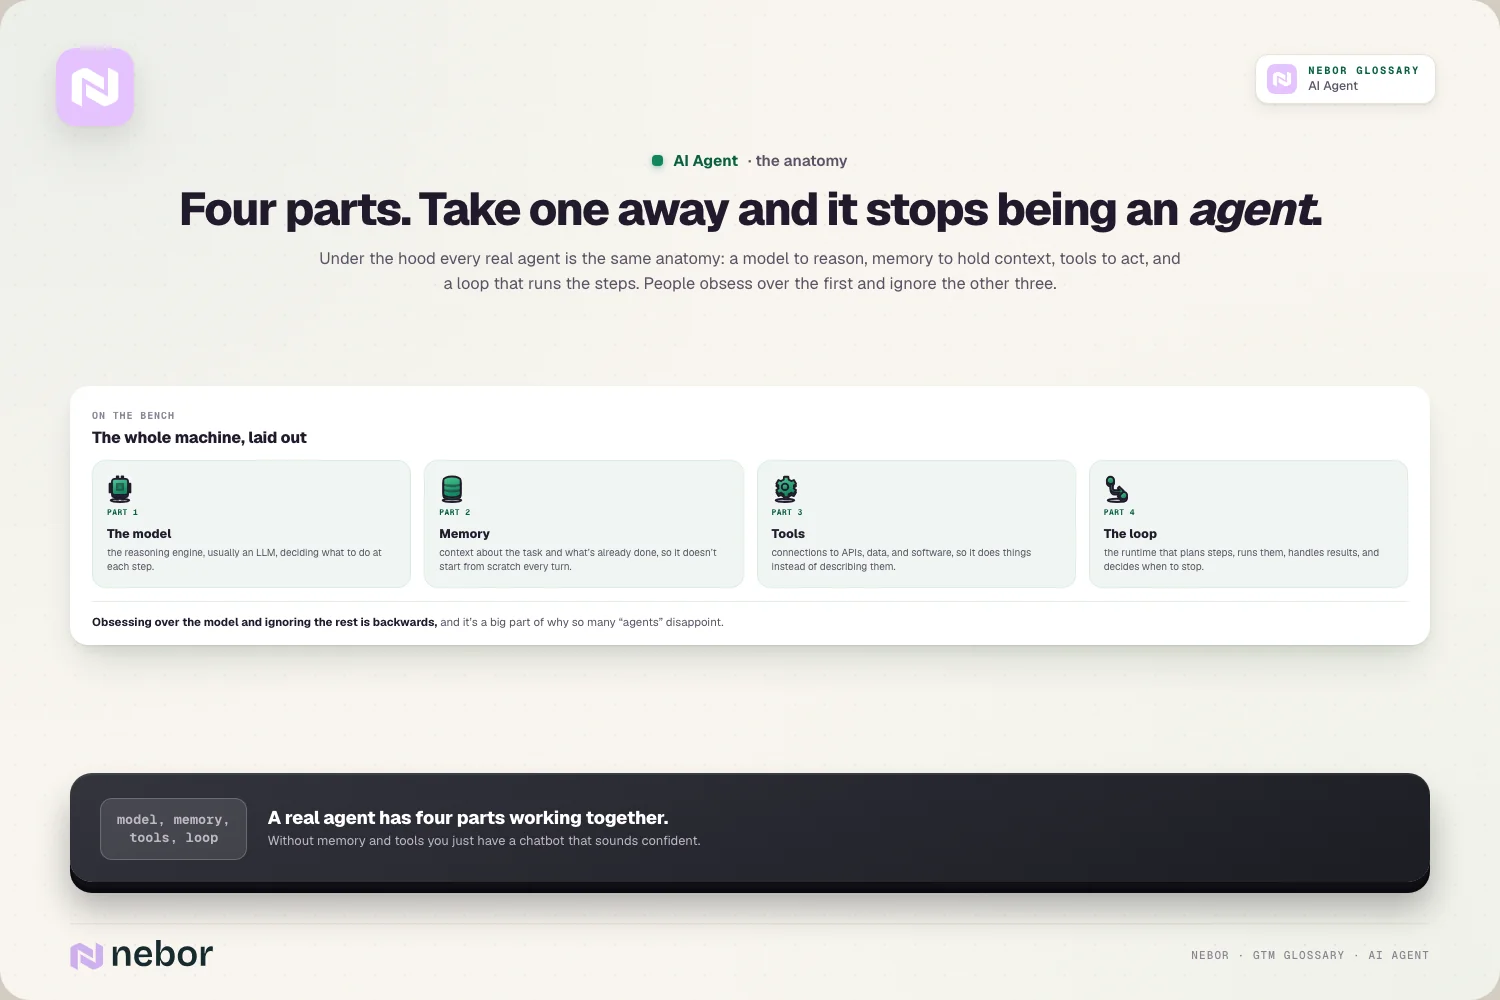
In de praktijk tellen wij vier werkende onderdelen, met de instructies als de functieomschrijving die ze bij elkaar houdt.
Het model leest de situatie en kiest de volgende actie.
Geheugen houdt vast wat de agent al heeft gevonden, zodat hij niet twee keer dezelfde pagina ophaalt of iets tegenspreekt wat hij drie stappen eerder leerde.
Tools zijn de koppelingen met zoekmachines, enrichment-providers, je CRM en alles waar hij verder uit kan lezen of naar kan schrijven.
De lus voert de stappen uit en controleert de resultaten. Die lus heeft een uitgang nodig: een definitie van klaar, een maximum aantal pogingen en een punt waarop de agent opgeeft en overdraagt.
De meeste aandacht gaat naar het model, en dat doet er het minst toe. Je wisselt een model in een middag om voor een nieuwer exemplaar. De kwaliteit van wat hij leest, verander je minder makkelijk. Een agent die werkt met verouderde of dunne data neemt vol vertrouwen verkeerde beslissingen, alleen sneller dan een mens dat zou doen.
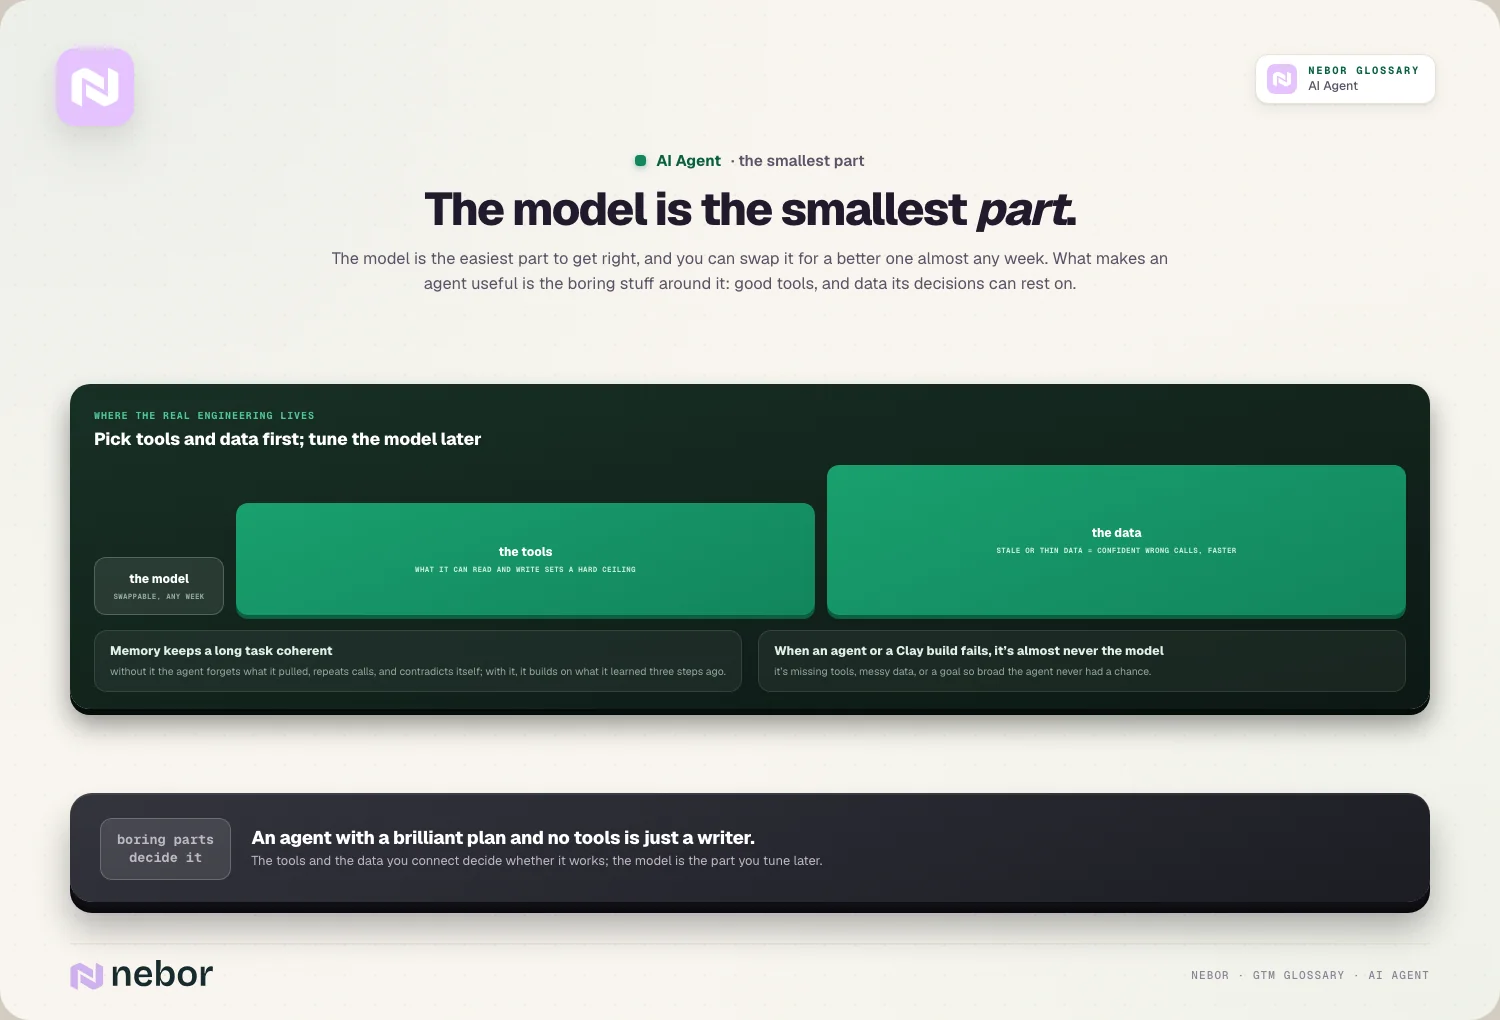
Tools bepalen op dezelfde manier het plafond. In de Brightlane-run kon de agent alleen vacatures checken omdat hij een zoektool had, en alleen twee cijfers voor het aantal medewerkers afwegen omdat hij twee bronnen had. Als een agent of een Clay-build mislukt, ligt het bijna altijd aan een ontbrekende tool, rommelige data of een doel dat zo los was dat de agent nergens kon stoppen. Het model is zelden de oorzaak.
Waar AI-agents nuttig zijn in een GTM-stack
De taken die bij agents passen, hebben dezelfde vorm. De input is duidelijk, de route naar het antwoord verschilt per record, en een mens kan de output in een paar seconden controleren. Accountonderzoek, ontbrekende velden invullen, dubbele records matchen bij het opschonen van je CRM en een eerste gepersonaliseerde versie passen daar allemaal in.
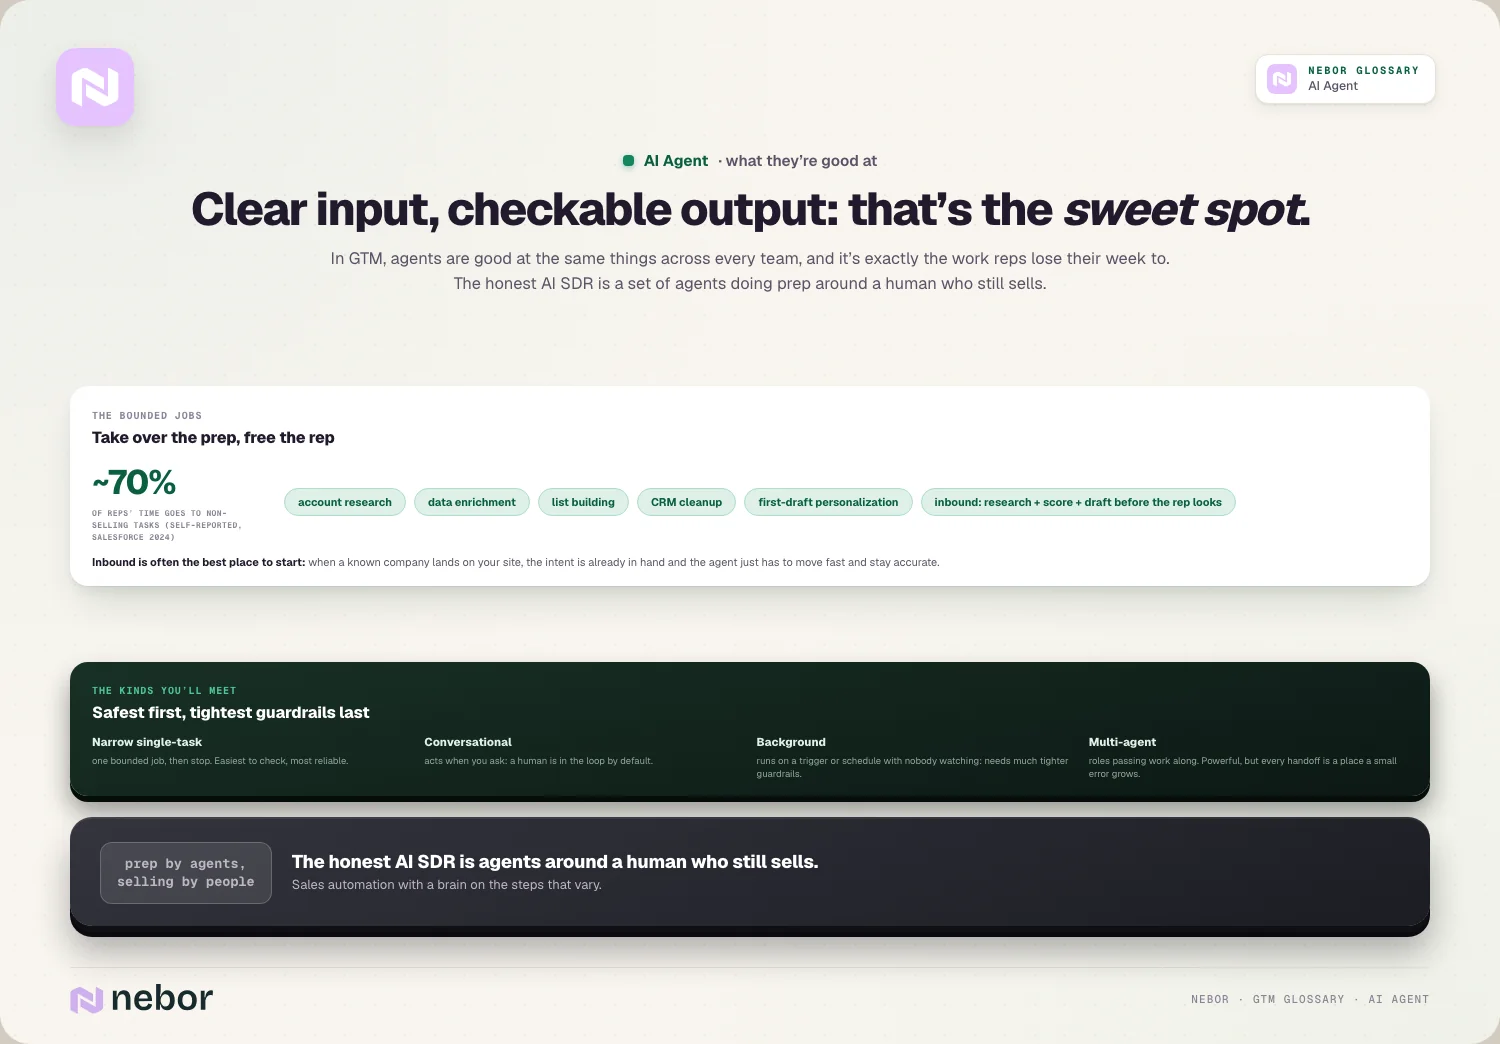
Daar raken reps ook hun week kwijt. In de State of Sales-enquête van Salesforce uit 2024 onder 5.500 salesprofessionals zeiden reps dat 70% van hun werkuren opgaat aan andere dingen dan verkopen. Het is een zelf gerapporteerd cijfer van een bedrijf dat AI-tools verkoopt, dus zie het als een ruw beeld. Het klopt wel met wat wij zien en met wat we schreven over sales prospecting automatiseren. We zijn ook één voor één nagegaan welke prospectingtaken je aan een machine kunt overlaten.
De onderzoeksagent van Clay is de agent die de meeste GTM-teams als eerste tegenkomen. Hoe hij zich in de praktijk gedraagt, behandelen we in onze gids over Claygent. Die draait als kolom en doet voor elke rij een nieuw stukje webonderzoek.
Inbound is vaak de makkelijkste plek om te beginnen, omdat de koper zich al heeft laten zien. Komt een bekend bedrijf op je prijspagina, dan kan een agent het onderzoeken, de fit checken en een eerste bericht opstellen voordat de rep de melding opent. Onze workflows voor websitebezoekers gebruiken precies dit soort afgebakende agent.
Zo ziet een eerlijke AI SDR er ook uit. Het is een set agents die het voorwerk doet rond een mens die nog steeds zelf verkoopt. Dat maakt het sales automation met een model op de stappen die per geval verschillen. Een robot die deals sluit, is het nooit geweest.
Smalle agents die één afgebakende taak doen en dan stoppen, zijn het veiligst. Achtergrondagents die op een trigger afgaan terwijl niemand meekijkt, hebben veel strakkere grenzen nodig. Combineer je meerdere agents met vaste stappen, dan krijg je een agentic workflow, de bouwsteen van wat mensen bedoelen met agentic AI. Elke overdracht daarin is een plek waar een kleine fout kan groeien. Laat het daarom draaien binnen dezelfde workfloworkestratie als de rest van je stack, waar je kunt zien wat elke agent deed.
Waarom de meeste taken geen agent nodig hebben
Vrijheid heeft een prijs. Een agent doet meer aanroepen dan een vaste stap, kan bij elke run een andere route nemen, en een vroege fout werkt door in elke beslissing die daarna komt.
De voorspelling van Gartner is duidelijk over waar dat op uitdraait. Gartner verwacht dat eind 2027 meer dan 40% van de agentic AI-projecten is geschrapt, door stijgende kosten, onduidelijke zakelijke waarde en zwakke risicobeheersing. De analist noemt de meeste huidige projecten vroege experimenten die door hype worden gedreven en vaak verkeerd worden ingezet.
De leveranciers die agents bouwen, zeggen ongeveer hetzelfde. De gids van OpenAI raadt aan om agents te bewaren voor werk waar regels tekortschieten: beslissingen die oordeel vragen, regelsets die te complex zijn geworden om te onderhouden en taken die draaien op rommelige tekst zoals e-mails en documenten. Voor al het andere is een deterministische aanpak volgens de gids misschien genoeg.
Vertaald naar GTM: kun je de stappen op een whiteboard tekenen en zijn ze voor elk record hetzelfde, bouw dan een vaste AI-workflow en gebruik een model alleen op de stappen die taal of oordeel vragen. Dat is goedkoper, het gedraagt zich elke dag hetzelfde en als het breekt, vind je de kapotte stap binnen een paar minuten. Bewaar de agent voor de stap waar de route zelf afhangt van wat er opduikt.
De riskantste versie is degene die leveranciers het liefst demonstreren: een agent die cold e-mails schrijft en verstuurt zonder dat iemand meekijkt. Autonome outbound zonder toezicht vergroot vooral de fouten die de agent maakt, en die belanden rechtstreeks in de inbox van je kopers en drukken op je domeinreputatie.
De eerste taak afbakenen, en hoeveel vrijheid je hem geeft
De beste voorspeller van of een agent werkt, is hoe strak de taak is afgebakend. "Maak een briefing van één pagina over dit account met deze vijf velden" heeft een finish die de agent kan halen en die jij kunt controleren. "Verbeter onze outbound" is een wens, en een agent die een wens krijgt, gaat dwalen en maakt ondertussen kosten.
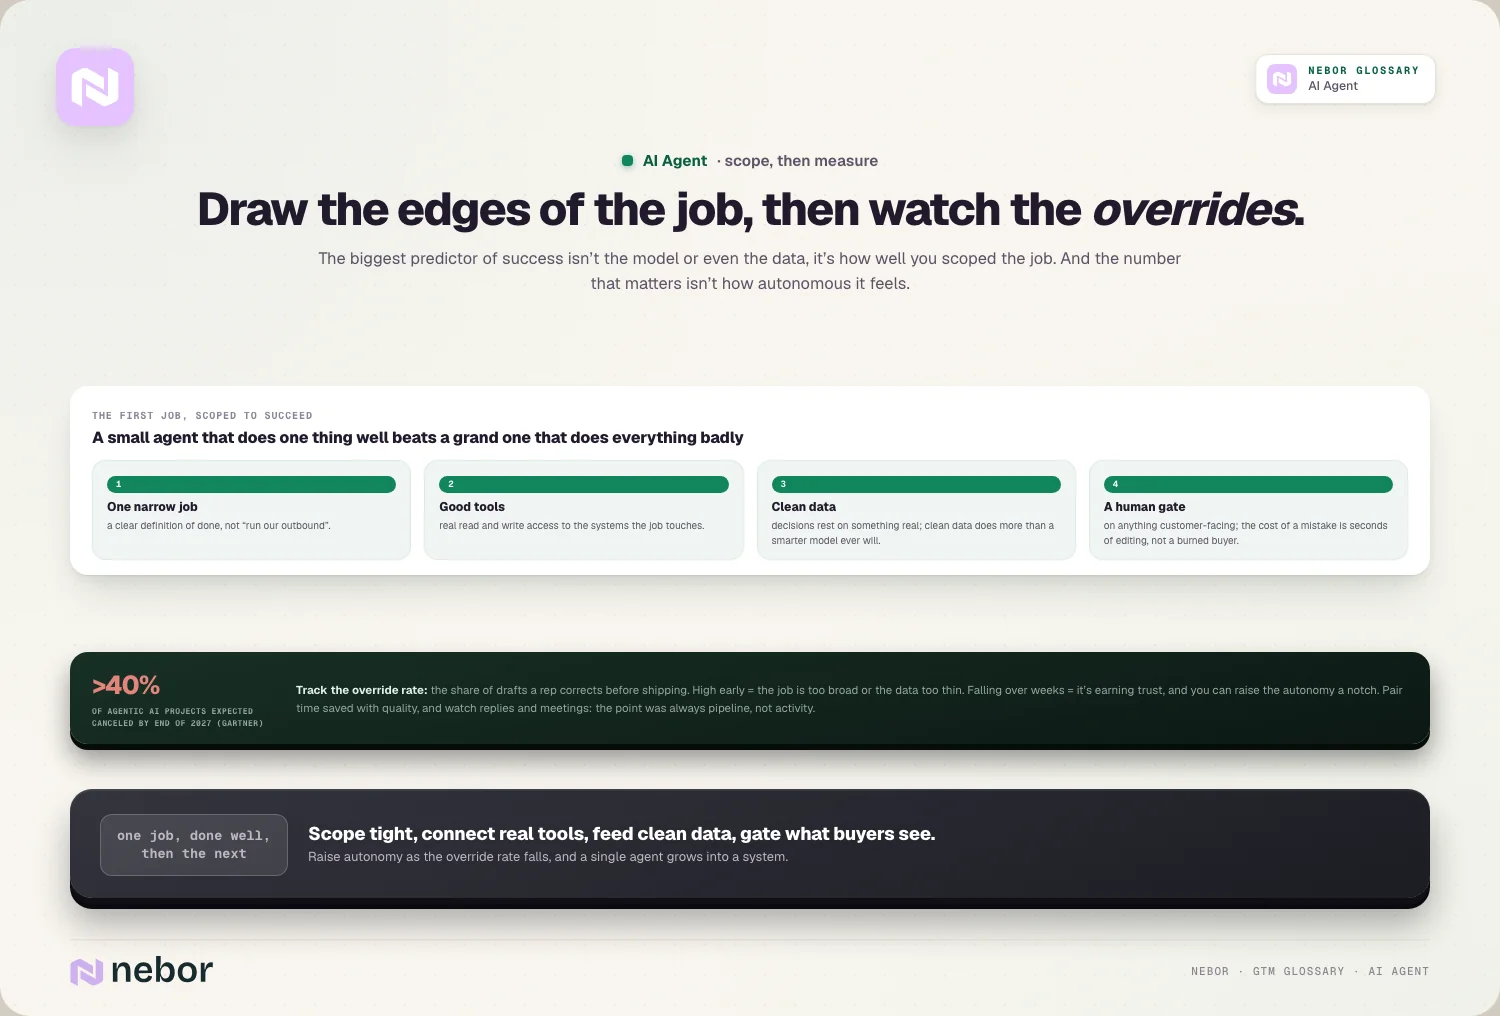
Kies een eerste taak waarbij fouten goedkoop en makkelijk te zien zijn, zoals onderzoeksnotities of conceptteksten die een rep toch al leest. Bepaal daarna hoeveel de agent zelfstandig mag doen, en begin laag.
Hij schrijft concepten en een mens doet de rest. Begin hier bij alles wat een koper te zien kan krijgen.
Hij handelt zelfstandig, maar pauzeert voor alles wat hij niet kan terugdraaien, zoals een e-mail versturen of een CRM-veld overschrijven.
Hij handelt een hele afgebakende taak af en legt alleen de gevallen voor waarover hij twijfelt.
De gids van OpenAI noemt twee momenten waarop een agent aan een mens moet overdragen: als hij een limiet op het aantal pogingen of mislukte pogingen overschrijdt, en vóór acties die gevoelig, onomkeerbaar of riskant zijn. Allebei laten zich direct vertalen naar saleswerk. Beperk het aantal zoekopdrachten dat een agent op één account mag doen, en zet een human in the loop vóór alles wat je domein verlaat.
Om te bepalen wanneer je een niveau hoger gaat, houd je het correctiepercentage bij (de override rate): het deel van de concepten of beslissingen van de agent dat een rep aanpast voordat hij ze gebruikt. Een hoog percentage in de eerste weken betekent meestal dat de taak te breed is of de data te dun. Dat de agent hopeloos is, betekent het zelden. Daalt het en blijft het laag, geef de agent dan het volgende niveau van vrijheid, of een tweede taak.
Check de data voordat je de agent de schuld geeft. Een bescheiden model op een CRM met actuele functietitels en zonder dubbele records verslaat een topmodel op een rommelig CRM, omdat de agent geen gevoel heeft voor een record dat er verkeerd uitziet. Basale CRM-hygiëne hoort gewoon bij de opzet.
Samenvatting
Een agent is zijn kosten alleen waard waar de route naar het antwoord van geval tot geval verandert. Overal anders doet een vaste reeks stappen met een model op de lastige delen het werk goedkoper en voorspelbaarder. Veel van wat als agent wordt verkocht, blijkt precies dat te zijn.
Verschilt de route echt, zoals bij accountonderzoek of het ontwarren van een rommelig record, dan kan een agent werk doen waar vroeger een mens voor nodig was. Het model doet er minder toe dan het lijkt. Zijn tools, de staat van je data, een finish die hij kan herkennen en een mens die alles controleert wat een koper te zien krijgt, bepalen of hij nuttig is of alleen duur.
Houd de eerste taak klein genoeg om te controleren en verbreed hem pas als het correctiepercentage zegt dat het kan. Een smalle agent die één ding betrouwbaar doet, leert je meer dan een brede die alles een beetje fout doet.
Wil je hulp? Wij bouwen agents en de workflows eromheen bovenop je huidige CRM en datatools, met de prompts, limieten en overdrachtsmomenten op papier. Daarna dragen we het geheel over aan je team, dat het zelf draait.
Veelgestelde vragen
Wat is het verschil tussen een AI-agent en agentic AI?
Een AI-agent is één eenheid: een model met tools en geheugen dat naar één doel toewerkt en zelf zijn stappen bepaalt. Agentic AI is het bredere idee van systemen die uit agents bestaan, vaak meerdere die binnen een groter proces werk aan elkaar doorgeven. Zie de agent als de medewerker en agentic AI als de manier waarop een bedrijf veel van zulke medewerkers organiseert, samen met de vaste stappen en menselijke checks eromheen.
Is ChatGPT een AI-agent?
Gewoon chatten, waarbij jij vraagt en het antwoordt, is geen agent, omdat jij elke volgende stap bepaalt. Sommige functies van ChatGPT gedragen zich wel als een agent, bijvoorbeeld als je het een onderwerp laat onderzoeken en het zelf kiest welke zoekopdrachten het doet en welke pagina's het leest voordat het met een antwoord komt. De test is voor elk product hetzelfde: kiest het model zelf zijn stappen richting een doel en voert het die uit, of wacht het op jou?
Wat zijn de belangrijkste soorten AI-agents?
Studieboeken delen agents in naar hoe ze beslissen. Dat loopt van simpele reflexagents die alleen op de huidige input reageren, via modelgebaseerde, doelgebaseerde en nutsgebaseerde agents, tot lerende agents die beter worden met ervaring. In sales en marketing is een indeling naar hoe ze draaien praktischer: smalle agents die één afgebakende taak doen, conversationele agents die handelen als je erom vraagt, achtergrondagents die op een trigger afgaan en multi-agentopstellingen die werk tussen rollen doorgeven.
Is een AI SDR hetzelfde als een AI-agent?
Niet helemaal. Een AI SDR is een product of een rolomschrijving, en onder de motorkap zijn het meestal meerdere agents en vaste workflowstappen die samenwerken: de ene onderzoekt accounts, een andere schrijft berichten en weer een andere sorteert reacties. Sommige producten die als AI SDR worden verkocht, bevatten heel weinig echte besluitvorming en zijn vooral sequences op basis van templates waarin een model de tekst schrijft. Vraag de leverancier welke stappen het model echt zelf kiest.
Mag een AI-agent zelfstandig e-mails naar prospects sturen?
In het begin niet, en voor de meeste teams nog lang niet. Een verstuurde e-mail kun je niet terughalen, en fouten op volume schaden zowel je reputatie bij kopers als de gezondheid van je verzenddomeinen. Laat de agent onderzoeken en concepten schrijven, laat een rep elk bericht goedkeuren en houd bij hoe vaak de rep het concept moet aanpassen. Overweeg pas om die check losser te maken als aanpassingen zeldzaam zijn geworden en dat ook blijven.
Wat is het correctiepercentage (override rate) van een AI-agent?
Het is het deel van de output van een agent dat een mens moet aanpassen voordat die het gebruikt, zoals concepten die een rep herschrijft of recordupdates die iemand terugdraait. Het is het nuttigste losse cijfer om te bepalen hoeveel vrijheid een agent mag krijgen. Een hoog percentage in het begin wijst meestal op een taak die te breed is of op data die te dun is. Daalt het percentage en blijft het laag, dan is dat het teken om de taak te verbreden.
Moet je kunnen programmeren om een AI-agent te bouwen?
Nee, voor de meeste GTM-taken niet. In Clay draai je een onderzoeksagent als kolom in een tabel, en n8n heeft een AI Agent-node die je visueel instelt met een model, geheugen en tools. Code wordt nuttig als je eigen tools nodig hebt, meer controle over de lus wilt of de agent in je eigen product wilt inbouwen. Daar komen developerframeworks zoals de Agents SDK van OpenAI in beeld.
Wat kost het om een AI-agent te draaien?
Dat verschilt per run, en dat is het grootste verschil met een vaste workflowstap. Een agent bepaalt zelf hoeveel zoekopdrachten, gelezen pagina's en modelaanroepen hij nodig heeft, dus een eenvoudig account kan een fractie kosten van een lastig account. Clay rekent voor zijn onderzoeksagent bijvoorbeeld één tot drie credits per rij, afhankelijk van het model dat je kiest. Stel per taak een limiet in op pogingen en toolaanroepen, zodat een verwarrend record geen onbegrensde rekening kan opleveren.
Wat is agent washing?
Agent washing is de term van Gartner voor leveranciers die bestaande producten, zoals chatbots, AI-assistenten en robotic process automation, opnieuw verpakken als AI-agent zonder echte agentic mogelijkheden toe te voegen. Gartner schat dat maar zo'n 130 van de duizenden leveranciers die agentic AI verkopen echt zijn. Wil je een product checken, vraag dan of het model zelf zijn volgende stap bepaalt en tools kan gebruiken om te handelen, of dat het een vast script volgt.
Onthoudt een AI-agent dingen tussen taken door?
Alleen als je dat inbouwt. Binnen één run houdt een agent een werkgeheugen bij van wat hij al heeft gevonden, zodat hij geen zoekopdrachten herhaalt en zichzelf niet tegenspreekt. Iets onthouden over runs heen, zoals wat hij vorige maand over een account leerde, vraagt om een aparte opslag waar de agent uit kan lezen en naar kan schrijven, zoals een CRM-veld of een database. Zonder die opslag begint elke taak bij nul.
Deel dit bericht
AI
Automation
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen
Klaar om je pipeline te bouwen