In this post:
Workflow orchestration is de laag die meerdere geautomatiseerde workflows en tools coördineert, zodat ze zich gedragen als één systeem. Die laag bepaalt wat elke workflow in gang zet, in welke volgorde dingen gebeuren, welke tool welke data doorgeeft aan de volgende en wat er gebeurt als een stap faalt. Eén automatisering doet één klus. Orchestration regelt de estafette tussen de klussen.
De term wordt in twee werelden gebruikt. Data engineers bedoelen ermee het inplannen van datapipelines in tools als Apache Airflow. In sales- en marketingoperations betekent het dat je CRM, je enrichment-tool, je sequencer, je agenda en je alerts in de pas laat lopen, meestal met HubSpot-workflows, n8n, Make, Zapier en Clay die het zware werk doen. Deze pagina gaat over die tweede betekenis.
De meeste revenue-teams komen geen automatisering tekort. Ze hebben er genoeg van, gebouwd door verschillende mensen op verschillende momenten, en elk stuk werkt prima als je het los test. Wat breekt, is de ruimte tussen de stukken: een lead die pas wordt verrijkt als zijn sequence al loopt, twee tools die hetzelfde veld overschrijven, een webhook die op dinsdag faalde zonder dat iemand het hoorde. Bij orchestration ontwerp je die ruimte bewust, in plaats van hem maar te laten ontstaan.
TL;DR
In data engineering betekent orchestration het inplannen van pipelines (Airflow draait workflows die in Python zijn geschreven als grafen van afhankelijke stappen). In GTM betekent het event-gedreven flows coördineren in het CRM en de tools eromheen. De ideeën overlappen, de taken niet.
Denk in drie lagen. Een taak draait vanzelf, een workflow rijgt taken aan elkaar voor één klus, en orchestration bepaalt welke workflows draaien, in welke volgorde en met welke data. Gaat je vraag over hoe twee workflows op elkaar inwerken, dan is het een orchestration-vraag.
De orchestration-laag is eigenaar van vijf dingen: de trigger en de volgorde van events, de overdrachten tussen tools, welk systeem naar welk veld mag schrijven, wat er gebeurt als een stap faalt, en een log van wat er draaide.
Eén demo-aanvraag raakt in de eerste tien minuten vijf of zes tools. De meeste storingen komen door timing en dubbele records, zoals een sequence die start voordat de enrichment klaar is, en zelden doordat één tool slecht is.
Geef elke flow één dirigent. HubSpot-workflows passen bij flows die vooral in het CRM leven, n8n of Make bij flows die door veel systemen lopen, en Clay werkt het best als de datastap binnen de flow, zonder zelf de volgorde te bepalen.
AI-agents kunnen inmiddels een deel van de routingbeslissingen nemen, maar de orchestration eromheen hoort vast te blijven, met een mens die alles goedkeurt wat een koper leest.
Bouw het op met één lekkende overdracht tegelijk, geef elke flow een vaste eigenaar en een alert bij fouten, en check alles opnieuw zodra er een tool in de keten verandert.
Airflow-pipelines of revenue-flows: de twee betekenissen van workflow orchestration
Zoek je op de term, dan gaat de helft van de resultaten over data engineering. Daar plant en bewaakt een workflow-orchestrator batchjobs. De documentatie van Apache Airflow omschrijft Airflow als een open-sourceplatform om workflows te ontwikkelen, in te plannen en te monitoren, en elke workflow wordt in Python vastgelegd als een DAG: een set stappen met afhankelijkheden en zonder lussen. Een nachtelijke job die productgebruik naar een datawarehouse haalt, het opschoont en de gezondheid van accounts opnieuw berekent, is orchestration in die betekenis.
De GTM-versie leent de kernideeën (afhankelijkheden, volgorde, retries, monitoring), alleen werkt ze met ander materiaal. De eenheden zijn een ingevuld formulier, een CRM-record of een geboekte meeting. Flows starten op events in plaats van op een schema, ze worden meestal in no-codetools gebouwd, en de mensen die ze onderhouden, zitten bij RevOps in plaats van in een datateam.
De twee komen elkaar vaker tegen dan je zou denken. Wordt gebruiksdata uit het warehouse naar HubSpot of Salesforce gepusht om een sales-alert af te laten gaan, dan draagt een datapipeline het stokje over aan een revenue-flow. Iemand moet dan afspreken wanneer die sync draait en welke kant eigenaar is van de velden waar hij naar schrijft.
Automatisering, workflow, orchestration: aan welke laag bouw je?
De drie woorden worden door elkaar gebruikt, en zo kopen teams een vierde automatiseringstool om een coördinatieprobleem op te lossen. Ze beschrijven verschillende lagen.
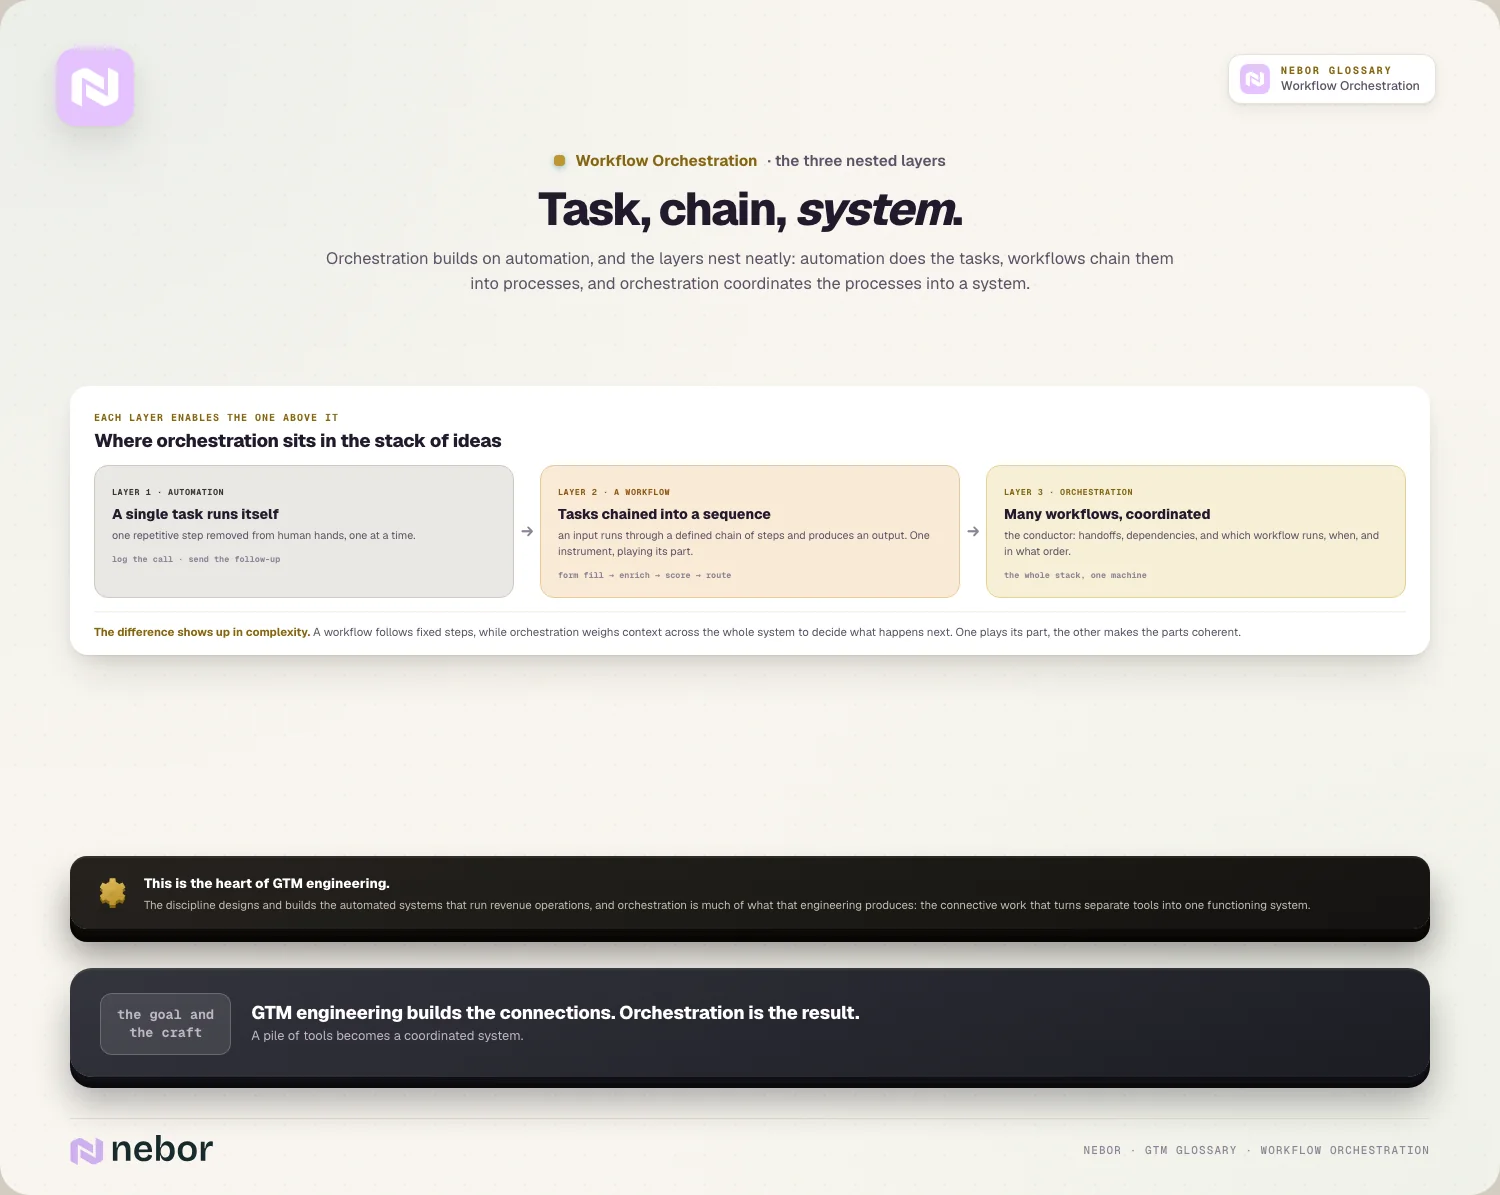
Onderaan zit sales automation van losse taken: een taak aanmaken als een deal van fase verandert, een call loggen, een follow-up sturen. Eén trigger, één actie.
In het midden zitten workflows, die taken aan elkaar rijgen tot een proces met één doel, zoals elk nieuw contact verrijken of reacties sorteren. Doet een taalmodel een deel van de stappen, dan is het een AI-workflow. Kiezen sommige stappen zelf hun volgende zet, dan is het een agentic workflow. Op die twee pagina's lees je hoe je ze goed bouwt.
Bovenaan zit orchestration. Stel je vier workflows voor die elk op zichzelf prima werken: een die verrijkt, een die scoort, een die routeert en een die het contact in een sequence zet. Orchestration is de beslissing dat routing wacht op de score, dat de score wacht op de enrichment en dat een geboekte meeting het contact uit de sequence haalt. Geen van die regels hoort bij één workflow, en precies daarom ontbreken ze zo vaak.
Die bovenste laag ontwerpen is een groot deel van wat GTM engineering oplevert. Het is ook het verschil tussen een GTM-stack en een verzameling logins.
Wat de laag voor workflow orchestration moet regelen
Haal de toolnamen weg en er blijft een korte lijst taken over voor een orchestration-laag. Als we een rommelige stack doorlichten, checken we ze een voor een, en meestal blijken er twee of drie helemaal geen eigenaar te hebben.
Triggers en volgorde. Wat de flow start (een formulier, een signaal, een schema), en wat klaar moet zijn voordat de volgende stap mag beginnen.
Overdrachten. Welke data van tool A naar tool B gaat, in welk formaat, en welke ID de records aan elkaar koppelt, zodat er niets dubbel wordt aangemaakt.
Eigenaarschap van velden. Voor elk belangrijk veld (lifecycle stage, eigenaar, score) mag één systeem schrijven. Schrijven twee tools naar hetzelfde veld, dan overschrijven ze elkaar en kan niemand zeggen welke waarde klopt.
Fouten afhandelen. Wat er gebeurt als een API een time-out of een foutmelding geeft. De tools geven je de onderdelen. In n8n koppel je een error workflow die draait zodra een uitvoering mislukt, bijvoorbeeld om een bericht in Slack te zetten. De instelling autoreplay van Zapier speelt elke run van een zap die op een fout eindigt opnieuw af, en HubSpot probeert een mislukte webhook tot drie dagen lang opnieuw. Toch moet iemand nog beslissen welke fouten opnieuw worden geprobeerd, welke een mens alarmeren en welke de flow stoppen.
Een log van wat er draaide. Een log die de vraag "waarom heeft dit contact die eigenaar?" in een minuut beantwoordt, in plaats van in een middag.
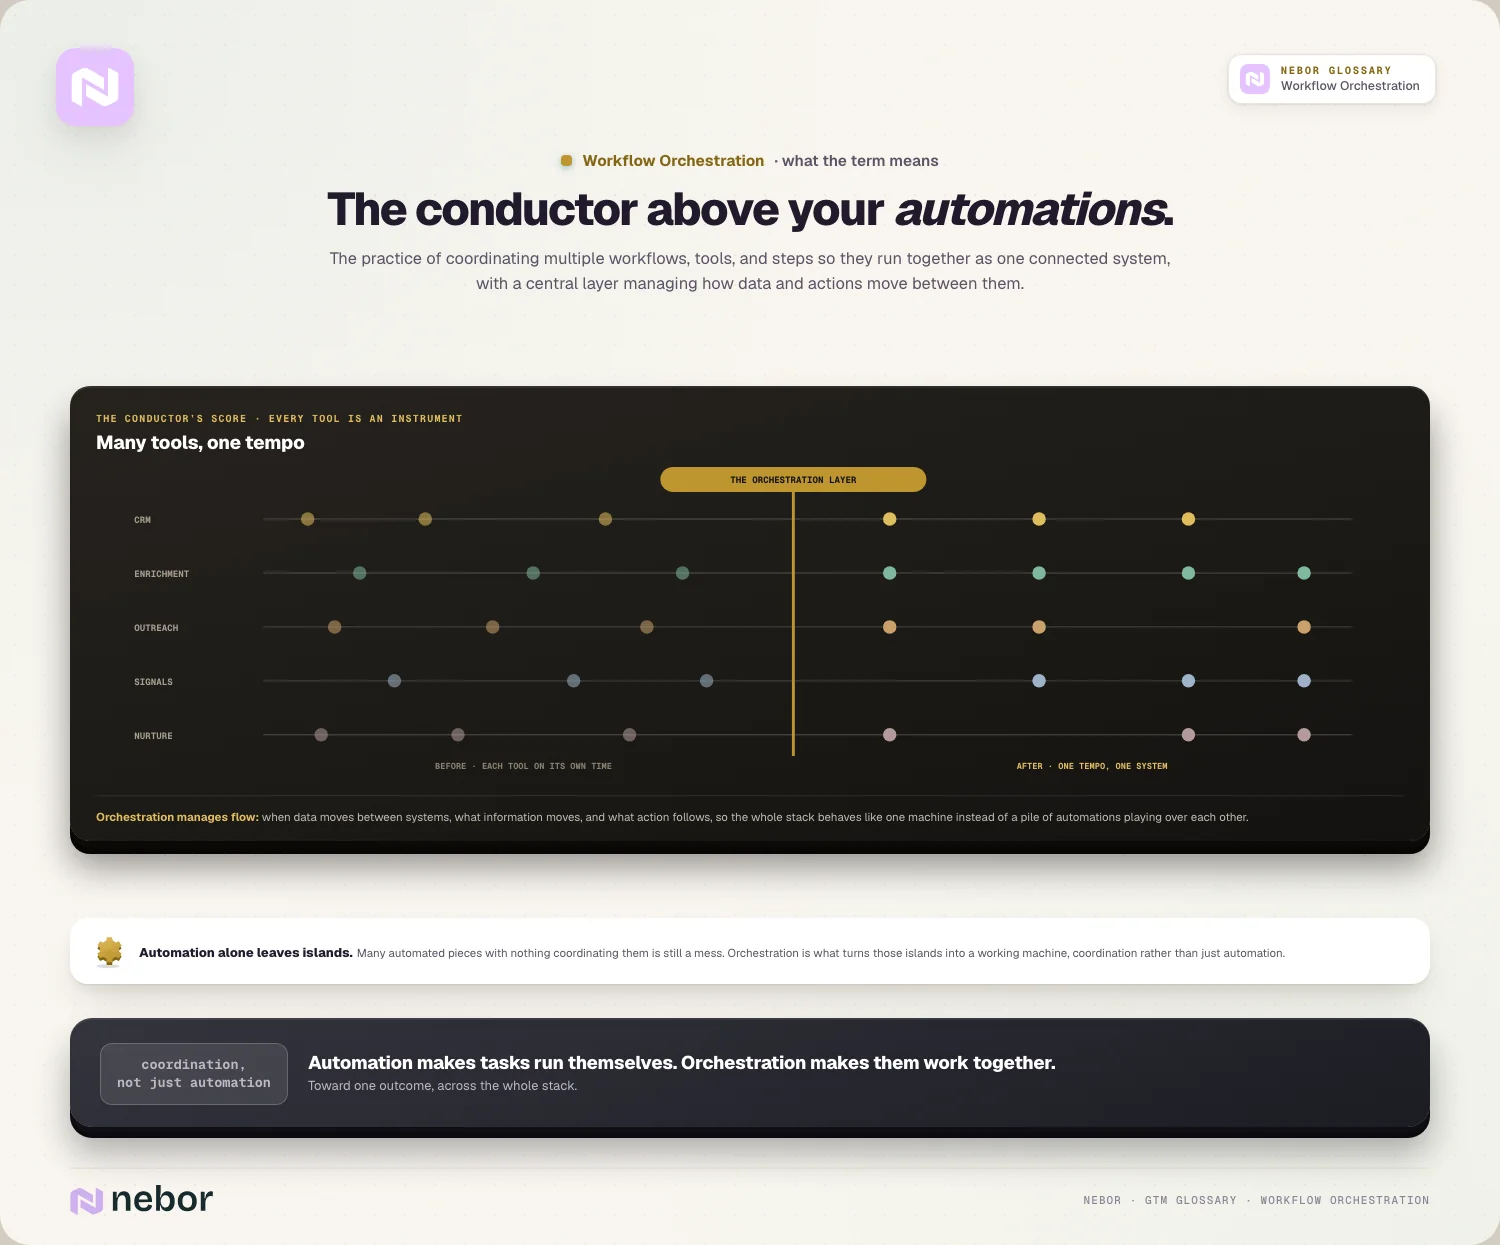
Alleen het eerste punt gaat over dingen laten gebeuren. De andere vier gaan erover dat ze goed en zichtbaar gebeuren, en daar zit het meeste werk.
Een demo-aanvraag raakt zes tools. Wie bepaalt de volgorde?
Dit is een flow die we vaak bouwen, voor een B2B-softwarebedrijf met HubSpot, Clay, een sequencer en Slack. De tijden zijn wat een goed gebouwde versie haalt.
00:00. Een bezoeker vult het demoformulier in. HubSpot maakt het contact aan of werkt het bij en stuurt een webhook.
00:05. n8n ontvangt de webhook en vraagt Clay om de persoon en het bedrijf te verrijken (omvang, branche, land, functietitel).
00:40. Zodra de enrichment terug is, krijgt het record een fitscore en wordt het gekoppeld aan een bedrijfsrecord dat al bestaat, als dat er is.
00:45. Lead routing kiest een eigenaar. Is er al een accounteigenaar, dan wint die, en anders de territory-regel.
00:50. De eigenaar krijgt een alert in Slack met de verrijkte context, en de prospect ziet een boekingslink op de bedankpagina.
Is er binnen het uur geen meeting geboekt, dan gaat het contact een korte sequence in. Boekt hij op enig moment, dan stopt de sequence en begint de voorbereiding van de meeting.
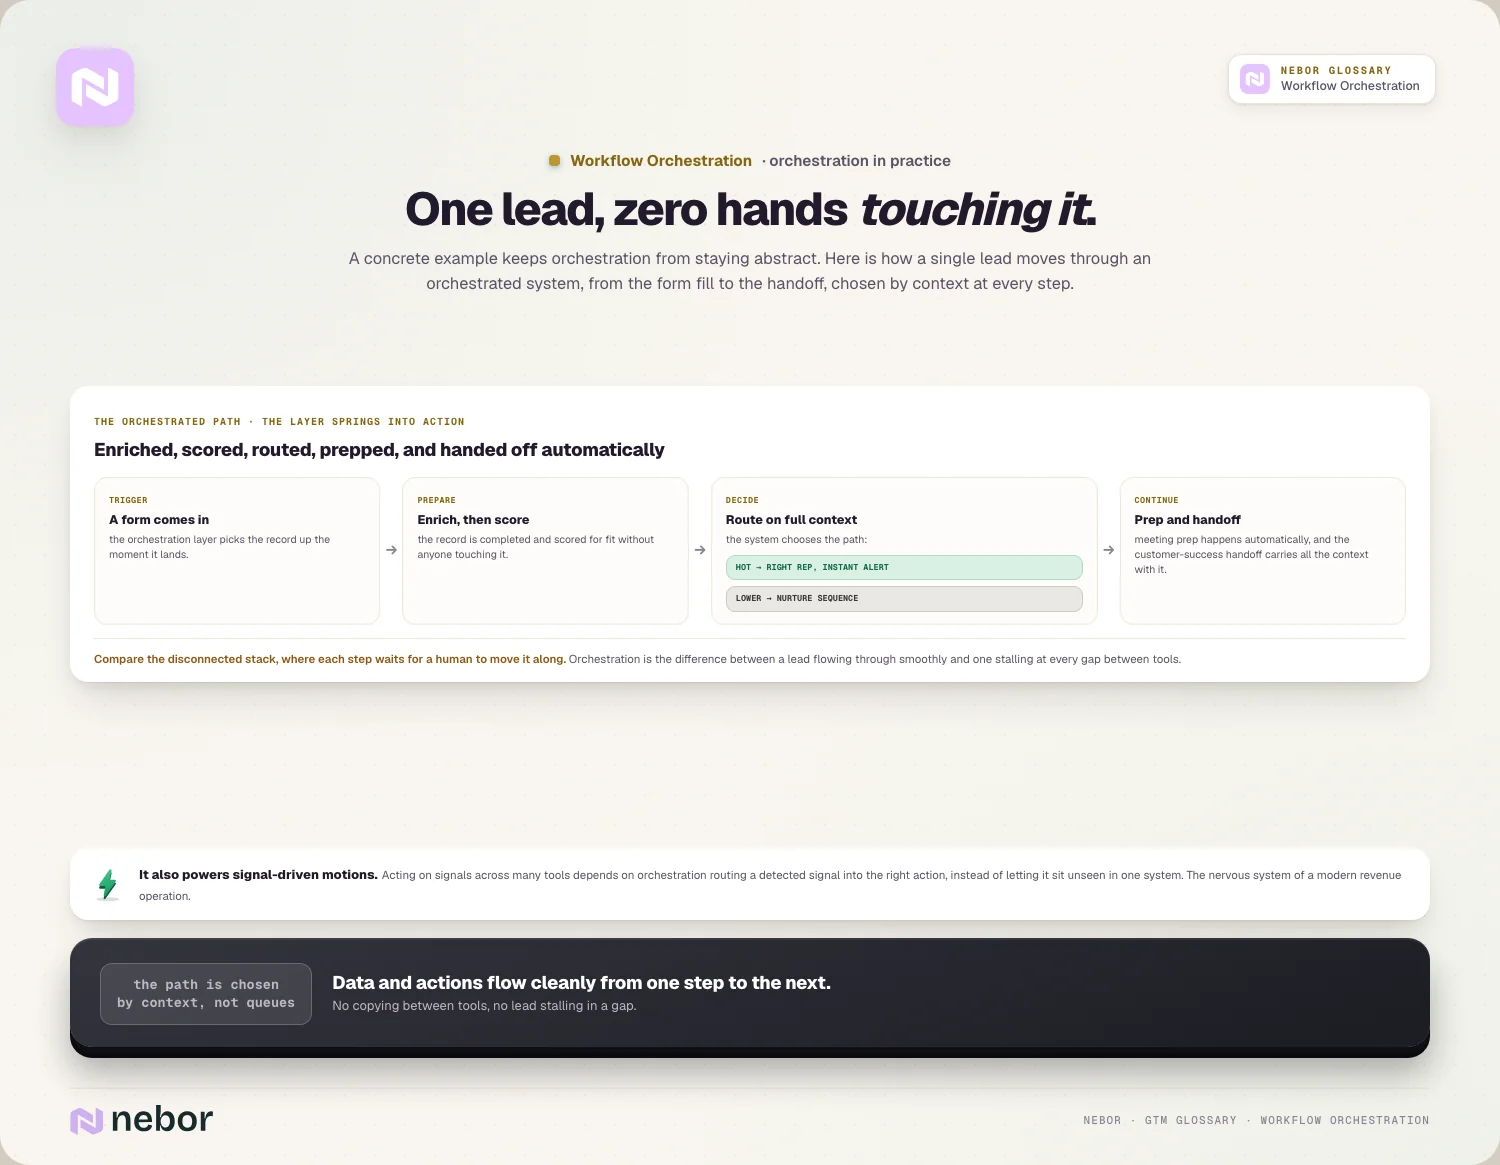
Elke tool in die lijst doet zijn eigen werk goed. De problemen zitten in de gaten ertussen. Gaat routing af voordat de data enrichment terug is, dan heeft de territory-regel geen land om te lezen en belandt de lead bij de verkeerde rep. Maken HubSpot en de sequencer allebei het contact aan, dan krijg je een dubbel record en twee reeksen e-mails. Werkt de sequencer de lifecycle stage bij en reageert een HubSpot-workflow daarop door de sequencer bij te werken, dan kunnen de twee in een lus belanden.
Geen van deze problemen is een bug in een tool. Het zijn beslissingen over de volgorde die niemand heeft genomen. De flow hierboven beschermt je speed to lead alleen omdat één plek op de enrichment wacht, één ID voor het contact vasthoudt en weet dat een geboekte meeting boven alles gaat. Een volledige versie beschrijven we in onze workflow voor inbound meetings.
Waar hoort de orchestration-logica te zitten?
Revenue-stacks blijven groeien, en de meeste nieuwe tools komen met een eigen automatiseringsbouwer. Zo raakt de logica verspreid: een regel in HubSpot, een zap die iemand in 2023 maakte, een Clay-tabel met een webhookkolom, een script op een laptop. Elk stuk werkt, niemand overziet het geheel, en wie het ene aanpast, breekt het andere.
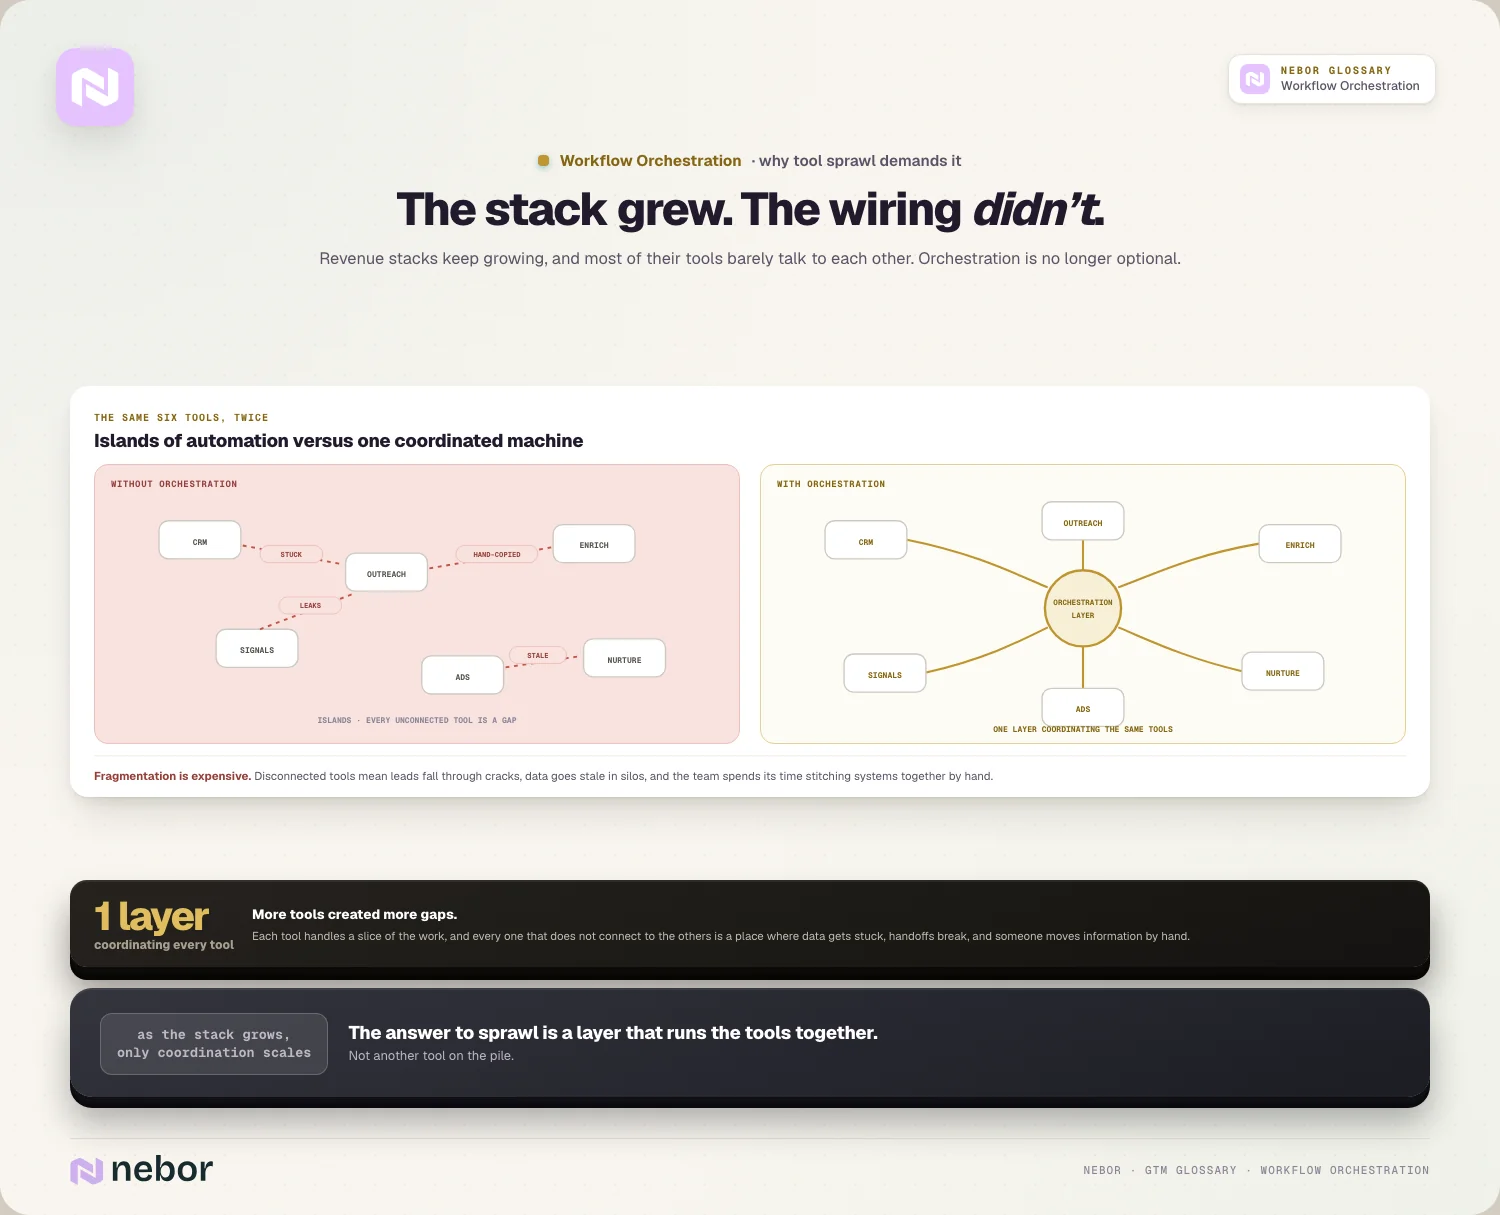
Onze regel is één dirigent per flow. De andere tools mogen best veel kunnen, maar voor een bepaalde flow is één plek eigenaar van de volgorde van events en van de foutafhandeling. Welke plek dat is, hangt af van waar de flow leeft.
Vooral binnen het CRM. Gaat de flow over records, eigenaren en fases, dan kunnen workflows in HubSpot of Salesforce Flow de dirigent zijn, zodat de logica naast de data staat. Voor de webhookactie van HubSpot, waarmee een workflow tools buiten HubSpot aanroept, heb je Data Hub Professional of Enterprise nodig.
Door veel systemen heen. Roept een flow meerdere API's aan, vertakt hij veel en heeft hij echte foutroutes nodig, dan zijn n8n of Make meestal de betere dirigent. Zapier is snel voor eenvoudigere flows die vooral lineair lopen.
Clay als station onderweg. Clay is uitstekend in enrichment, onderzoek en het scoren van rijen. Wij zetten het in als een stap die de dirigent aanroept. Wat er daarna in de rest van de stack gebeurt, laten we Clay niet bepalen.
De afwegingen tussen tools voor losse workflows staan op de pagina over AI-workflows. Voor orchestration is de vraag smaller: kan iemand die nieuw is één plek openen en de volgorde van events voor deze flow zien? Zo niet, dan zit de logica op te veel plekken.
Een AI-agent een deel van de beslissingen laten nemen
Klassieke orchestration volgt regels die je vooraf hebt geschreven. Dat werkt tot er een geval binnenkomt dat de regels niet hadden voorzien, zoals een lead van een bedrijf dat net is gefuseerd met een bestaande klant. Dan stuurt de flow de lead naar een rare plek.
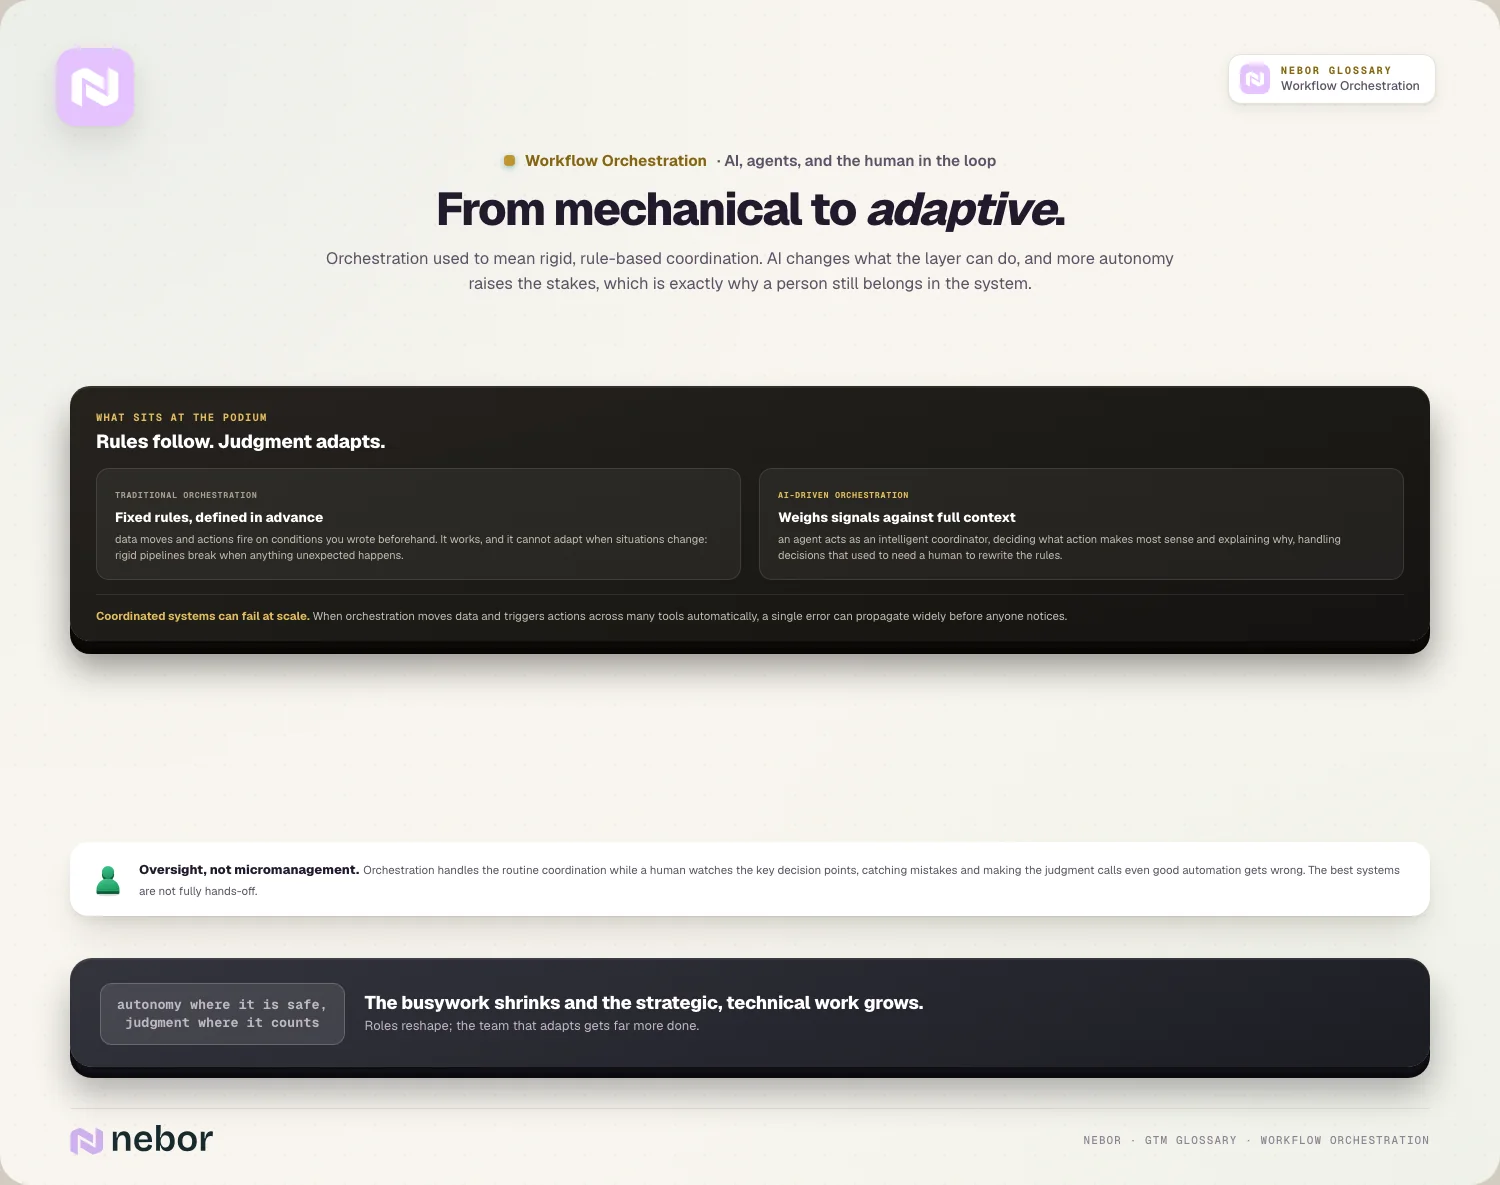
Een AI-agent kan een deel van die beslissingen binnen de flow nemen: de context lezen, inschatten of een bezoek op een koper of op een student lijkt, en kiezen welk onderzoek er moet draaien. Op een paar punten is dat nuttig. Een reden om de hele flow aan een agent te geven, is het niet. De triggers, de ID's, het eigenaarschap van velden en de foutafhandeling horen vast te blijven, omdat ze zich bij elke run hetzelfde moeten gedragen.
Geautomatiseerde fouten reizen ook verder. Schrijft één flow naar vijf systemen, dan landt een verkeerde beslissing op vijf plekken voordat iemand kijkt. Daarom zetten we een human in the loop op elke plek waar een actie bij een koper terechtkomt of lastig terug te draaien is, en laten we de routinematige coördinatie zonder mens draaien. Dezelfde redenering geldt als buying signals de flow starten in plaats van ingevulde formulieren. Dat is het terrein van signal orchestration.
Bouw het op, één lekkende overdracht tegelijk
Orchestration klinkt als een groot project, en teams die het zo aanpakken, blijven vaak hangen in de ontwerpfase. Wij beginnen kleiner.
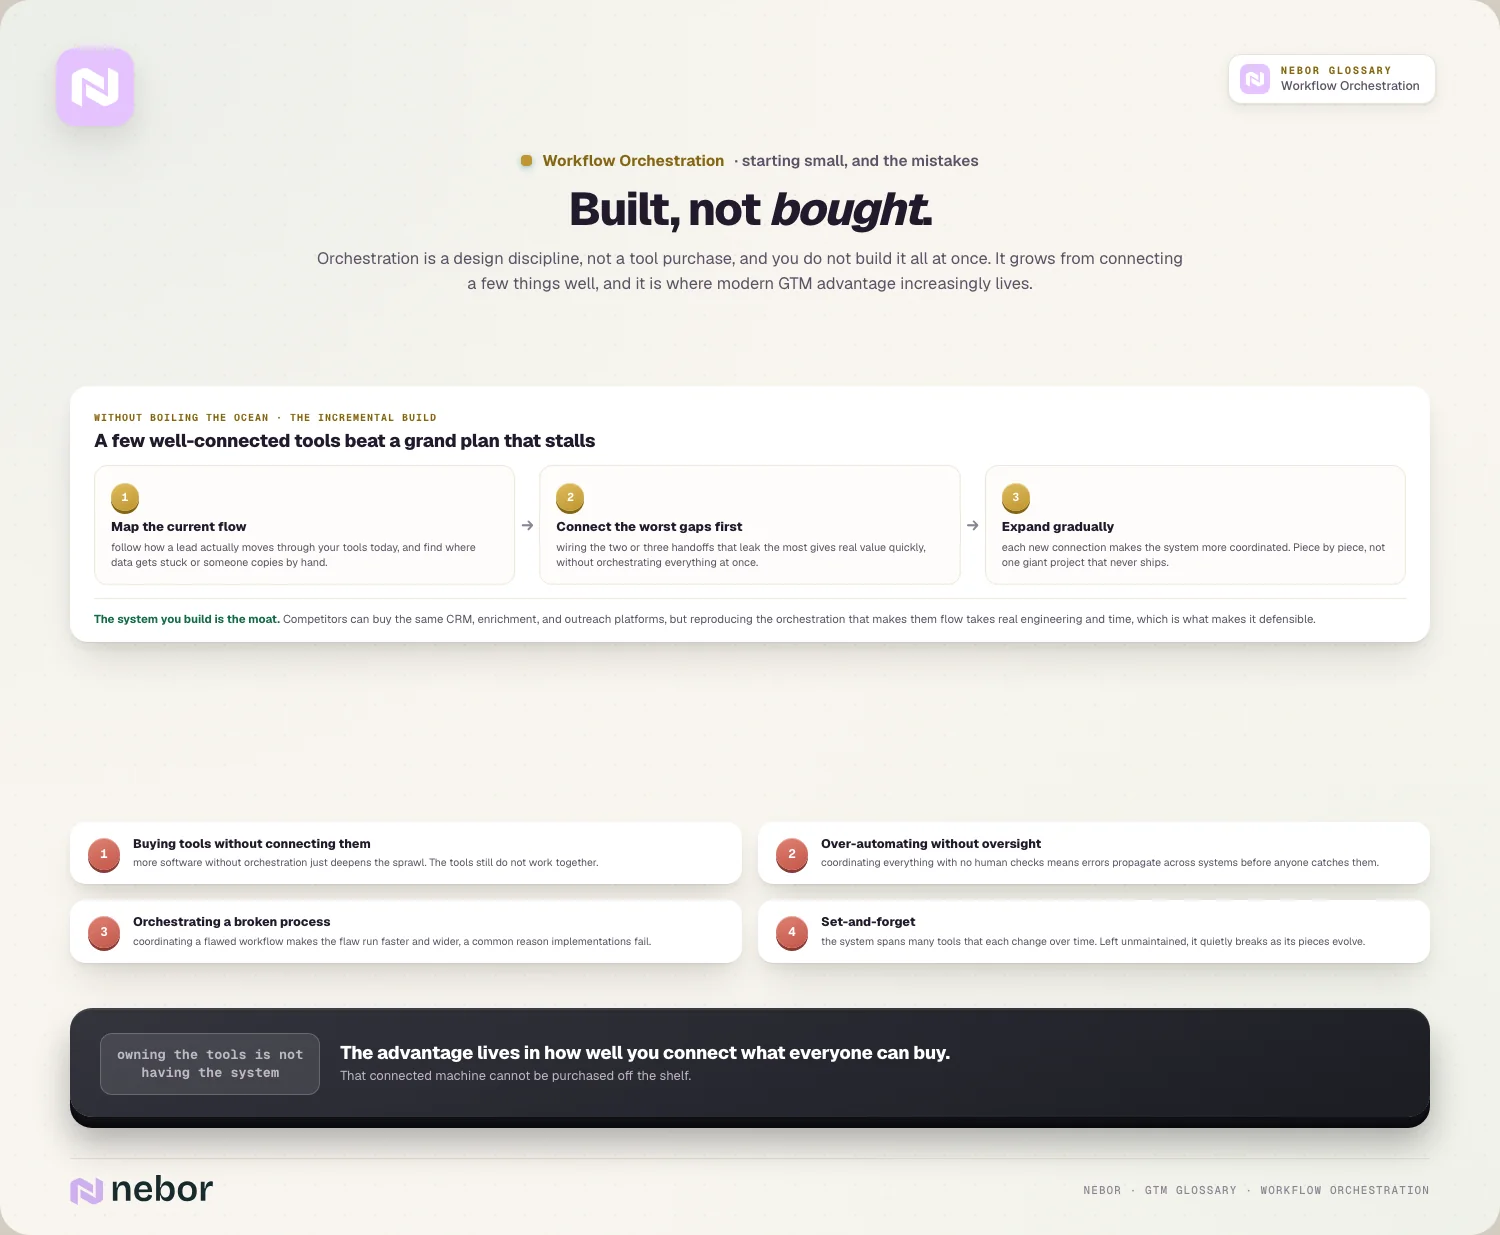
Breng eerst in kaart hoe een lead nu echt beweegt, van het eerste contact tot de gesloten deal, en markeer elk punt waar iemand data met de hand kopieert of waar records blijven wachten. Repareer daarna de twee of drie overdrachten die het meest lekken. Meestal zijn dat de reactie op inbound, de stap van meeting naar opportunity en de overdracht van closed-won naar customer success. Elke reparatie krijgt een vaste eigenaar, een alert bij fouten en een korte, uitgeschreven beschrijving van wat wat in gang zet. Pas daarna ga je door naar het volgende gat.
Twee waarschuwingen uit projecten die we hebben overgenomen. Wie een kapot proces orkestreert, laat het sneller breken, en dat zit achter veel Clay-implementaties die mislukken: de bedrading was prima, de targeting eronder niet. En orchestration veroudert. Leveranciers veranderen hun API's, iemand hernoemt een property, er gaat een nieuw formulier live, en een flow die een jaar lang soepel draaide, begint records te verliezen. Check elke flow opnieuw zodra er een tool in verandert, en houd je CRM-hygiëne in de gaten, want dubbele records en lege velden zijn meestal het eerste teken dat een overdracht is gaan schuiven.
Zo opgebouwd tellen de verbonden flows stuk voor stuk op tot een revenue engine. Het is dezelfde aanpak die we gebruiken om sales prospecting te automatiseren: eerst de volgorde en de overdrachten, daarna pas de stappen.
Kort gezegd
Automatisering was nooit het moeilijke deel. De meeste stacks zitten er vol mee. Het moeilijke deel is bepalen hoe die automatiseringen zich tot elkaar verhouden: wat op wat wacht, welk systeem eigenaar is van welk veld en wie het hoort als er iets misgaat.
Dat is workflow orchestration, en je kunt het niet kant-en-klaar kopen. Elke leverancier verkoopt een stukje, en de coördinatie tussen de stukjes moet je ontwerpen voor jouw proces, jouw data en jouw team. Een concurrent kan morgen dezelfde tools afnemen. Nabouwen hoe ze bij jou in elkaar grijpen, kost hem veel meer tijd.
Het goede nieuws: je hebt er geen groot project voor nodig. Eén goed geordende flow, met een eigenaar en een alert, is al meer waard dan een dozijn slimme automatiseringen die niemand kan overzien. Voeg de volgende toe als de eerste stabiel draait, en de stack gaat zich gedragen als het go-to-market-systeem dat het altijd had moeten zijn.
Wil je hulp bij die van jou? Wij brengen de flows in kaart, bouwen de orchestration in de HubSpot-, n8n- of Clay-omgeving die je al hebt, en laten een uitgeschreven overzicht van elke trigger en overdracht achter. Zo kunnen de mensen die er dagelijks mee werken het met vertrouwen aanpassen.
Veelgestelde vragen
Wat is het verschil tussen workflow orchestration en workflowautomatisering?
Workflowautomatisering laat één proces draaien zonder handwerk, zoals elk nieuw contact verrijken of een follow-up sturen als een deal van fase verandert. Workflow orchestration coördineert meerdere van die geautomatiseerde processen. Het bepaalt wat elk proces start, in welke volgorde ze draaien, welke data ertussen doorgaat en wat er gebeurt als er een faalt. Je kunt veel automatisering hebben en toch geen orchestration, en zo beginnen de meeste rommelige stacks.
Wordt Apache Airflow gebruikt voor orchestration in sales en marketing?
Zelden, en meestal alleen indirect. Airflow plant en bewaakt datapipelines die in Python zijn geschreven, dus datateams gebruiken het om volgens een schema productgebruik of factuurdata in een warehouse te laden. Revenue-flows reageren op events zoals ingevulde formulieren en reacties, en RevOps-teams bouwen ze in HubSpot-workflows, n8n, Make of Zapier. De twee raken elkaar als data uit het warehouse naar het CRM wordt gesynct en daar een sales-alert start.
Kunnen HubSpot-workflows orchestration aan zonder extra tool?
Voor flows die vooral binnen HubSpot leven, vaak wel. Workflows kunnen eigenaren toewijzen, properties bijwerken, taken aanmaken en vertakken op voorwaarden, en daarmee dek je veel logica voor routing en lifecycle. Voor het aanroepen van externe tools heb je de webhookactie nodig, die bij Data Hub Professional of Enterprise hoort. Loopt een flow door meerdere externe systemen, met vertakkingen en foutroutes, dan is een externe dirigent zoals n8n of Make meestal makkelijker te bouwen en te debuggen.
Is n8n of Zapier beter als orchestration-laag?
Dat hangt af van de vorm van je flows. Zapier zet je snel op voor simpele flows die vooral lineair lopen, en het heeft een enorme bibliotheek met app-koppelingen. n8n kan beter overweg met veel vertakkingen, eigen code en aparte error workflows, en je kunt het zelf hosten, wat sommige teams willen voor de controle over hun data. Voor een stack met veel flows tussen systemen kiezen wij meestal n8n of Make, met Zapier voor kleine losse klussen.
Wat is een error workflow?
Een error workflow is een aparte flow die draait als een andere flow faalt, zodat een kapotte stap altijd opvalt. In n8n bouw je er een die begint met de Error Trigger-node, en die koppel je in de instellingen aan andere workflows, meestal om de fout in Slack te melden of de eigenaar te mailen. Het is een van de eenvoudigste stukken orchestration om toe te voegen, en een van de stukken die het vaakst worden overgeslagen.
Wat is het verschil tussen workflow orchestration en signal orchestration?
Workflow orchestration is het algemene werk van geautomatiseerde flows in je tools coördineren, wat ze ook start. Signal orchestration is een smaller geval. Daar is het startpunt een buying signal, zoals een functiewissel, een financieringsronde of een reeks websitebezoeken, en draait het werk om bepalen welke signalen ertoe doen en welke actie elk signaal in gang moet zetten. Signal orchestration draait op hetzelfde leidingwerk.
Vervangt workflow orchestration de mensen in RevOps of sales ops?
Nee, het verandert waar ze hun dagen aan besteden. Het kopiëren, toewijzen en najagen tussen tools verdwijnt, alleen moet iemand nog steeds de flows ontwerpen, de regels bepalen, de foutmeldingen in de gaten houden en dingen aanpassen als het salesteam of de tools veranderen. In de praktijk verschuift orchestration het werk van RevOps van handmatige administratie naar systemen bouwen en onderhouden, en verlost het reps van data-invoer.
Waarom is een goed georkestreerde stack moeilijk te kopiëren voor concurrenten?
Omdat iedereen de tools kan kopen, terwijl de manier waarop jij ze hebt verbonden van jou blijft. Een concurrent koopt in een middag hetzelfde CRM, dezelfde enrichment-provider en dezelfde sequencer. De volgorde, het eigenaarschap van velden, de routinglogica en de foutafhandeling nabouwen die jouw stack als één systeem laten werken, kost maanden ontwerpen en testen op de eigen data, en de meeste teams maken dat nooit af.
Hoe documenteer je een georkestreerde GTM-stack?
Houd per flow één korte pagina bij met wat hem start, de stappen op volgorde, welke tool elke stap draait, naar welke velden elke tool mag schrijven, wat er bij een fout gebeurt en wie de eigenaar is. Voeg een eenvoudig schema toe en een lijst van de ID's die records tussen tools aan elkaar koppelen. Werk de pagina bij zodra de flow verandert, want documentatie die afwijkt van de build is erger dan geen documentatie.
Deel dit bericht
Workflows
Automation
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen

Klaar om je pipeline te bouwen