In this post:
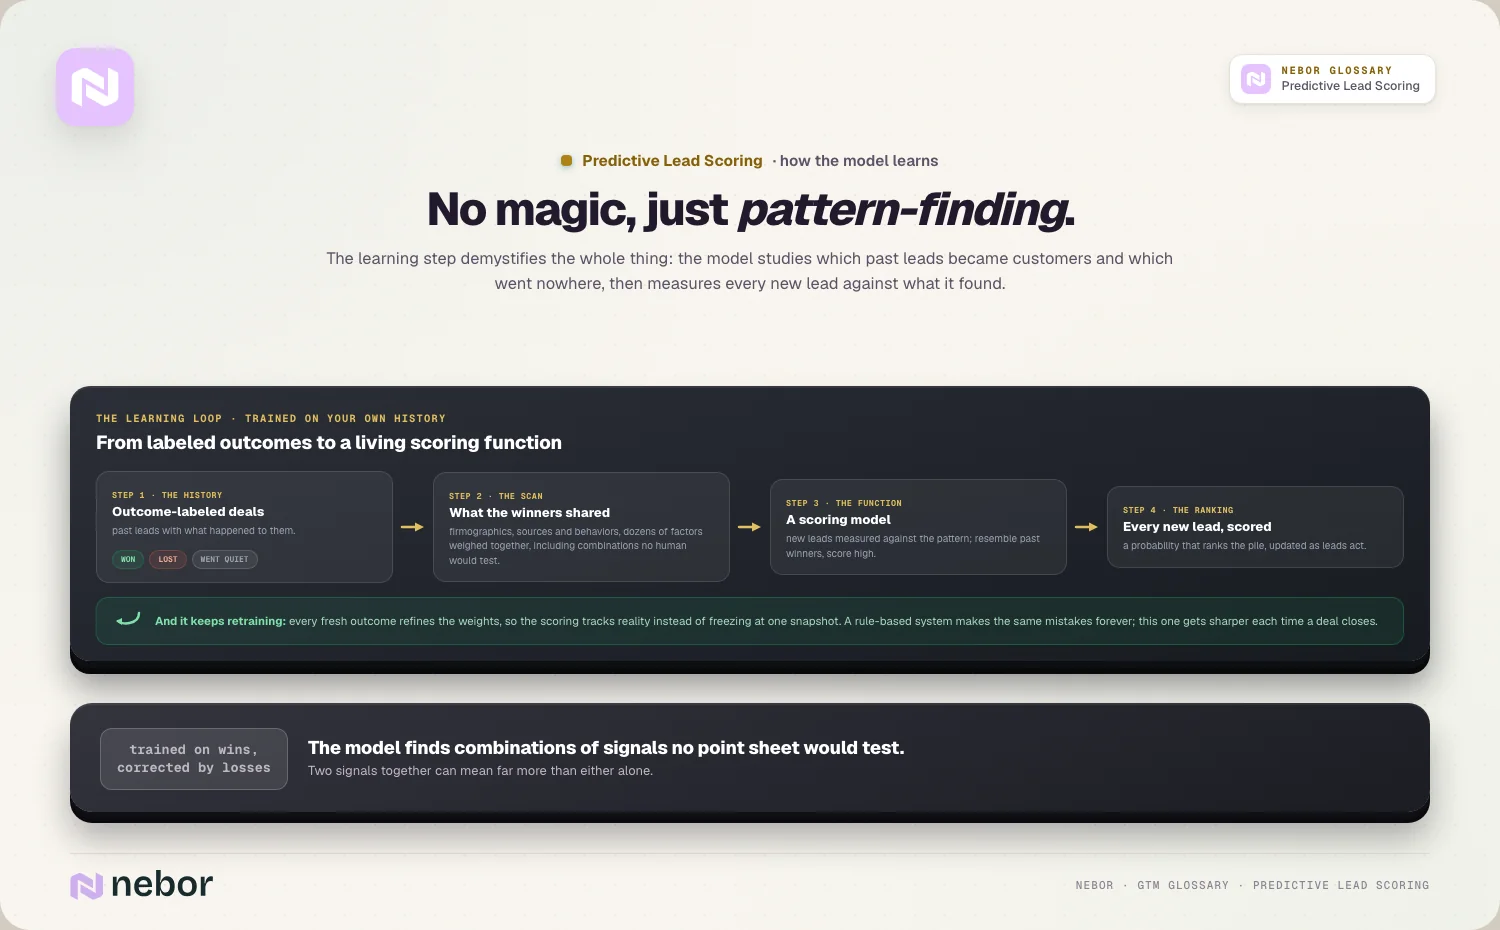
Predictive lead scoring rangschikt leads op hun kans om te converteren, met een machine learning-model dat is getraind op je eigen historie van leads die wel en geen klant werden. Niemand tikt puntenwaarden in. Het model zoekt zelf uit welke kenmerken en welk gedrag eerdere wins van eerdere losses onderscheidden, en scoort elke nieuwe lead tegen dat patroon.
Dat klinkt aantrekkelijk, en terecht. Een lead-scoringmodel dat je met de hand bouwt, is een lijst overtuigingen over wie er koopt, en die overtuigingen kunnen jarenlang ongetoetst blijven. Een model dat op uitkomsten is getraind, toetst ze elke keer dat het opnieuw traint.
Het addertje: het model gelooft alles wat je CRM heeft vastgelegd. Zijn conversies inconsistent gelogd, wordt een veld pas ingevuld nadat een lead is gewonnen, of is je markt verschoven sinds het trainingsvenster, dan komen de scores er precies en fout uit. De meeste predictive opzetten die we mogen bekijken, gingen mis in de historie waarvan ze leerden. Aan de wiskunde lag het zelden.
TL;DR
Het model leert van een label dat jij definieert (wat telt als geconverteerd, en binnen welk venster) en van leadrecords zoals ze eruitzagen vóór de uitkomst. Einstein voorspelt leadconversie, HubSpot voorspelt of iemand binnen 90 dagen klant wordt, dus dezelfde lead kan in de twee tools heel anders scoren.
Einstein heeft voor elk segment dat je definieert een minimale historie nodig en valt tot die tijd terug op een globaal model. De versie van HubSpot zit in de Enterprise-abonnementen en laat niet zien hoe hij inputs weegt.
Leakage is de klassieke manier om nauwkeurigheid te faken. Elk veld dat pas na de uitkomst wordt ingevuld, zoals een reden van diskwalificatie of een leadstatus, laat het model het antwoord aflezen. Sluit die velden uit, of scoor vanuit een snapshot van het moment waarop de lead binnenkwam.
Te weinig historie? Begin met regels, train op een label dat vaker voorkomt (opportunity aangemaakt in plaats van closed won), of scoor fit op basis van lookalikes van je closed-won-klanten terwijl de data groeit.
Inputs gaan schuiven als je een nieuwe markt opgaat, een kanaal toevoegt, een formulier inkort of van enrichmentprovider wisselt. Opnieuw trainen past de gewichten aan (Einstein analyseert ongeveer elke 10 dagen opnieuw), maar alleen conversie per scoreband volgen vertelt je of de scores nog iets betekenen.
Kies een score die zijn redenen laat zien. Reps handelen op getallen waar ze tegenin kunnen gaan, en een lijst met de belangrijkste factoren is de snelste manier om leakage te ontdekken.
Backtest op de leads van vorig kwartaal en laat de nieuwe score een paar weken naast je huidige score meedraaien voordat hij de routing aanstuurt.
Waarop een model voor predictive lead scoring wordt getraind
Een predictive model heeft twee dingen nodig: voorbeelden en een definitie van succes. De voorbeelden zijn eerdere leads, met elk veld en elke activiteit die je over ze hebt vastgelegd. De definitie, door data scientists het label genoemd, zegt welke van die leads als win tellen.
Het label kiezen is de eerste echte beslissing, en teams laten die vaak aan de tool over. "Geconverteerd" kan betekenen dat de lead is omgezet naar een contact, dat er een opportunity is aangemaakt of dat een deal closed won is gegaan. Elke keuze levert een ander model op. Leg je het label bij het aanmaken van een opportunity, dan leert het model wat een meeting oplevert. Een closed-won-label leert het wat een handtekening oplevert, met veel minder voorbeelden om van te leren.
Het tijdvenster telt net zo zwaar. Een lead die vorige week binnenkwam en nog niet is geconverteerd, is nog geen verlies. Tel je hem toch zo, dan leert het model dat recente leads slecht zijn. Train dus alleen op leads die oud genoeg zijn om een eerlijke kans te hebben gehad, meestal minstens één salescyclus.
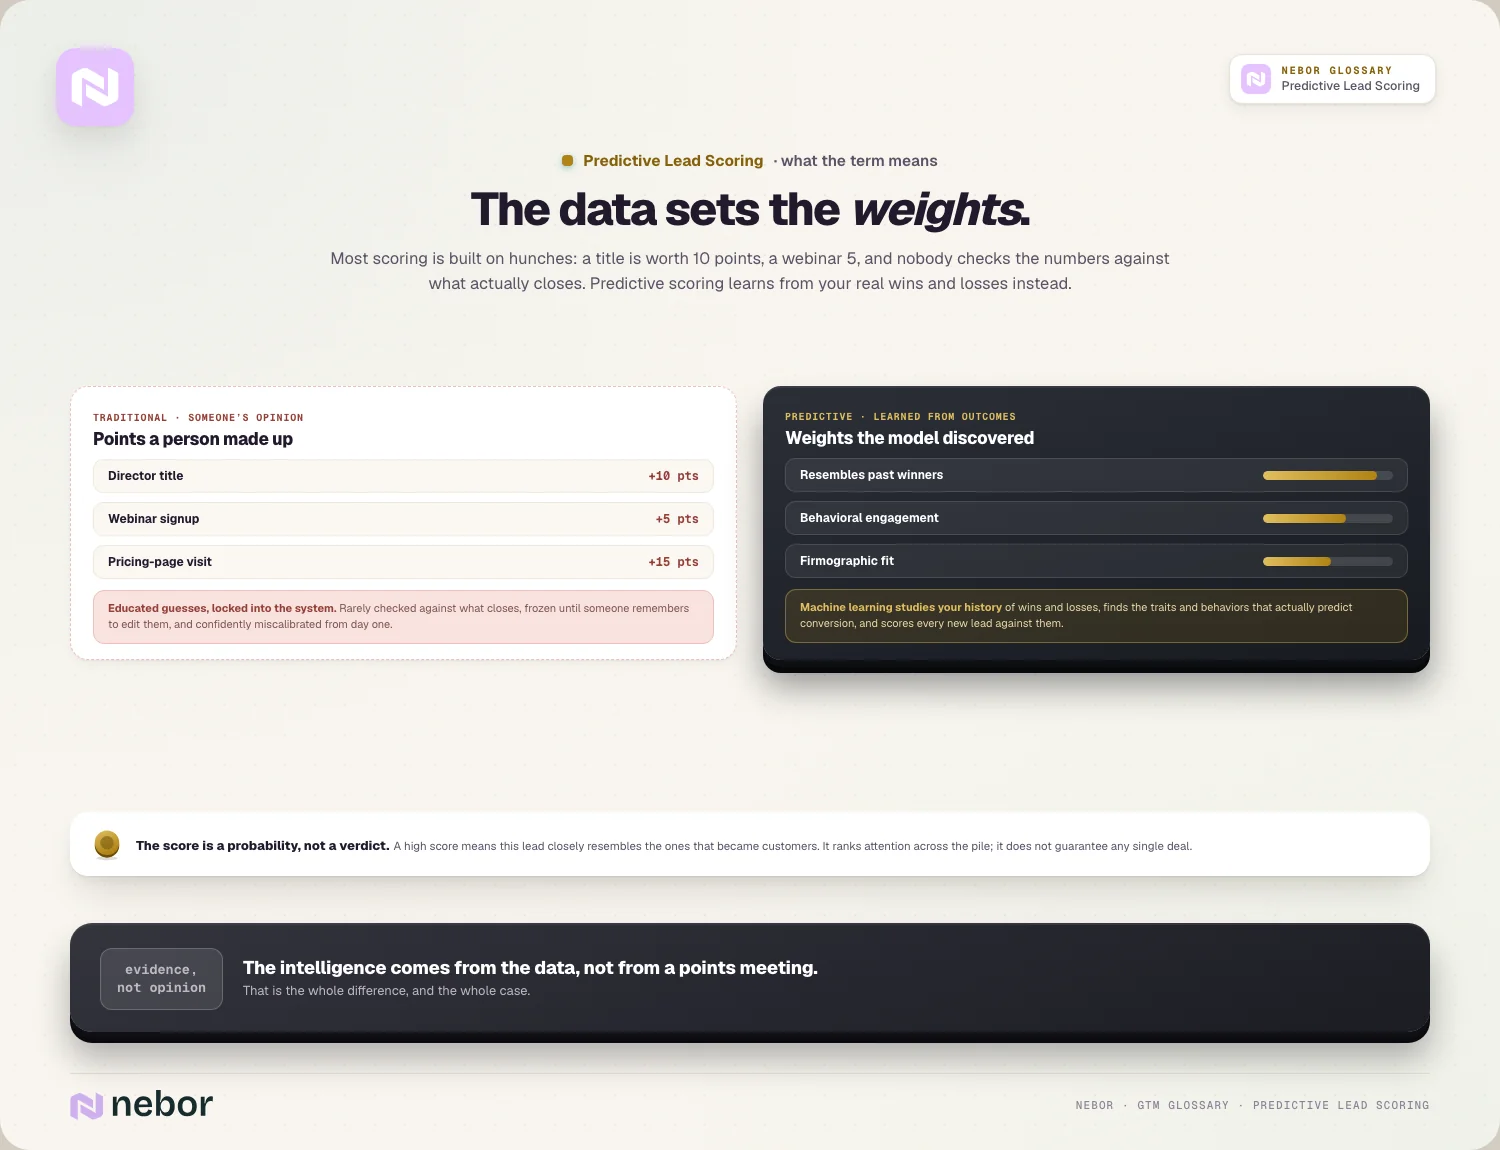
Met het label en het venster vastgelegd zoekt het model naar wat de wins onderscheidde: bedrijfsgrootte en branche uit je firmografische data, functietitel, leadbron en gedrag zoals bezoeken aan de prijspagina, demo-aanvragen en replies. Het weegt die factoren samen. Zo kan het ontdekken dat een webinaraanmelding op zichzelf niets voorspelt, en heel veel bij bedrijven boven een bepaald aantal medewerkers.
De twee grote CRM's beantwoorden niet eens dezelfde vraag. Einstein Lead Scoring van Salesforce bouwt zijn model op de eerder geconverteerde leads van je team. HubSpot definieert zijn property Likelihood to close als de kans dat een contact binnen de komende 90 dagen klant wordt. Een lead die makkelijk meetings boekt maar een jaar nodig heeft om te tekenen, kan in de ene tool sterk scoren en in de andere middelmatig. Weet dus welke vraag je score beantwoordt voordat je erop routeert.
Predictive lead scoring in Salesforce, HubSpot of je eigen stack
Je kunt het model in je CRM aanzetten, of er zelf een bouwen buiten je CRM en de score terugschrijven. De routes verschillen meer dan de marketing doet vermoeden.
Salesforce Einstein Lead Scoring | HubSpot Likelihood to close | Een model dat je zelf bouwt | |
|---|---|---|---|
Wat het voorspelt | Leadconversie, geleerd uit je geconverteerde leads | De kans dat een contact binnen 90 dagen klant wordt | Elk label dat je kiest |
Benodigde historie | Een gepubliceerd minimum per segment, met een globaal model tot je dat haalt | Niet gepubliceerd | Jouw keuze, en jouw risico |
Laat zijn redenering zien | Toont de belangrijkste positieve en negatieve factoren | Nee | Ja, als je een methode kiest die dat kan |
Opnieuw trainen | Ongeveer elke 10 dagen | Niet gepubliceerd | Volgens het schema dat jij instelt |
Hoe je eraan komt | Sales Cloud Einstein: Performance en Unlimited, betaalde add-on bij Enterprise | Marketing Hub Enterprise of Sales Hub Enterprise | Je data in een warehouse of een Clay-tabel, een model dat je zelf traint, en de score teruggeschreven naar het CRM |
De setupgids voor Sales Cloud Einstein van Salesforce noemt twee details waar mensen over struikelen. De datadrempels die op onze pagina over lead scoring staan, gelden voor elk segment dat je aanmaakt. Het totaal halen is dus niet genoeg. Splits je binnenlandse en internationale leads in aparte segmenten, wat de gids zelf aanraadt als hun conversiepatronen verschillen, dan moet elke helft op eigen kracht over de lat. Leads die in geen enkel segment vallen, worden genegeerd als het model wordt gebouwd.
Het artikel van HubSpot over predictive lead scoring is open over de aanpak: het noemt het model black-box machine learning en verdeelt contacten in de property Contact priority over vier niveaus van elk 25%. Dat werkt prima om een wachtrij te rangschikken, en het is lastig te verdedigen als sales vraagt waarom een lead bij hen terechtkwam. Wil je regels die je kunt lezen, dan staat de setup in ons artikel over HubSpot lead scoring.
Als het model het antwoord al kent
De snelste manier om een model te bouwen dat briljant oogt en in productie faalt, is leakage. De documentatie van scikit-learn definieert data leakage als het bouwen van een model met informatie die op het moment van voorspellen nog niet beschikbaar zou zijn. Volgens diezelfde documentatie levert dat te optimistische resultaten op, die op nieuwe data uit elkaar vallen.
CRM's zitten vol met zulke velden. Een leadstatus "Disqualified", een reden van diskwalificatie, een vinkje "meeting geboekt", een eigenaarsveld dat na kwalificatie overgaat naar een account executive, het aantal gelogde salesactiviteiten (reps loggen meer op leads die goed lopen). Bij historische leads komen deze velden bijna perfect overeen met de uitkomst, dus het model leunt erop. Bij een lead die tien minuten geleden binnenkwam, zijn ze allemaal leeg, en dan valt de score uiteen in ruis.
De setupgids van Salesforce geeft zelf het schoolvoorbeeld: een veld dat vastlegt waarom een lead niet converteerde, hoort buiten het model te blijven. De algemene regel is strenger. Elk veld dat zijn waarde krijgt door de uitkomst, of erna, blijft erbuiten.
De zuiverste oplossing is trainen op snapshots. Leg vast hoe elke lead eruitzag toen hij binnenkwam, of op het moment waarop je hem echt zou scoren, en train daarop in plaats van op de huidige versie van het record. Lukt dat niet, loop dan de meegenomen velden langs en vraag bij elk veld wanneer het wordt ingevuld. En zie een backtest die te mooi lijkt als waarschuwing, want een model dat bijna nooit fout zit, heeft meestal het antwoord gezien.
Leads scoren voordat je de historie hebt
Een jong bedrijf, een nieuwe productlijn of een nieuwe markt: ze beginnen allemaal met te weinig uitkomsten om een model van te laten leren. Einstein lost dat op met een globaal model, gebouwd op anonieme data van veel Salesforce-klanten, dat het vervangt zodra je eigen model beter presteert. Dat is een redelijke tussenoplossing, maar het leerde van de kopers van andere bedrijven.
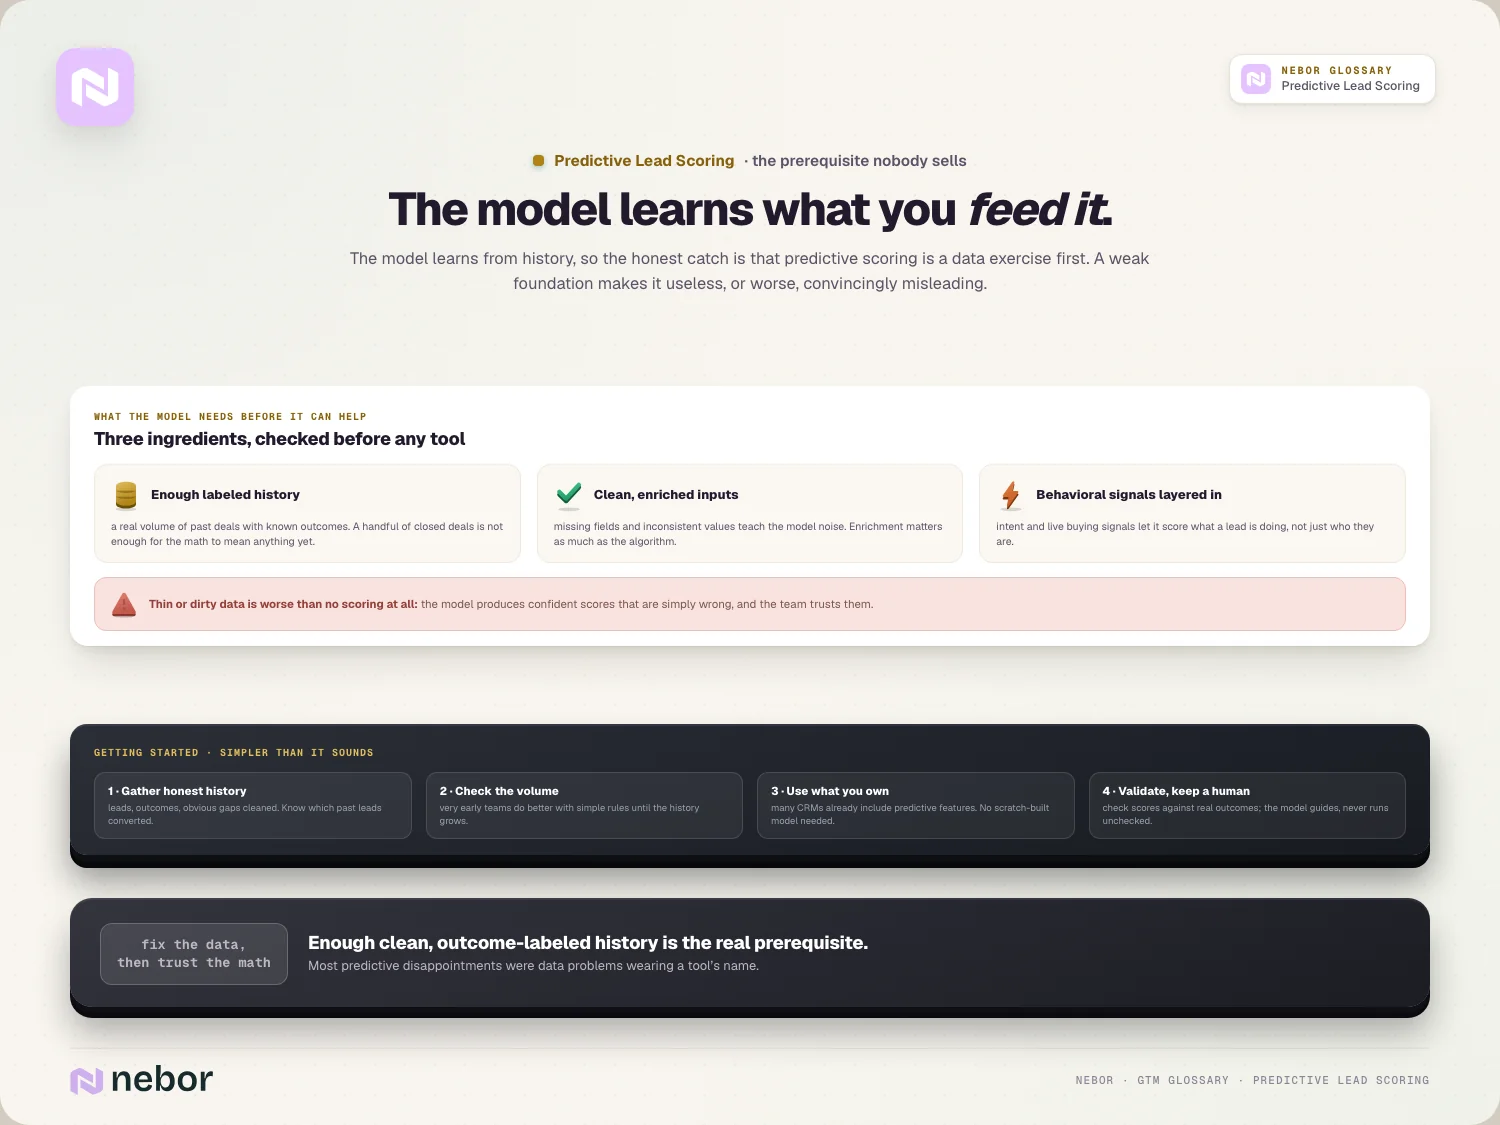
Er zijn betere manieren om dat gat te overbruggen, en ze kunnen naast elkaar draaien:
Draai een score op basis van regels die je reps kunnen lezen, en behandel elke geaccepteerde en afgewezen lead als toekomstig trainingsvoorbeeld.
Train op een eerder label dat vaker voorkomt. De meeste opportunities sluiten nooit, dus "opportunity aangemaakt" geeft een model veel meer positieve voorbeelden dan "closed won". Wissel van label zodra de historie het toelaat.
Scoor fit apart, op basis van je closed-won-accounts. Een lookalike-model heeft alleen je klantenlijst en goede bedrijfsdata nodig. Daarom beginnen we vaak met een closed-won-lookalike-workflow en leggen we er later gedrag bovenop.
Vul eerst de velden. Een model kan niet leren van een bedrijfsgrootte die op de helft van je records leeg is, dus data enrichment hoort vóór het trainen. Achteraf verrijken is te laat.
Intent data en koopsignalen zoals een recente kapitaalronde of een wissel in de salesleiding helpen ook bij een dunne historie. Ze onderscheiden een goed passend account dat actief in de markt is van een account dat alleen goed past.
Feature drift: waarom de winnaars van vorig jaar niets meer voorspellen
Een model is een momentopname van wat conversie voorspelde tijdens zijn trainingsvenster. De documentatie van Vertex AI van Google Cloud beschrijft inference drift als wat er gebeurt wanneer de verdeling van de features (de inputs van het model) in productie in de loop van de tijd sterk verandert. Gewoon gezegd: de leads die binnenkomen, lijken niet meer op de leads waarvan het model leerde.
In GTM-werk komt dat meestal door gewone beslissingen. Je opent een nieuw land waar het model nog nooit een conversie heeft gezien. Marketing start een webinarprogramma en één leadbron verdrievoudigt. Iemand kort het demoformulier in, en nu komt bedrijfsgrootte leeg binnen. Je wisselt van enrichmentprovider, en de branchelabels sluiten niet aan op de oude. Elke verandering verschuift de inputs, en gewichten die uit de oude mix zijn geleerd, gaan de verkeerde kant op wijzen.
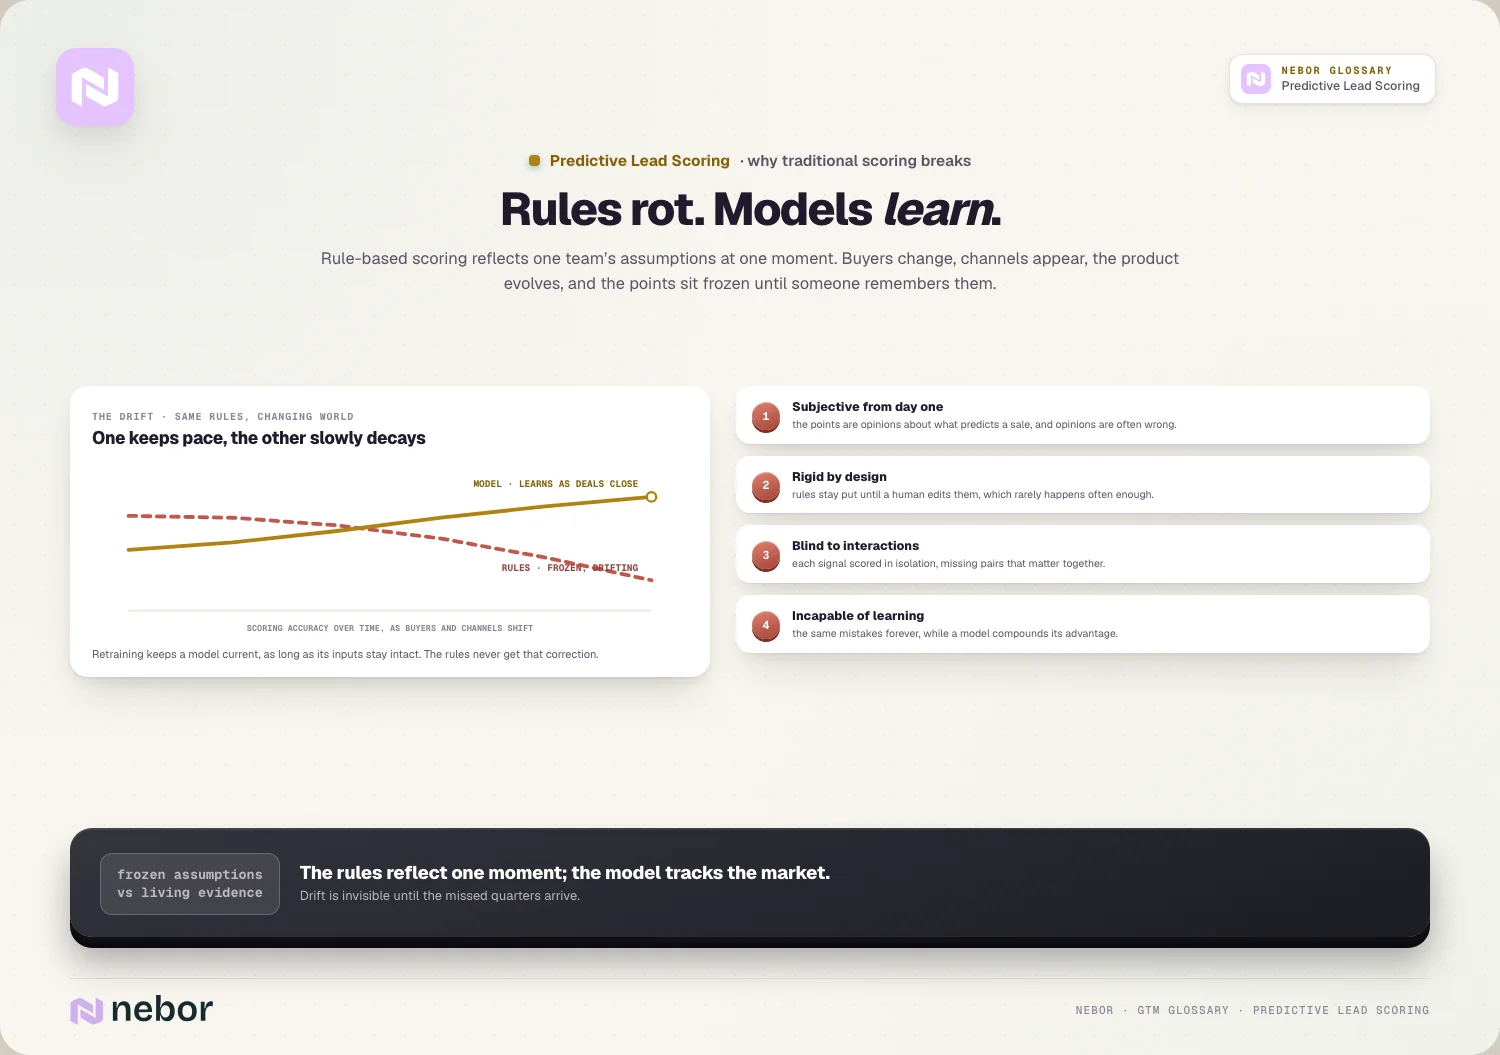
Opnieuw trainen vangt een deel hiervan op. Einstein analyseert je leads ongeveer elke 10 dagen opnieuw, dus een echte verandering in wie er koopt, wordt opgepikt. Wat het niet kan repareren, is een kapotte input. Maakt een formulierwijziging bedrijfsgrootte leeg, dan leert het model gewoon dat leeg normaal is en verliest het een goede voorspeller zonder iemand iets te laten weten.
HubSpot voegt er een subtielere valkuil aan toe. Omdat elk niveau in Contact priority een kwart van je contacten bevat, zit "Very high" altijd vol, ook in een maand waarin de kwaliteit van alle leads daalt. Kijk dus naar de kans achter het niveau. Het niveau zelf zegt weinig.
Een maandelijkse check dekt het meeste af. Kijk of de hoge scorebanden nog steeds ruim beter converteren dan de lage, en houd je belangrijkste inputs in de gaten: het aandeel leads met een lege bedrijfsgrootte, de mix van bronnen, het aandeel uit nieuwe regio's. Beweegt een van de twee, zoek dan uit waarom voordat je de volgende ronde scores vertrouwt.
Kan een rep zien waarom een lead 87 scoort?
Een score zonder redenen vraagt reps om hem op goed vertrouwen aan te nemen, en dat doen reps niet. HubSpot zegt ronduit dat je niet precies kunt weten hoe elke input bijdraagt aan de score van een contact. Salesforce kiest de andere route: de Einstein-scores komen met de belangrijkste positieve en negatieve voorspellende factoren achter het getal, zoals de module over Einstein scoring op Trailhead laat zien voor behavior scoring.
Zichtbare redenen doen twee dingen. Een rep die "VP-titel, deze week drie keer de prijspagina bezocht, kernbranche" ziet, kan het gesprek openen met iets echts, of tegengas geven als een factor duidelijk niet klopt. En wie eigenaar is van het model, krijgt er gratis een leakage-alarm bij: is een van de belangrijkste factoren een veld dat pas na kwalificatie wordt ingevuld, dan heb je je probleem gevonden voordat het de routing bereikt.
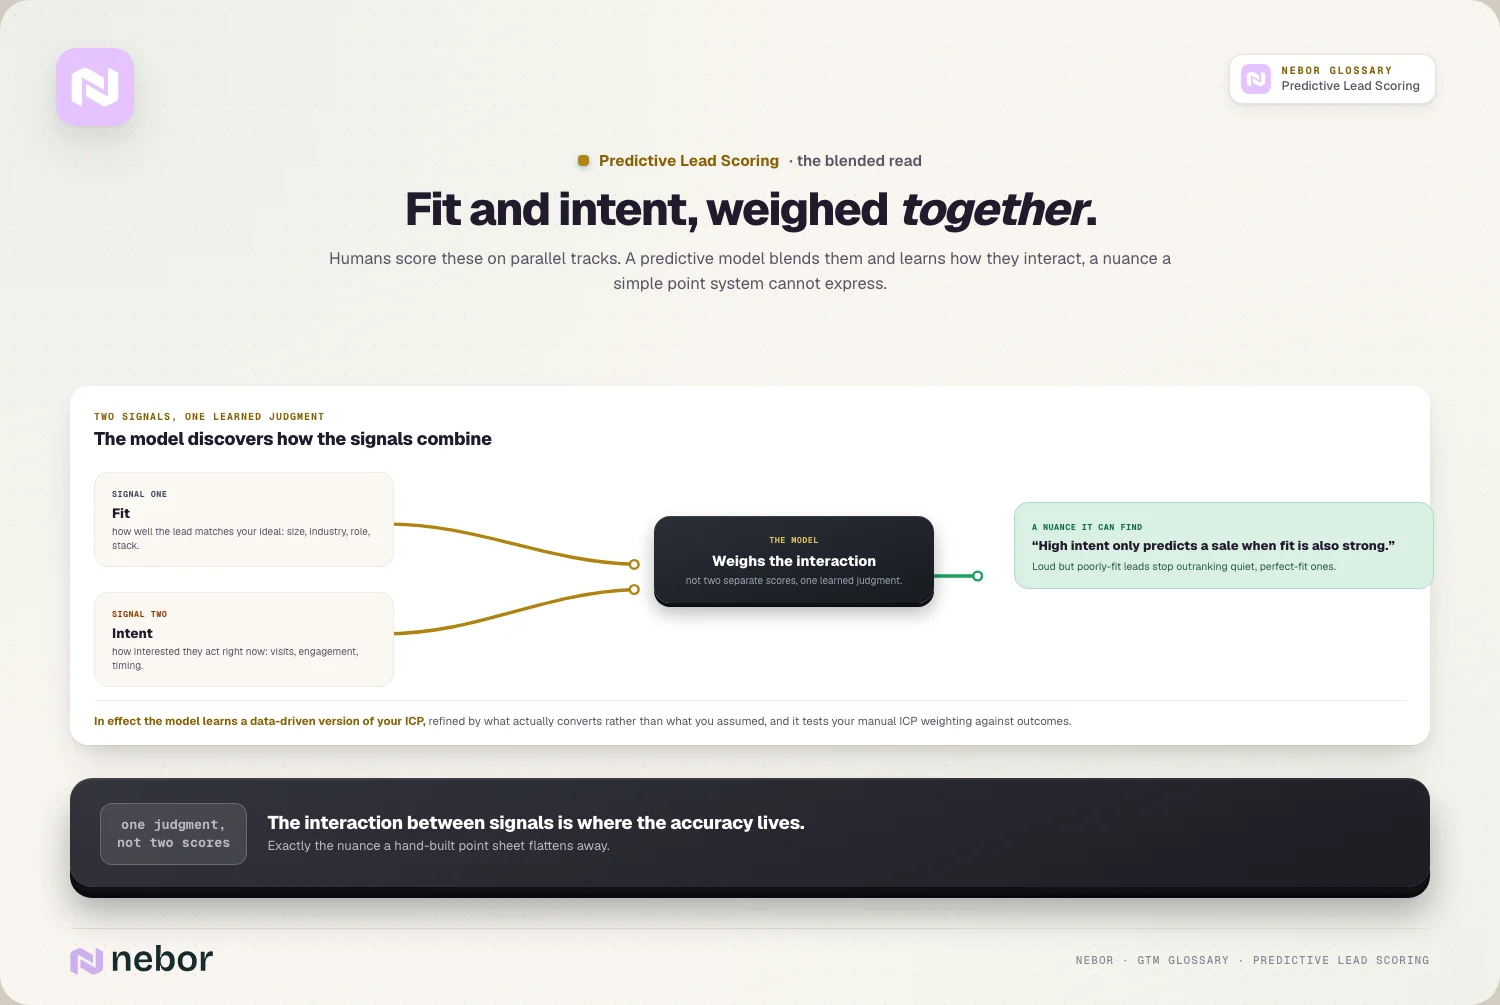
De redenen laten ook zien waar een model het wint van regels die je met de hand bouwt. Puntensystemen houden de fit score en intent score meestal op aparte sporen. Een model kan leren hoe ze op elkaar inwerken, bijvoorbeeld dat veel engagement alleen een deal voorspelt als de fit ook sterk is. In feite schrijft het een datagedreven versie van je ideal customer profile, en het kan de gewichten in een handmatig ICP-scoringsmodel toetsen aan wat echt sloot.
Waar reps zelf bepalen wie ze bellen, kiezen wij liever een iets minder nauwkeurig model dat ze kunnen lezen dan een black box die ze negeren.
Backtest het eerst op de leads van vorig kwartaal
Voordat een predictive score aan de routing komt, wil je weten of hij leads überhaupt sorteert. Train het model op data tot een peildatum, scoor de leads die in het kwartaal daarna binnenkwamen en vergelijk per scoreband wat er met ze gebeurde. Converteerde het bovenste tiende deel veel beter dan gemiddeld en converteerde de onderste helft bijna nooit, dan sorteert het model. Is de conversie over de banden heen vlak, dan sorteert het niet, hoe zelfverzekerd de getallen er ook uitzien. Haal je huidige score op basis van regels door dezelfde test, zodat je weet of de overstap een verbetering is of alleen een verandering.
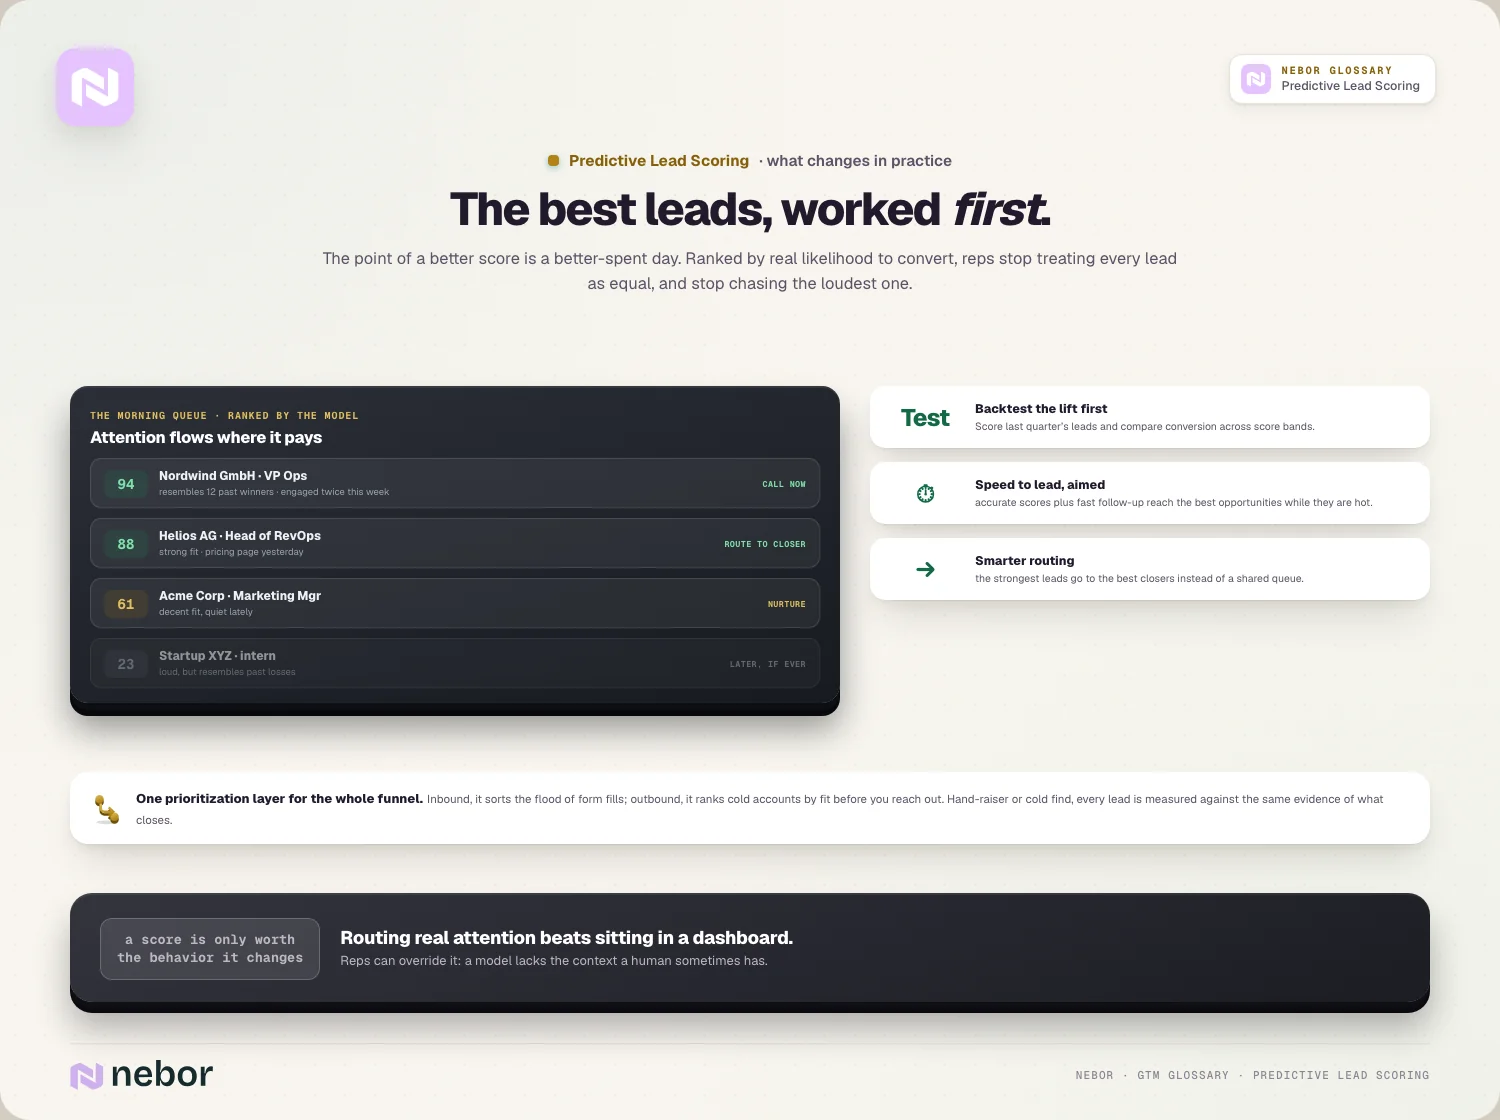
Laat de score daarna een paar weken in de schaduw draaien. Laat reps de nieuwe score naast de oude zien zonder te veranderen wie wat krijgt, en verzamel de leads waarover de twee het oneens zijn. Elk verschil is een patroon dat de oude regels misten of een fout die het model maakt, en allebei zijn ze het weten waard.
Pas daarna mag de score acties aansturen. Koppel de bovenste band aan lead routing zodat sterke leads bij je beste closers terechtkomen, combineer het met snelle follow-up zodat speed to lead geldt voor de leads die het verdienen, en laat de regels achter je geautomatiseerde outbound op de score reageren zonder dat een rep een dashboard hoeft te checken. Beter gerangschikte leads converteren sneller en vaker, en daar komt de winst in pipeline velocity vandaan.
Niets hiervan werkt als je verwacht dat de tool het denkwerk levert. Diezelfde verwachting verklaart ook waarom zoveel Clay-uitrols vastlopen. Iemand moet nog steeds beslissen wat een conversie is, welke velden mogen meedoen en wat er met een lead gebeurt zodra hij hoog scoort.
Samenvatting
Predictive lead scoring ruilt meningen over wie er koopt in voor een patroon dat is geleerd van wie echt kocht. Dat wint het van elk puntenschema, zolang het patroon uit eerlijk materiaal komt.
Eerlijk materiaal betekent een label dat je bewust hebt gekozen, een trainingsvenster dat jonge leads niet afstraft en geen velden die de uitkomst al kennen. Het betekent genoeg historie per segment, met regels of een lookalike-model als vervanging tot je die hebt. En het betekent de inputs na de lancering in de gaten houden, want een nieuwe markt of een korter formulier kan veranderen wat het model ziet, lang voordat iemand merkt dat de scores zijn gaan schuiven.
De scores die blijven, zijn de scores die reps begrijpen: een model dat zijn redenen laat zien en zich op de leads van vorig kwartaal heeft bewezen voordat het het overnam. Het past ook goed in hoe een GTM-systeem bepaalt waar de inzet naartoe gaat, als de laag die de aandacht verdeelt voor alles wat daarna komt.
Wil je dat iemand meekijkt naar je trainingshistorie voordat je een model vertrouwt? Nebor zet predictive scoring op in het CRM waarin je reps elke dag werken, backtest het tegen je eigen gesloten deals en laat je team de veldenlijst, de backtestresultaten en een monitoringrapport na dat ze zelf opnieuw kunnen draaien.
Veelgestelde vragen
Is predictive lead scoring beter dan lead scoring op basis van regels?
Dat kan, zodra je genoeg schone historie hebt. Scoring op basis van regels gebruikt puntenwaarden die iemand heeft gekozen, en die waarden worden zelden getoetst aan wat er sloot. Een predictive model leert de gewichten uit je gewonnen en verloren leads en past ze aan als het opnieuw traint. Met dunne of rommelige data doet een leesbare score op basis van regels het meestal beter. Veel teams houden ook regels voor harde uitsluiters, zelfs nadat een model de rangschikking heeft overgenomen.
Werkt predictive lead scoring ook voor outbound prospects, naast inbound leads?
Ja, met één aanpassing. Inbound leads komen binnen met gedrag dat het model kan lezen, zoals paginabezoeken en ingevulde formulieren. Koude outbound prospects hebben vooral fitdata, zoals branche, omvang, techstack en rol. Een model dat is getraind op je closed-won-accounts kan een koude lijst rangschikken op hoe sterk elk account op eerdere klanten lijkt. Intent- of wervingssignalen bepalen daarna welke van de goed passende accounts je als eerste benadert.
Heb je een datateam nodig om predictive lead scoring te gebruiken?
Niet om te beginnen. Salesforce en HubSpot hebben allebei predictive scoring in bepaalde edities, en gespecialiseerde scoringvendors verkopen het als dienst. Wat je wel nodig hebt, is iemand die de data begrijpt: welke gebeurtenis telt als conversie, welke velden pas na de uitkomst worden ingevuld en of de historie elk segment dekt waaraan je verkoopt. Dat is eerder RevOps-werk dan data science, en het bepaalt of de scores iets betekenen.
Bij welke HubSpot-abonnementen zit predictive lead scoring?
De properties Likelihood to close en Contact priority van HubSpot zijn beschikbaar met Marketing Hub Enterprise of Sales Hub Enterprise. Likelihood to close is de geschatte kans dat een contact binnen 90 dagen klant wordt, en Contact priority verdeelt contacten op basis van die kans over vier even grote niveaus. HubSpot vult beide properties automatisch in, je kunt ze niet bewerken en HubSpot laat niet zien hoe elke input bijdraagt aan de score.
Wat is het verschil tussen predictive lead scoring en opportunity scoring?
Lead scoring voorspelt of een nieuwe lead converteert. Opportunity scoring voorspelt of een open deal sluit, met signalen als de leeftijd van de deal, beweging tussen fases en activiteit. Ze hebben een andere historie nodig. Salesforce vraagt bijvoorbeeld om minstens 200 closed-won-opportunities in de afgelopen 24 maanden voordat Einstein Opportunity Scoring een model bouwt op je eigen data. Veel teams gebruiken allebei: de een om te bepalen wie wordt bewerkt, de ander om de pipeline te beoordelen.
Waarom veranderden onze predictive lead scores terwijl er in het CRM niets veranderde?
Meestal omdat het model opnieuw is getraind. Einstein analyseert je leads ongeveer elke 10 dagen opnieuw, dus nieuwe uitkomsten kunnen de gewichten verschuiven en scores laten bewegen op leads die zelf niets deden. In HubSpot zijn de niveaus van Contact priority relatief, met een kwart van de contacten in elk niveau. Een lead kan dus een niveau zakken alleen omdat er betere leads binnenkwamen. Check of de onderliggende kans bewoog voordat je een niveauwijziging als nieuws over de lead behandelt.
Kun je een predictive lead score combineren met handmatige scoringsregels?
Ja, en vaak is dat de meest praktische opzet. Laat het model leads rangschikken op hun kans om te converteren, en houd een paar handgeschreven regels voor dingen die het model te licht weegt of nooit heeft gezien, zoals concurrenten, studenten, bestaande klanten of een regio die je niet meer bedient. Houd de regels beperkt en gedocumenteerd, en check dat ze niet gewoon terugdraaien wat het model leerde. Anders scoor je weer op mening.
Is AI lead scoring hetzelfde als predictive lead scoring?
Grotendeels, al worden de termen nogal los gebruikt. Predictive lead scoring betekent dat een machine learning-model, getraind op je eerdere uitkomsten, inschat hoe groot de kans is dat elke lead converteert. Sommige producten die als AI lead scoring worden verkocht, doen precies dat. Andere gebruiken een taalmodel om de website of het profiel van een lead te lezen en fit te beoordelen tegen een geschreven beschrijving van je ideale klant. Dat is nuttig onderzoek, alleen is het niet getraind op je gewonnen en verloren deals.
Mogen reps een predictive lead score overrulen?
Ja, zolang de override wordt vastgelegd. Een rep die de champion kent van een vorig bedrijf, of net hoorde dat het account zijn budget kwijt is, heeft context die geen model ziet. Vraag bij elke override om een korte reden en bekijk ze elke maand. Overrides die steeds terecht blijken, wijzen op signalen die het waard zijn om aan het model toe te voegen. Overrides die steeds fout blijken, laten zien waar reps de score meer moeten vertrouwen.
Welke data gebruikt een model voor predictive lead scoring?
Alles wat vóór de uitkomst op de lead staat. Meestal zijn dat firmografische gegevens zoals branche, bedrijfsgrootte en locatie, de functietitel en senioriteit van de persoon, de leadbron en campagne, en gedrag zoals paginaweergaven, ingevulde formulieren, replies op e-mails en meetings. Het model van HubSpot gebruikt ook firmografische data van het gekoppelde bedrijf. Velden die na de conversie worden ingevuld, zoals een reden van diskwalificatie of het aantal salesactiviteiten, moet je uitsluiten, omdat ze het antwoord verraden.
Deel dit bericht
AI
Data
RevOps
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen


Klaar om je pipeline te bouwen