In this post:
Self-reported attribution is de praktijk waarbij je nieuwe leads vraagt hoe ze voor het eerst over je hebben gehoord, meestal met één open vraag op een demo- of contactformulier, en hun antwoord vastlegt naast de bron die je trackingsoftware heeft toegekend.
Het bestaat omdat het antwoord van de software vaak op een voorspelbare manier fout zit. Tracking legt de eerste klik vast die het kon zien. Een koper die in maart je founder in een podcast hoorde, in april je naam kreeg van een oud-collega en in juni je URL intypte, komt in het CRM binnen als direct verkeer. De twee dingen die haar echt overtuigden, laten geen enkel spoor na.
De meeste teams die het proberen, blijven halverwege steken. Ze voegen het veld toe, de antwoorden stapelen zich op in een tekst-property, en zes maanden later exporteert iemand een kolom vol "Google", "LinkedIn" en "een vriend" die je niet kunt tellen en nergens mee kunt vergelijken. De vraag stellen is het makkelijke deel. Of de data ooit een budget verandert, hangt af van hoe je het veld opzet en wat er met elk antwoord gebeurt nadat het binnenkomt.
TL;DR
Attributie via software rapporteert het eerste getrackte bezoek, terwijl het antwoord van de koper gaat over wat hem ertoe bracht je op te zoeken. HubSpot vult de property Original Traffic Source automatisch met de eerste bekende webbron, dus een podcast of de aanbeveling van een vakgenoot kan daar nooit in verschijnen.
Formuleer de vraag rond de eerste keer ("Hoe heb je voor het eerst over ons gehoord?"), maak er een verplicht vrij tekstveld van, vraag om een paar woorden in plaats van een verhaal, en zet hem alleen op formulieren voor een demo, prijzen of contact met sales, als laatste veld vóór de verzendknop.
Een dropdown stuurt het antwoord. In een test van het Pew Research Center koos 58% van de mensen de economie als die als optie werd aangeboden, terwijl maar 35% hem uit zichzelf noemde als niemand hem had gesuggereerd.
Bewaar het ruwe antwoord en een gecodeerde categorie in twee aparte properties, codeer elke week aan de hand van een vaste lijst van acht tot twaalf categorieën, en zet de naam van de podcast of community in een derde veld.
Rapporteer het gecodeerde antwoord naast de getrackte bron voor elke opportunity, gewogen naar pipeline in euro's. Het verschil tussen de twee kolommen is de bevinding, en meestal laten ongetrackte kanalen daar hun waarde zien.
Het geheugen onthoudt vooral recente, opvallende contactmomenten. Eén antwoord bewijst niets, dus lees de data in bulk en reken pas na een paar honderd antwoorden op een beeld waar je op kunt plannen.
Twee verschillende antwoorden op "waar kwam deze lead vandaan?"
Elk CRM vult een bron voor je in. De documentatie van HubSpot is precies over wat het vastlegt: de property Original Traffic Source toont de eerste bekende webbron, en HubSpot vult die automatisch in op basis van de interacties van het contact. De twee woorden die ertoe doen, zijn "bekende" en "web". Alles wat vóór het eerste getrackte bezoek gebeurde, of buiten een browser om, kan niet in dat veld staan.
De property beantwoordt dus een smalle vraag: welk traceerbaar bezoek kwam eerst? Het antwoord van de koper gaat over een andere vraag: waardoor ging ik zoeken? Bij een betaalde zoekklik op een koopgericht zoekwoord overlappen die twee. Bij een aanbeveling tijdens de lunch liggen ze volledig uit elkaar.
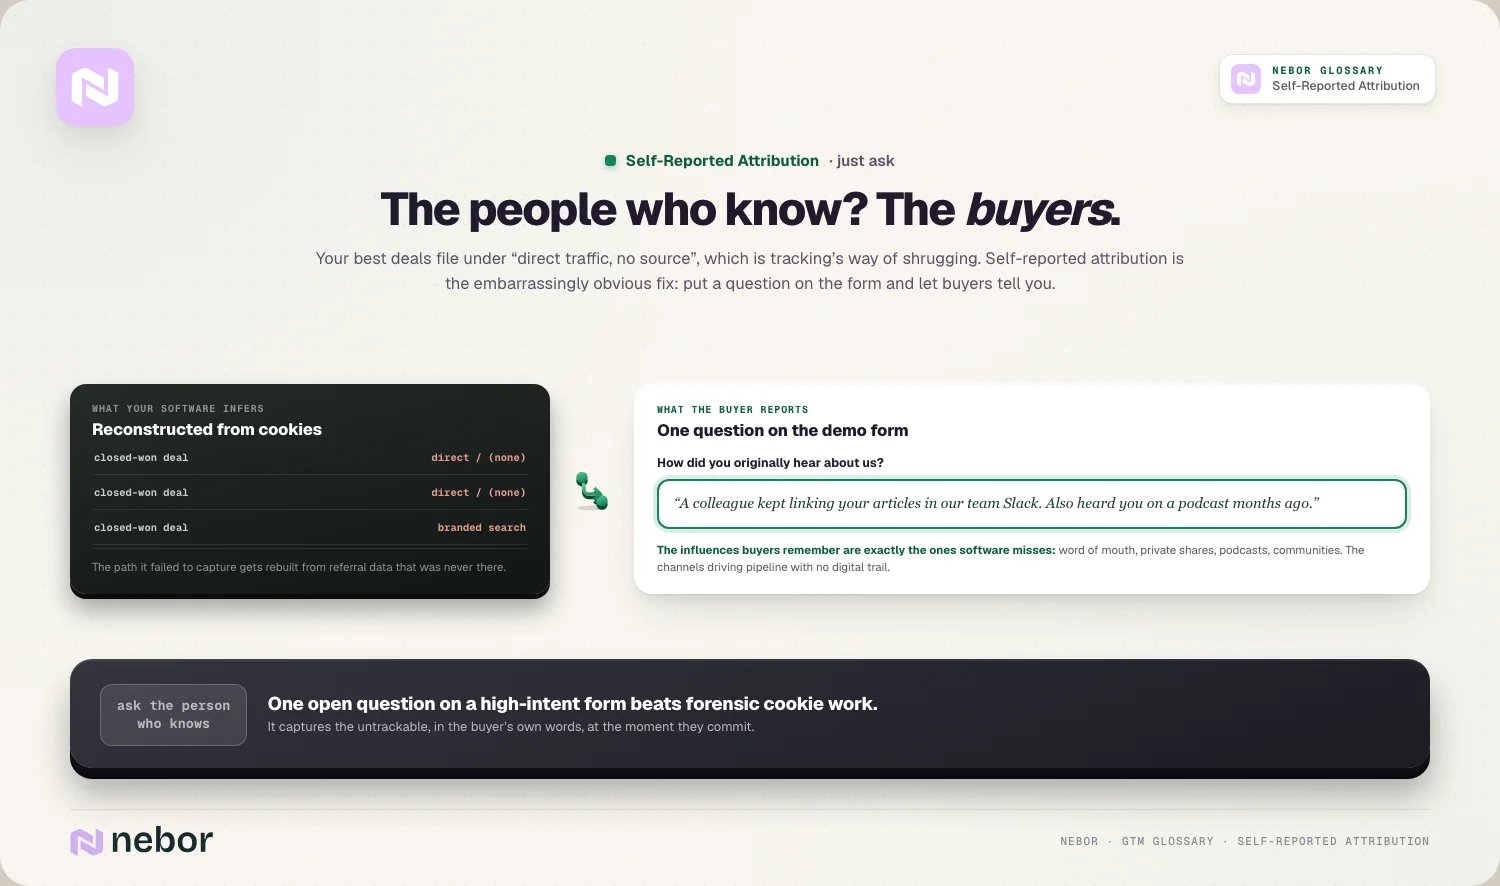
Neem een lead uit finance van wie een collega je artikel in een teamkanaal op Slack plakte. Ze opent het, leest het, sluit het, en twee weken later typt ze je adres in haar browser. Tracking zegt direct verkeer. Op het formulier schrijft ze: "collega deelde jullie post in onze Slack, jullie ook in een podcast gehoord". Dat is dark social dat voor één keer onder zijn echte naam in je data opduikt.
Geen van beide antwoorden is het ware. De software is exact over de kliks die hij zag en blind voor de rest, en de koper herinnert zich de rest en vergeet heel wat kliks. Het bredere gebied van invloed die nergens wordt vastgelegd, beschrijven we onder de dark funnel. Deze pagina blijft bij het veld dat een deel ervan opvangt, en bij het werk om wat het opvangt om te zetten in cijfers.
Zo ontwerp je een veld voor self-reported attribution
Vier beslissingen bepalen de data voordat er één antwoord binnen is: de formulering, het formaat, welke formulieren het veld krijgen en waar het daarop staat. Zit je daar fout, dan repareert geen enkele analyse achteraf het nog.
Vraag naar de eerste keer
"Hoe heb je over ons gehoord?" klinkt neutraal, maar kopers beantwoorden die vraag vaak met de laatste stap, omdat die het meest vers in het geheugen ligt. Je krijgt dan "Google" van iemand die na een podcast je naam googelde. "Hoe heb je voor het eerst over ons gehoord?" stuurt het geheugen terug naar het moment waarop je op hun radar kwam, en dat is precies wat je tracking al mist.
Een derde versie, "Waarom neem je vandaag contact op?", vangt weer iets anders op: de trigger, zoals een nieuwe medewerker, een tool die het liet afweten of een deadline van het bestuur. Daar heeft sales wat aan, alleen is het geen bron. Wil je allebei, stel de vraag naar de trigger dan in het eerste gesprek en houd het formulier voor de bron.
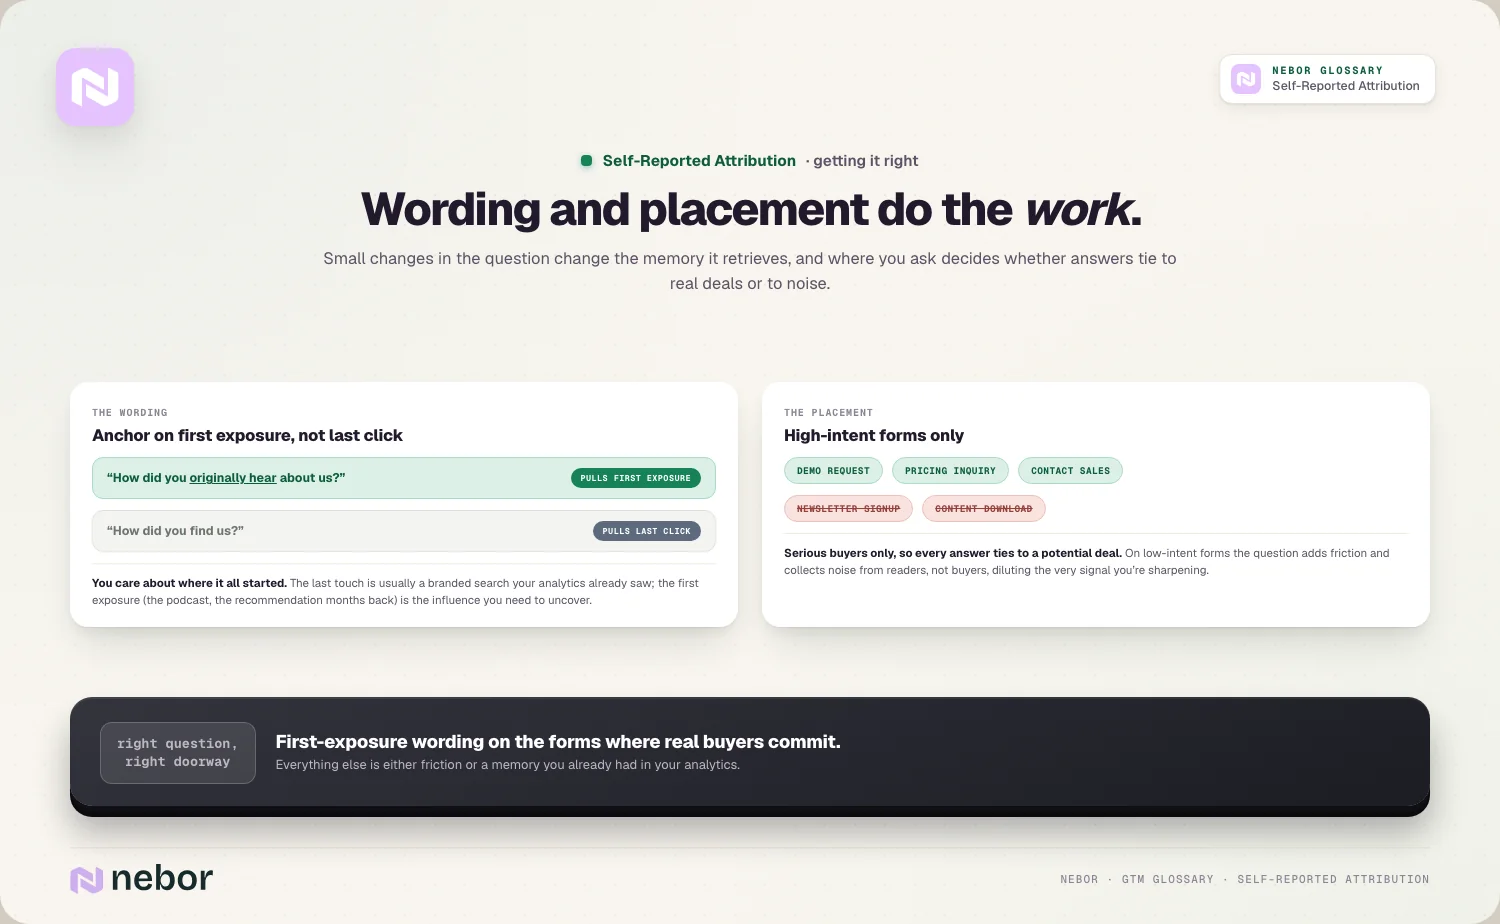
Let op met hulptekst. Een regel als "bijv. podcast, LinkedIn, een collega" is een kleine dropdown in vermomming, en trekt antwoorden naar die drie toe. "Een paar woorden is genoeg" doet hetzelfde werk zonder iets voor te zeggen.
Vrije tekst, omdat een lijst het antwoord voor ze invult
Een nette keuzelijst voelt als betere data. Dat is het niet, omdat een lijst bepaalt wat mensen zeggen. Het Pew Research Center testte dit met een vraag over welk onderwerp in 2008 het zwaarst woog voor kiezers. Stond de economie als optie in de lijst, dan koos 58% hem. Was de vraag open, dan noemde 35% uit zichzelf de economie, en gaf 43% een antwoord dat helemaal niet op de gesloten lijst stond. Op dezelfde pagina staat dat mensen die zelf een formulier invullen, vaker opties bovenaan een lijst kiezen.
Voor een attributieveld betekent dat: een dropdown bevestigt de kanalen waar je al aan dacht en begraaft al het andere onder "Anders". De community waar je nog nooit van hoorde, die ene podcast, de oud-klant die nu bij een prospect werkt: die zie je alleen als de koper ze zelf opschrijft.
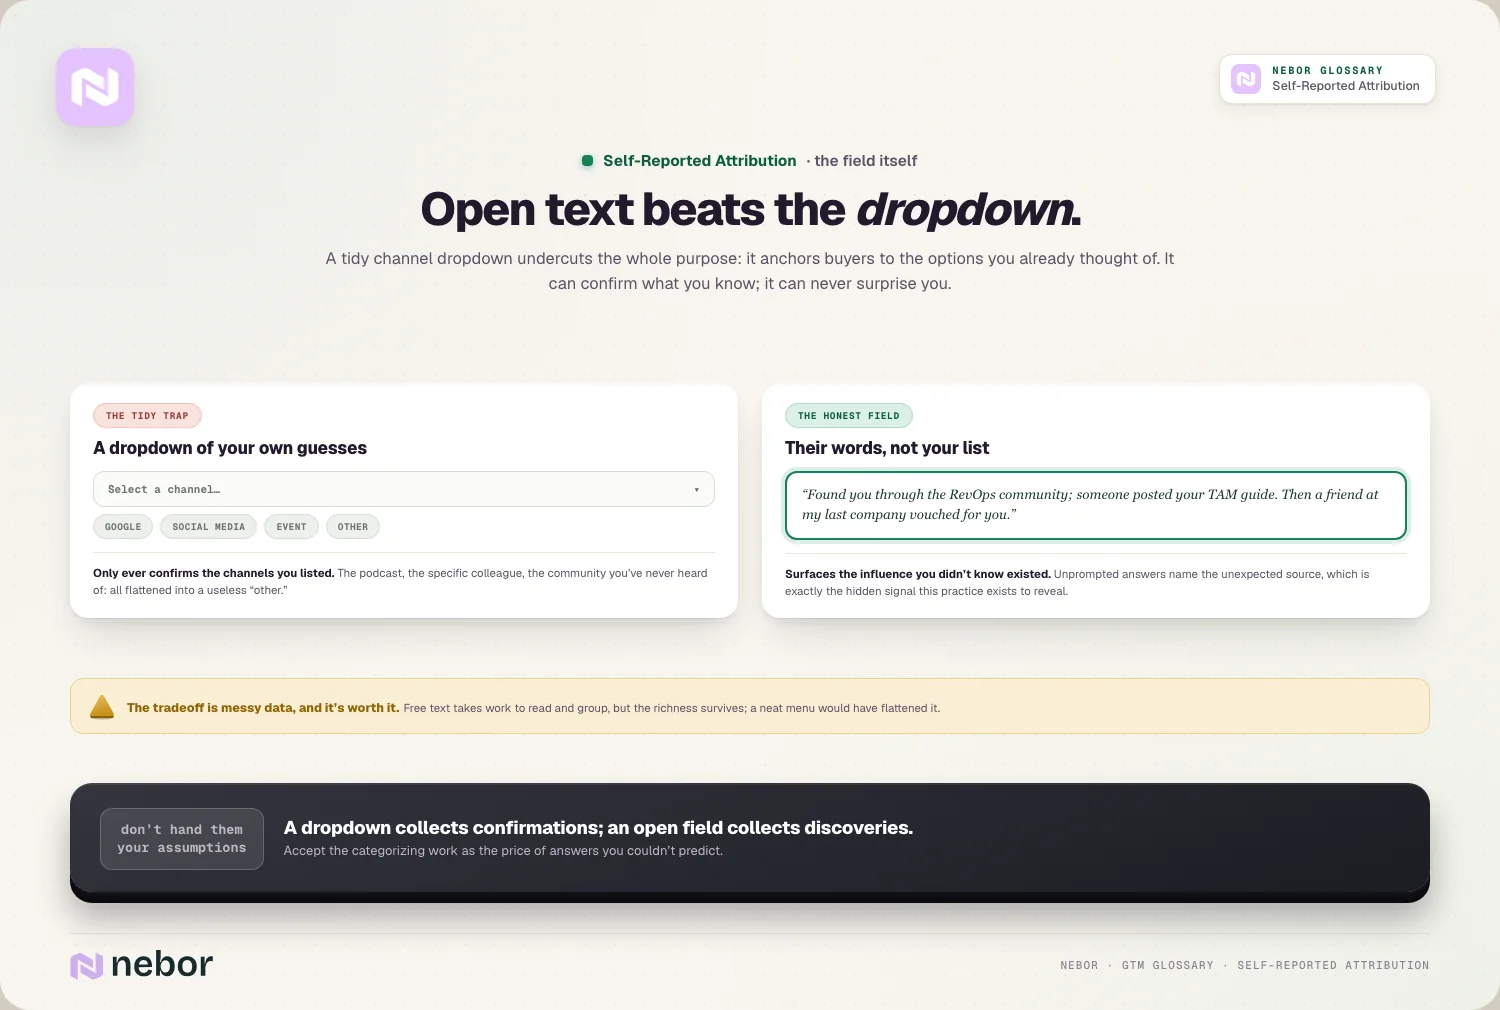
Open vragen worden wel vaker overgeslagen. Uit panelonderzoek van Pew bleek dat open vragen gemiddeld zo'n 18% non-respons hadden, tegen 1% tot 2% bij gesloten vragen, en dat vragen die om een paar zinnen vroegen vaker werden overgeslagen dan vragen die om een woord of een korte zin vroegen. Daar volgen twee oplossingen uit. Maak het veld verplicht op demoformulieren, en maak duidelijk dat een kort antwoord prima is. Reken toch op wat antwoorden als "weet niet" en "google". Die krijgen hun eigen categorie, en het blijft data.
Welke formulieren, en welke plek op het formulier
Zet de vraag op de formulieren waarmee iemand vraagt om met je te praten: demo-aanvragen, prijsaanvragen, contact met sales en het boeken van een adviesgesprek. Laat hem weg bij nieuwsbriefinschrijvingen en contentdownloads. Daar vullen vooral lezers hem in, kopers zitten er nauwelijks tussen, en je voegt frictie toe aan een stap die vijf seconden hoort te duren.
Op het formulier zelf zetten wij het veld als laatste, net boven de verzendknop. Op dat moment heeft iemand zijn naam en zakelijke e-mailadres al ingevuld en besloten het formulier te versturen, dus één kort extra veld houdt hem zelden tegen. Stuurt je demoformulier door naar een planningstool, controleer dan of de vraag die overdracht overleeft. Sommige boekingspagina's laten eigen velden vallen, tenzij je ze daar ook toevoegt.
Leg de trackingdata vast in dezelfde verzending. Met verborgen velden voor de UTM-parameters en de landingspagina staan de versie van de software en de versie van de koper op hetzelfde record. De vergelijking is later dan een kwestie van filteren, in plaats van records aan elkaar koppelen.
Is een tweede vraag de moeite waard?
Soms, al hoort hij zelden op het formulier. "Welk stuk content hielp het meest tijdens je onderzoek?" scheidt het kanaal van de boodschap. Weten dat iemand via een podcast kwam, is nuttig. Weten welke aflevering hem overtuigde, vertelt je waar je meer van moet maken. Dat is direct bewijs van welke stukken thought leadership gewicht hebben.
"Wie is er nog meer betrokken bij de beslissing?" gaat nog een stap verder, omdat de meeste deals worden beslist door een buying committee waarvan de andere leden je elk op hun eigen manier vonden. Beide vragen passen beter op de bedankpagina als optionele velden, of in het eerste gesprek, waar een rep ze vanzelf kan stellen. Voor attributie houdt het demoformulier het bij één vraag.
Antwoorden in vrije tekst coderen tot iets wat je kunt tellen
Ruwe antwoorden kun je niet in een grafiek zetten. Ze hebben een code nodig, en die code moet op een plek staan waar de ruwe tekst niet overschreven kan worden. Gebruik minstens twee properties. In HubSpot-termen slaat een property voor meerregelige tekst een alinea of een lijst met items op, en daarin bewaar je onaangeroerd wat de koper intypte. Een dropdown-property, die maar één waarde toestaat, bevat de categorie die jij toekent. Een derde veld van één regel bewaart de specifieke naam: welke podcast, welke community, het bedrijf van welke collega.
De categorieën horen een vaste lijst te zijn, één keer afgesproken en zelden aangepast. Acht tot twaalf categorieën is genoeg voor de meeste B2B-bedrijven. Een gangbare set ziet er zo uit:
Aanbeveling van een collega of vakgenoot
Podcast
Community (Slack-groepen, Reddit, besloten LinkedIn-groepen)
LinkedIn-posts van een persoon, meestal de founder
Zoekmachine
AI-assistent
Event of webinar
Reviewsite
Outbound-e-mail of -bericht van jou
Partner of bestaande klant
Onduidelijk of leeg
Een paar regels houden het coderen consistent. Noemt een koper twee bronnen, codeer dan de eerste die hij noemt, omdat dat bij de vraag past, en zet de tweede in het detailveld. "Google" gaat naar zoekmachine. Noteer wel in het detailveld of hij op je naam zocht, want een branded search betekent dat iets eerder in het traject hem naar je toe stuurde. Groeit "Onduidelijk" voorbij ongeveer één op de zeven antwoorden, herformuleer dan de vraag in plaats van categorieën toe te voegen.
Eén persoon hoort eigenaar te zijn van het coderen en doet het wekelijks, zolang de antwoorden vers genoeg zijn om een rep ernaar te vragen. Een taalmodel kan per antwoord een code voorstellen, en daar is het goed in. Geef het wel de vaste lijst en verder niets, en laat een mens een steekproef controleren. Voeg je later een categorie toe, codeer de oude antwoorden dan opnieuw, anders kun je dit kwartaal niet met het vorige vergelijken.
Wat negentig dagen aan antwoorden een softwarebedrijf in Eindhoven lieten zien
Stel je een bedrijf in HR-software in Eindhoven voor dat 120 demo-aanvragen uit één kwartaal codeert. De antwoorden van de kopers kwamen uit op 30 podcast, 26 collega of vakgenoot, 22 zoekmachine, 18 LinkedIn-posts, 10 community, 6 events en 8 onduidelijk. Samen is dat 120.
Volgens de Original Traffic Source van HubSpot waren dezelfde 120 contacten 51 keer direct verkeer, 38 keer organisch zoeken, 14 keer betaald zoeken, 11 keer organische social en 6 keer een referral. Ook 120. Geen enkel contact werd aan de podcast toegeschreven, omdat een podcast geen referral doorgeeft.
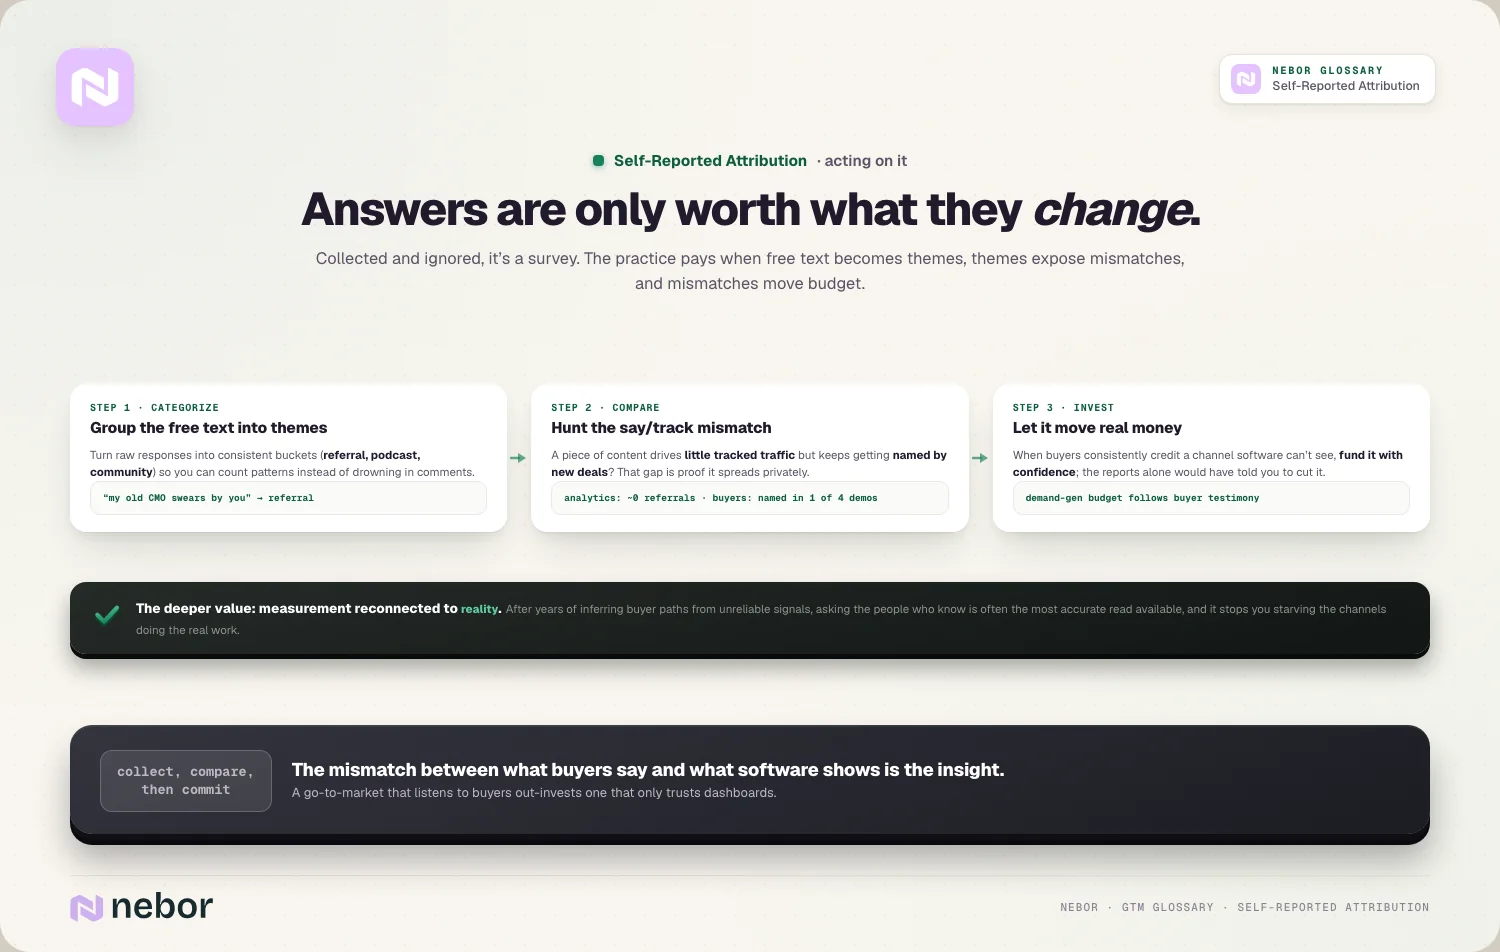
Toch noemde één op de vier demo-aanvragen hem. De podcastsponsoring stond op de lijst met bezuinigingen, omdat het dashboard er niets uit zag komen. Met de gecodeerde antwoorden naast de getrackte werd het de makkelijkste verlenging van het jaar. Daar dient de data vooral voor: werk aan demand generation vinden dat zich terugbetaalt zonder een klik achter te laten, en het budget voor demand creation daarachter verdedigen.
Self-reported attribution rapporteren naast attributie via software
Bouw geen apart dashboard voor self-reported attribution. Zet beide antwoorden in dezelfde rij. Voor elke nieuwe opportunity toont het rapport de getrackte oorspronkelijke bron, de gecodeerde self-reported categorie, het detailveld en het dealbedrag. Bouw daarna één weergave die telt bij hoeveel opportunities de twee overeenkomen en bij hoeveel niet.
Weeg naar pipeline in euro's in plaats van naar het aantal leads. Tien demo-aanvragen van studenten die je in een podcast hoorden, wegen minder zwaar dan drie van bedrijven in je ideale segment die via een vakgenoot over je hoorden, en een telling behandelt ze als gelijk.
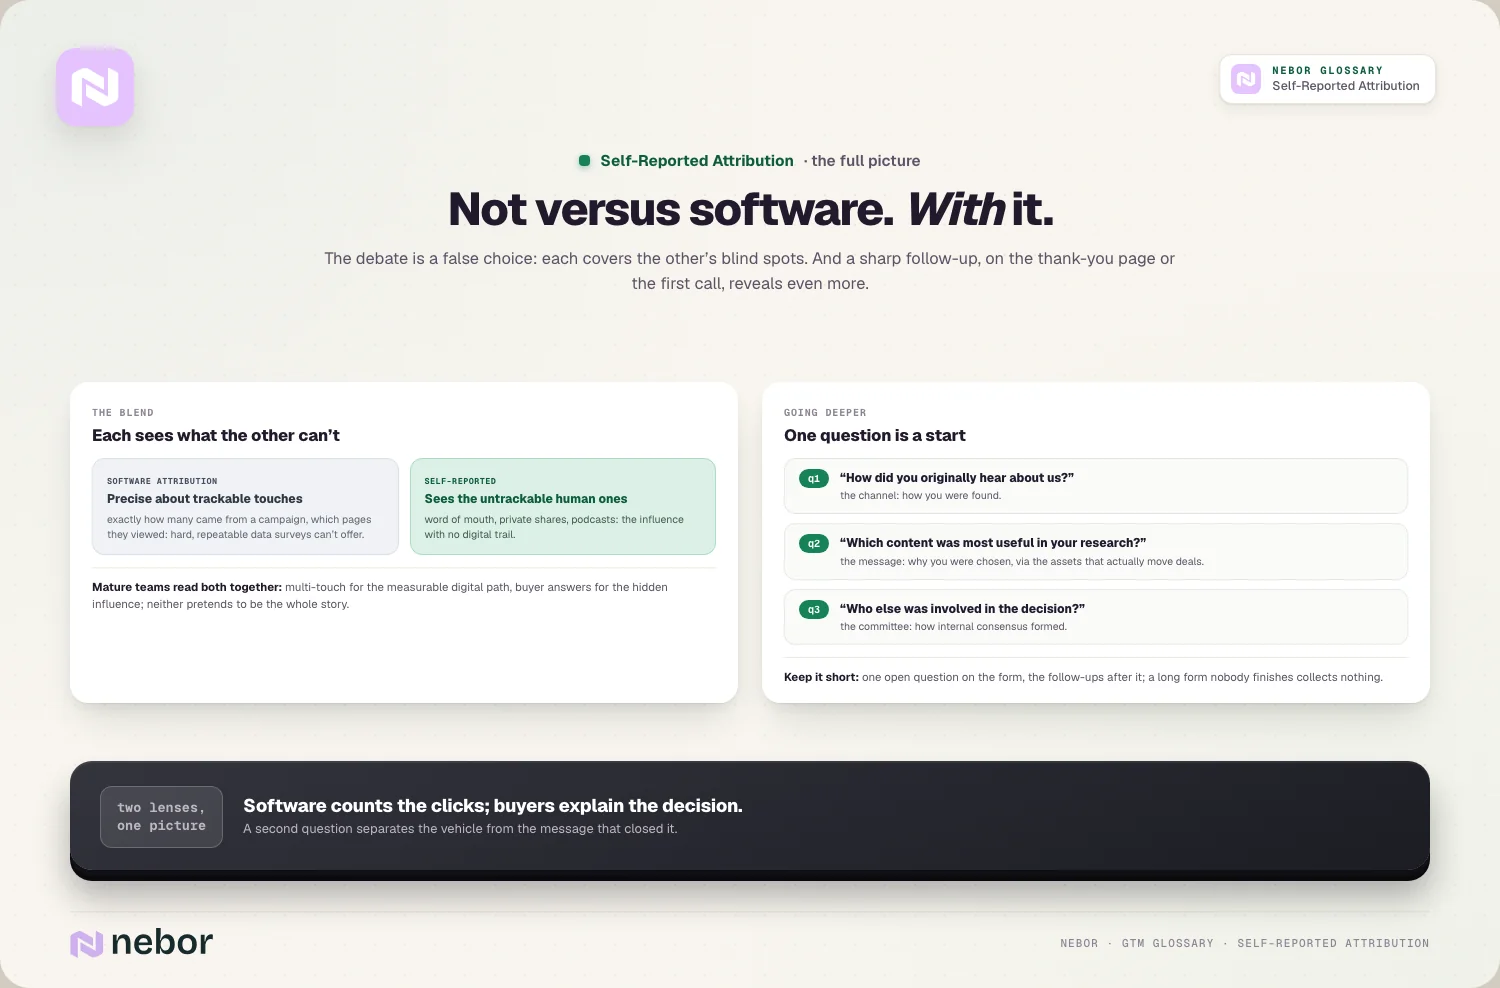
Elke bron heeft zijn eigen taak. Attributie via software blijft het juiste instrument voor beslissingen over traceerbare uitgaven: welke advertentieset, welke landingspagina, welke retargetingdoelgroep. Multi-touch attribution verdeelt de credit met echte precisie over die vastgelegde contactmomenten. Het antwoord van de koper is het juiste instrument voor kanalen die nooit een klik opleveren. Een revenue operations-team dat de twee naast elkaar leest, heeft een veel sterker verhaal dan elk kamp in zijn eentje.
Zonder controle verwateren de taggingregels. Daarom nemen wij de opzet van de properties en het wekelijkse coderen op in een workflow voor schone revenue-attributie, in plaats van het als eenmalig project te laten liggen.
Recency bias, en waarom één antwoord niets bewijst
Het meetinstrument is hier het menselijk geheugen, en dat buigt mee. Kopers noemen het contactmoment dat ze het best onthouden, en dat is vaak het meest recente of het opvallendste, eerder dan het eerste. Sommigen noemen een kanaal omdat het respectabel klinkt. Een paar weten het echt niet meer en zeggen dat ook. Dat is een eerlijk antwoord, en het wordt gecodeerd als onduidelijk.
De formulering met "voor het eerst" haalt een deel van die bias al bij de bron weg. De rest los je op met volume. Bij tien antwoorden overheersen individuele eigenaardigheden, en zie je makkelijk een patroon in ruis. Rond de honderd komen dezelfde thema's terug in deals die niets met elkaar te maken hebben. Vanaf een stuk of vijfhonderd heb je een trend waar je een budget op kunt bouwen.
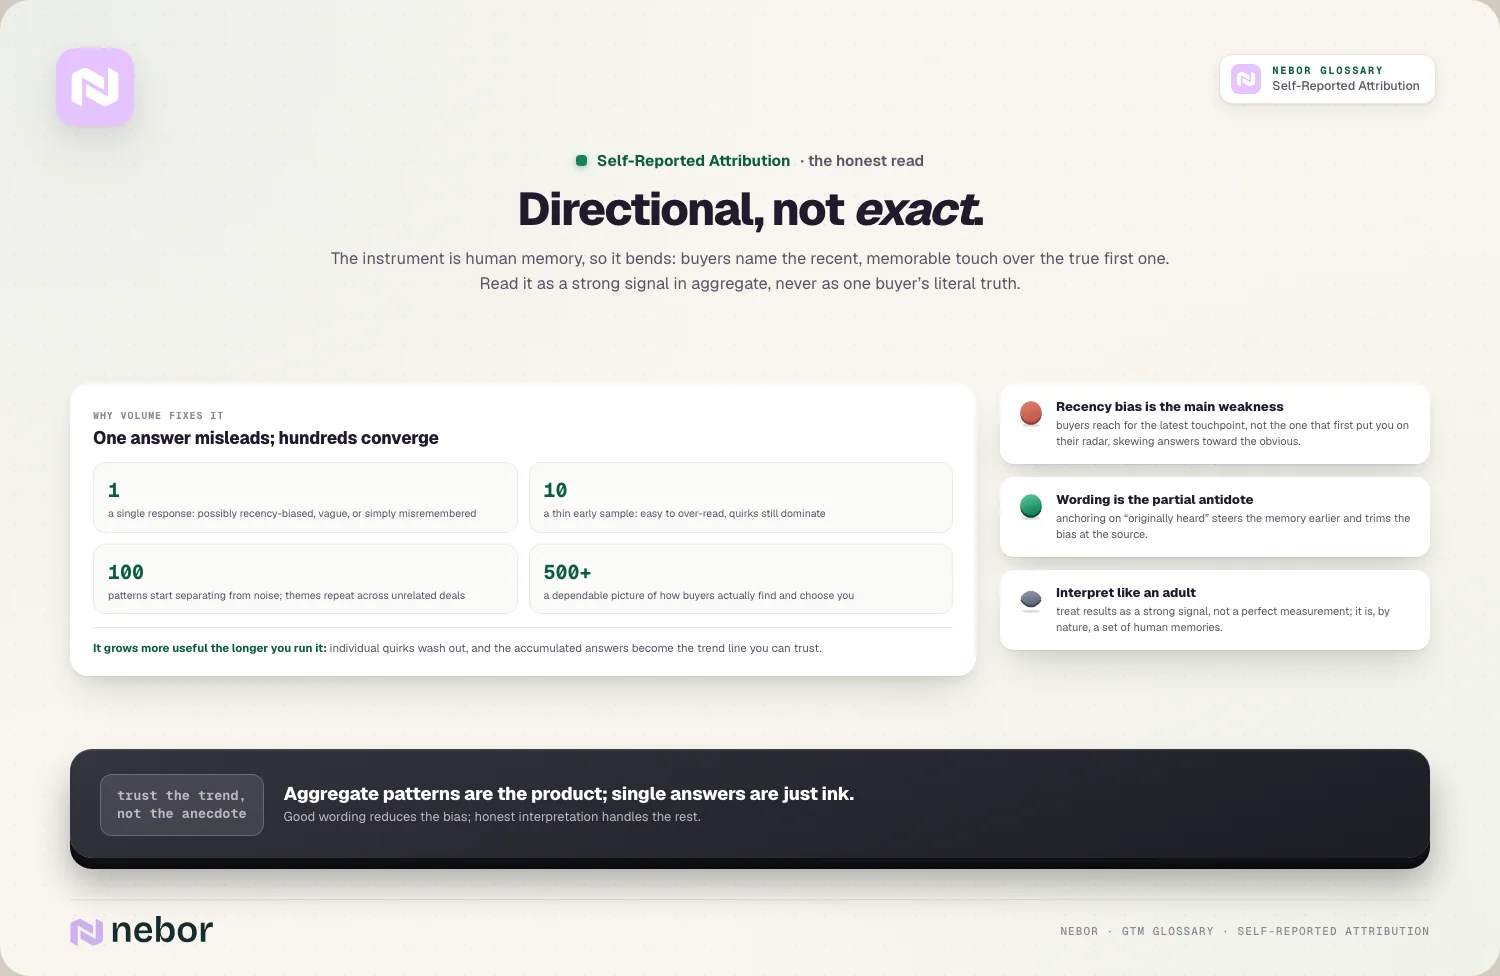
Daarom wordt de data ook nuttiger naarmate je langer meet. Een klein bedrijf met twintig demo-aanvragen per kwartaal heeft een jaar of langer nodig voordat de categorieën veel zeggen, en moet de neiging weerstaan om na de eerste maand het marketingplan om te gooien. Een rep die in het eerste gesprek dezelfde vraag stelt, voegt per deal een tweede meting toe, en kopers vertellen hardop een beter verhaal dan in een formulierveld.
Kort gezegd
Een formulierveld is zo ongeveer het goedkoopste meetinstrument dat een B2B-bedrijf kan toevoegen. Wat het de moeite waard maakt, is alles eromheen: een formulering die naar de eerste kennismaking wijst, een open veld dat de koper geen woorden in de mond legt, een vast codeboek en een rapport dat voor elke opportunity de versie van de koper naast die van de software zet.
Per deal beslechten de antwoorden geen discussies. In bulk gelezen over een paar kwartalen laten ze zien welke kanalen buiten beeld het overtuigingswerk doen, en geven ze marketing bewijs voor uitgaven die een klikrapport zou schrappen. Van alle rapporten in een revenue-setup die als één verbonden systeem draait, is dit een van de weinige die rechtstreeks van de koper komt.
Het voedt ook outbound. Zodra je weet welke podcasts en communities je beste klanten vertrouwden, kunnen de accountlijsten achter je geautomatiseerde prospecting beginnen bij de mensen die daarnaar luisteren.
Nebor voegt het veld, de properties voor het coderen en het rapport met beide versies naast elkaar toe aan de HubSpot- of Salesforce-omgeving van de klant, en laat het codeboek en de wekelijkse routine daarna achter bij degene in het team van de klant die het draaiende houdt.
Veelgestelde vragen
Moet het veld "Hoe heb je voor het eerst over ons gehoord?" verplicht of optioneel zijn?
Maak het verplicht op formulieren voor een demo of contact met sales. Optionele open vragen worden vaak overgeslagen, en de mensen die ze overslaan vormen geen willekeurige steekproef, dus een optioneel veld geeft je een scheef beeld. Houd de drempel liever laag: één kort tekstvak, een hint dat een paar woorden genoeg is, en het veld als laatste, als iemand al heeft besloten het formulier te versturen.
Kan AI antwoorden voor self-reported attribution categoriseren?
Ja, en het kan goed overweg met rommelige vrije tekst. Geef het model je vaste lijst met categorieën en laat het alleen uit die lijst kiezen, plus een optie onduidelijk voor antwoorden die het niet kan plaatsen. Laat elke week een mens een steekproef controleren, vooral bij nieuwe soorten antwoorden. Een model duwt een onbekende podcast of community namelijk zonder aarzelen in de dichtstbijzijnde categorie, en meldt dat niet.
Wat doe je met antwoorden als "Google" of "LinkedIn"?
Codeer ze, en behandel ze als onvolledig. "Google" betekent meestal dat de koper naar je zocht, en dan is de vraag waardoor hij ging zoeken. "LinkedIn" kan een advertentie zijn, een post van de founder of een bericht van een rep. Leg vast wat je kunt in een detailveld, en laat de rep in het eerste gesprek één vervolgvraag stellen. Is na verloop van tijd een groot deel van de antwoorden vaag, dan is dat een teken om de vraag anders te formuleren.
Werkt self-reported attribution voor meetings die uit outbound komen?
Gedeeltelijk. Prospects die een meeting boeken na een cold e-mail antwoorden vaak "jullie mailden me". Dat klopt, alleen weet je dan nog steeds niet waarom ze deze keer reageerden. Die meetings slaan bovendien het demoformulier over, dus de vraag moet naar het eerste gesprek. Vraag of ze je naam vóór de e-mail al eens waren tegengekomen. Reps horen dan vaak over een podcast of een collega, en dan weet je dat de outbound landde bij iemand die al warm was.
Wat is hybride attributie?
Hybride attributie betekent dat je attributie via software en self-reported antwoorden in één rapport combineert, in plaats van tussen de twee te kiezen. Getrackte contactmomenten laten zien welke kliks, advertenties en pagina's aan een conversie voorafgingen, en het antwoord van de koper laat invloeden zien die nooit een klik opleverden, zoals vakgenoten, podcasts en communities. De waarde zit in het vergelijken van de twee voor dezelfde opportunities, en in goed kijken waar ze elkaar tegenspreken.
Welke kanalen telt self-reported attribution meestal te laag?
Alles wat kopers zich niet bewust herinneren. Display- en retargetingadvertenties, een vroeg webinar dat ze half bekeken of een vergelijkingspagina die ze een jaar geleden doorbladerden, worden zelden genoemd, ook als ze hielpen. Kopers noemen ook liever bronnen die verstandig klinken, zoals een zoekopdracht of een aanbeveling. Daarom horen de antwoorden naast getrackte data te staan, want die vangt precies de contactmomenten op die mensen vergeten en software wel vastlegt.
Moet je de vraag ook stellen bij de onboarding of nadat een deal is gesloten?
Dat kan helpen, als je het als een aparte meting behandelt. Tegen de tijd dat een deal sluit, hebben kopers je salesteam gesproken, voorstellen gelezen en calls uitgezeten, dus hun herinnering aan hoe het begon is overschreven door recente contactmomenten. Een antwoord na de verkoop zegt meer over waarom ze voor je kozen dan over hoe ze je vonden. Bewaar het in een eigen property, zodat het de data uit je formulieren niet vertroebelt.
Wat is het verschil tussen self-reported attribution en een veld voor de leadbron?
Een leadbronveld is meestal een keuzelijst die een systeem of een rep invult, en beschrijft hoe het record in het CRM terechtkwam: webformulier, lijstimport, event, referral. Self-reported attribution legt het eigen verhaal van de koper vast over hoe hij voor het eerst over je hoorde, in zijn eigen woorden. De twee spreken elkaar vaak tegen. Een lead uit een webformulier kan best begonnen zijn met een aanbeveling die het formulier nooit heeft vastgelegd.
Heeft self-reported attribution zin als je maar een paar leads per maand hebt?
Ja, zolang je de verwachtingen goed zet. Met een handvol demo-aanvragen per maand schommelen de gecodeerde totalen flink van maand tot maand, dus baseer er in het begin geen budgetbeslissingen op. De ruwe antwoorden zijn vanaf dag één waardevol, omdat elk antwoord een koper is die je in gewone woorden vertelt wat hem bij je bracht. Dat verrast het team vaak.
Deel dit bericht
Marketing
Analytics
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen

Klaar om je pipeline te bouwen