In this post:
Data normalization is het standaardiseren van de waarden in je datavelden, zodat invoer die hetzelfde betekent ook op dezelfde manier wordt opgeslagen. "VP of Sales", "Vice President, Sales" en "VP - Sales" worden één waarde, en "USA", "U.S." en "United States" worden één land.
Een mens leest die varianten als identiek. Je CRM niet. Dat vergelijkt tekst teken voor teken, dus een filter op sales-VP's dat de eerste schrijfwijze vindt, slaat de andere twee over en laat nergens zien dat er iemand ontbreekt. De lijst ziet er compleet uit, de campagne gaat de deur uit, en een derde van de mensen die je wilde bereiken, krijgt hem nooit.
De meeste CRM's die we openen, hebben dit probleem in hetzelfde handjevol velden, en bijna niets ervan komt door slordigheid. Het komt door formulieren, imports, enrichment-tools en integraties die elk op hun eigen manier waarden wegschrijven, zonder dat er iets tussen zit dat bepaalt welke versie wint.
TL;DR
In een studieboek over databases betekent normalisatie dat je tabellen opsplitst in normaalvormen om redundantie weg te halen. In een CRM betekent het dat elke waarde in een veld één afgesproken format volgt, en daar gaat dit artikel over.
Vier velden veroorzaken de meeste problemen: functietitels, landen, bedrijfsnamen en keuzelijsten zoals branche of leadbron. Telefoonnummers en datums volgen op korte afstand.
Niet-genormaliseerde waarden breken segmenten, routingregels, scoring en rapporten zonder enige foutmelding, omdat elke regel alleen de exacte tekst vindt waarvoor hij is geschreven.
Normaliseer voordat je ontdubbelt en voordat je op enrichment vertrouwt. Dubbelingen zijn niet te matchen zolang één bedrijf op vijf manieren is gespeld, en enrichment-leveranciers brengen hun eigen formats mee.
Leg de standaard per veld vast, op basis van de beslissingen die dat veld stuurt. Bewaar de oorspronkelijke waarde in een apart veld, en voeg geen onderscheid samen waar je routing of territories op leunen.
Houd het afdrijven tegen bij de invoer met keuzelijsten en validatie, en vang de rest op met automatische opmaak. In HubSpot herstellen validatieregels geen bestaande waarden en gelden ze niet voor updates vanuit workflows. Een eenmalige opschoning is in zijn eentje dus nooit genoeg.
Data normalization in een CRM, buiten de databaseles
Zoek op data normalization en de helft van de resultaten gaat over relationele databases. Daar is normalisatie een ontwerpmethode. De uitleg van Microsoft over databasenormalisatie beschrijft het als data ordenen in tabellen en relaties om redundantie en inconsistente afhankelijkheden weg te nemen, volgens regels die normaalvormen heten. Een tabel in de derde normaalvorm bevat bijvoorbeeld geen velden die niet van de sleutel afhangen.
Dat doet ertoe voor wie de database achter een CRM ontwerpt, en bijna niemand in sales- of marketing operations komt daar ooit aan. HubSpot en Salesforce hebben al bepaald hoe contacten, bedrijven en deals zich tot elkaar verhouden.
Wat GTM-teams bedoelen met data normalization, is smaller en veel praktischer. De tabellen liggen vast, en de vraag is of de waarden binnen één veld met elkaar overeenstemmen. De rest van dit artikel gaat over die tweede betekenis.
Vier velden die in bijna elk CRM afdrijven
Elk open tekstveld drijft uiteindelijk af, maar vier ervan richten de meeste schade aan, omdat teams juist daarop filteren, routeren en rapporteren.
Functietitels
Er is geen grens aan het aantal manieren waarop mensen dezelfde rol schrijven, en elke variant telt als een aparte waarde. "VP of Sales", "Vice President, Sales", "VP - Sales" en "V.P. Sales & BD" beschrijven allemaal één stoel in het buying committee.
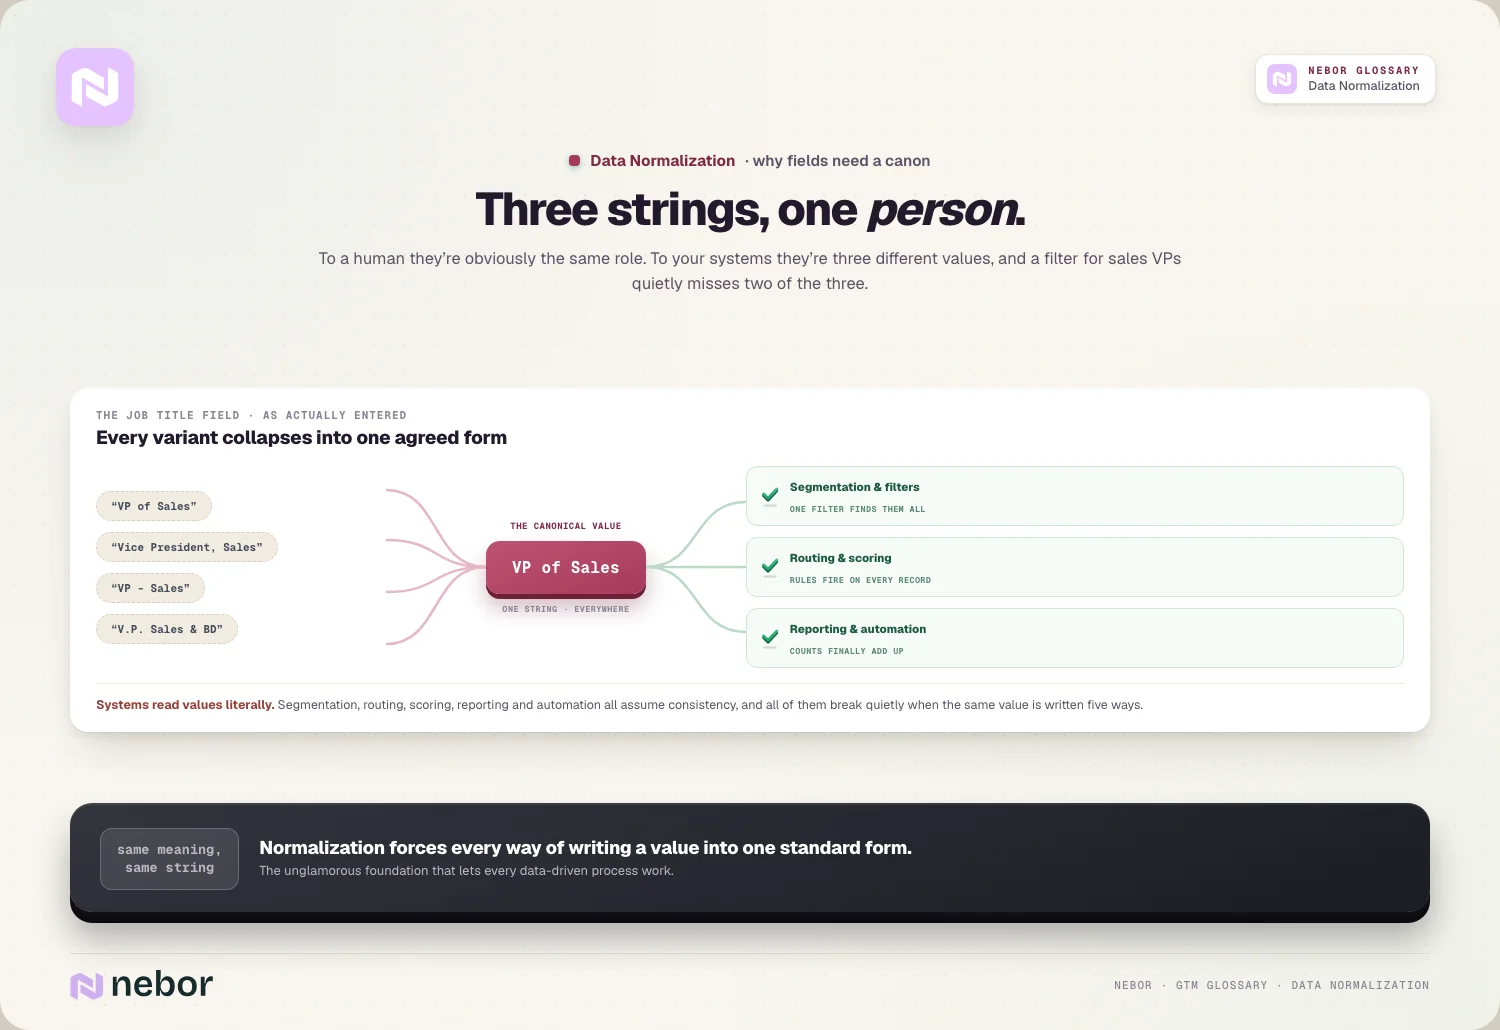
Het titelveld zelf normaliseren we niet. Iemands titel is van hemzelf, en reps zien graag de echte. We zetten er twee keuzelijstvelden naast, functie en senioriteit, en koppelen elke titel daaraan. "Head of Revenue Operations" blijft staan zoals het is geschreven en krijgt de functie RevOps en de senioriteit Head of. Segmenten en regels draaien daarna op die twee keuzelijsten, met een vaste set waarden die nooit afdrijft.
Landen en regio's
"US", "USA", "United States", "United States of America" en af en toe "Amerika" uit een Nederlands formulier komen allemaal in hetzelfde veld terecht. Kies één format en zet alles daarin om. Wij slaan op de achtergrond meestal ISO 3166-codes van twee letters op en tonen gebruikers de volledige naam, omdat integraties en enrichment-tools veel makkelijker op codes matchen. Telefoonnummers verdienen dezelfde behandeling: sla ze op in het internationale format uit het E.164-nummerplan van de ITU, met de landcode, zodat een dialer nooit hoeft te gokken.
Bedrijfsnamen
"Acme", "Acme Inc.", "ACME B.V." en "Acme, LLC" zijn voor jou één account en voor een matchingregel vier. Bepaal één keer of rechtsvormen in het veld voor de bedrijfsnaam blijven staan. Onze voorkeur: haal ze weg uit de naam die mensen zien, bewaar de statutaire naam in een eigen veld als finance die nodig heeft, en gebruik het websitedomein als de echte identificatie, omdat je dat veel moeilijker op twee manieren spelt.
Keuzelijsten die vanzelf zijn gegroeid
Keuzelijsten horen de veilige velden te zijn, en dat zijn ze ook, tot iemand opties toevoegt zonder te kijken wat er al staat. Dan bevat het brancheveld "Software", "SaaS", "Saas", "Computer Software" en "Tech", en het veld voor leadbron "LinkedIn", "Linkedin Ads" en "LI". Voeg die samen tot één lijst, zet de records over en beperk wie waarden mag toevoegen.
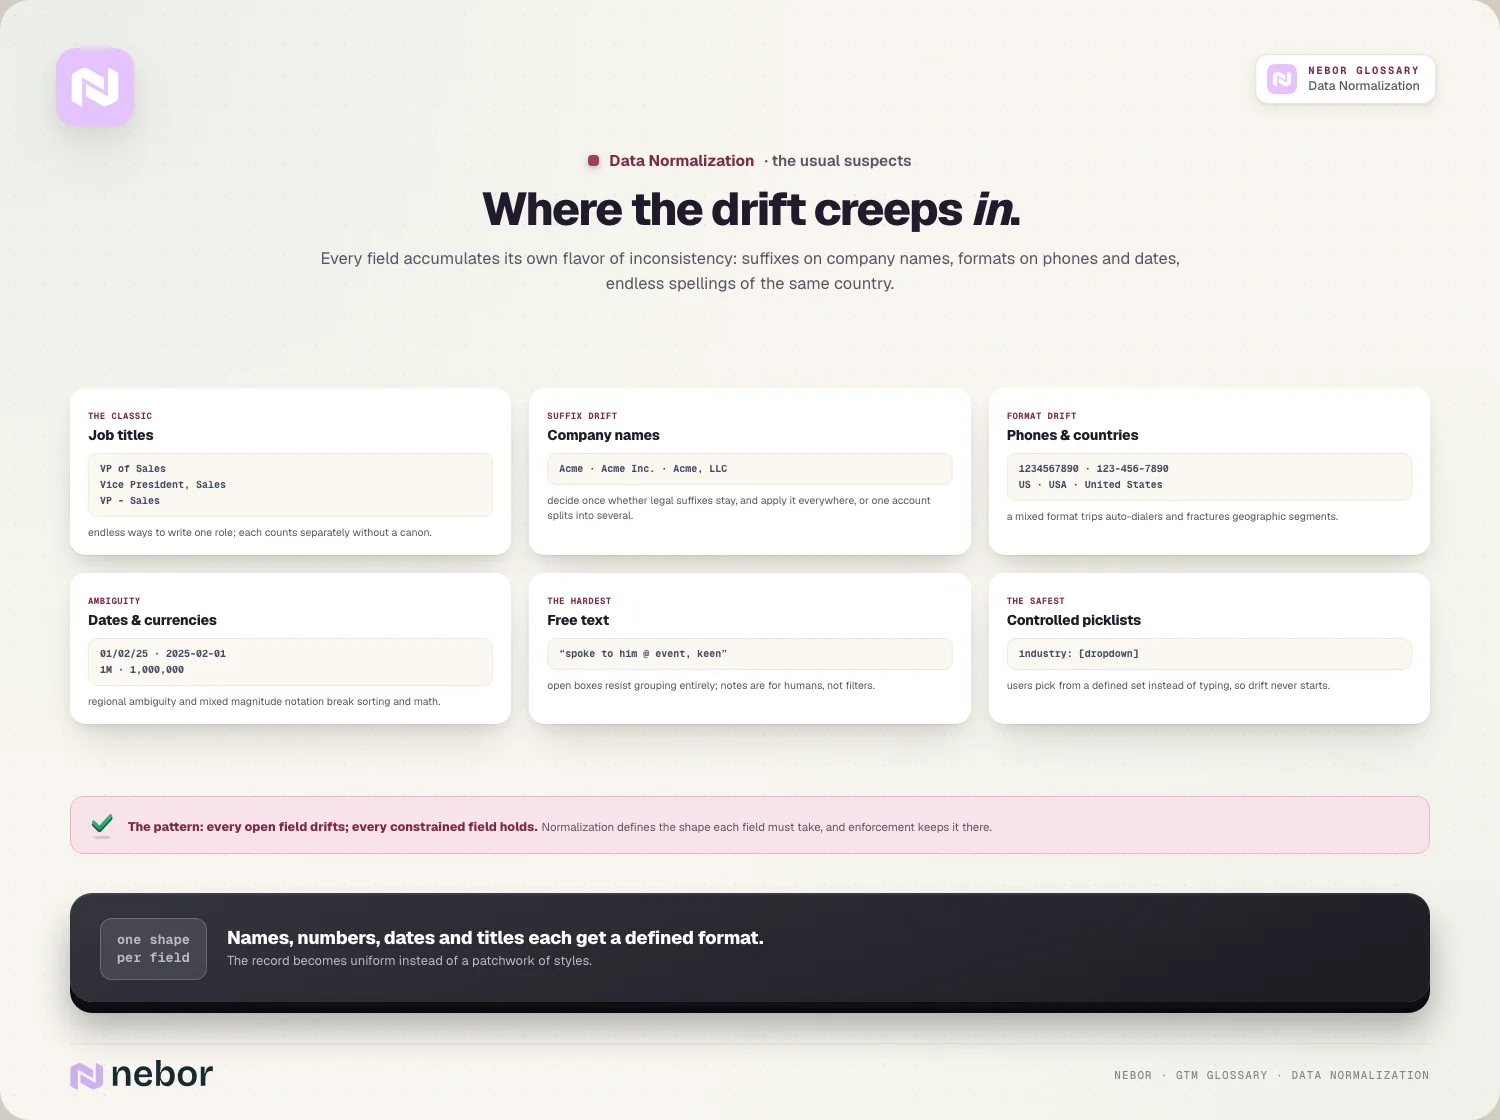
Datums en bedragen hebben ook een regel nodig. "01/02/25" betekent in het ene land januari en in het andere februari, en een omzetveld dat "1M" en "1.000.000" door elkaar gebruikt, laat zich niet sorteren. Vrije tekst is het enige veld dat je helemaal niet kunt normaliseren. Alles waarop je wilt filteren, hoort dus buiten een notitieveld te blijven.
Wat een filter niet ziet
De kosten van niet-genormaliseerde data zijn moeilijk te zien, omdat er niets luid misgaat. Elke regel doet precies wat hem is opgedragen, op precies de tekst die hij moest matchen.
Segmenten
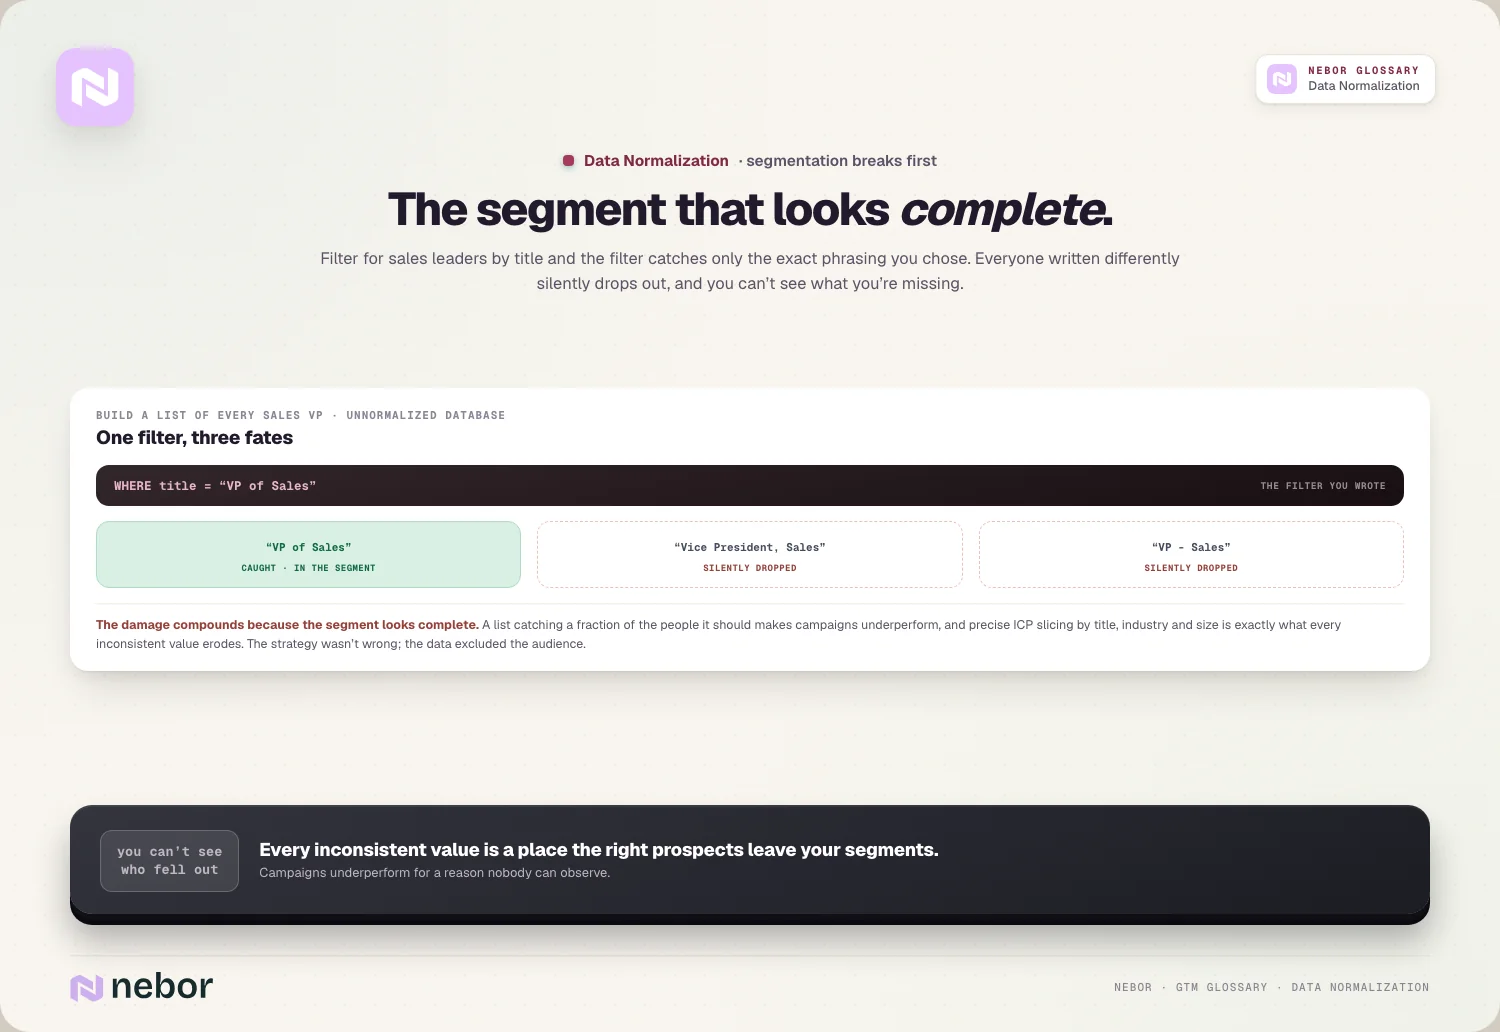
Een lijst met salesleiders die op één schrijfwijze van een functietitel is gebouwd, vangt die schrijfwijze en laat de rest vallen. Hetzelfde geldt voor een segment op branche of bedrijfsgrootte. Een scherp ideaal klantprofiel bouwen hangt ervan af dat je op die velden kunt opdelen. Elke inconsistente waarde is een plek waar accounts met een goede fit uit het segment vallen, terwijl het aantal er nog redelijk uitziet.
Routing, matching en scoring
Toewijzingsregels die Amerikaanse leads naar de ene rep sturen en Duitse leads naar een andere, werken alleen als het landveld waarden bevat die ze herkennen. Al het andere komt in een fallback-wachtrij terecht, of bij wie de vangnetregel beheert. Betrouwbare lead routing en lead-to-account matching gaan er allebei van uit dat de velden die ze lezen eerst zijn gestandaardiseerd. Voor territories geldt hetzelfde: een plan voor territory carving dat op regio of branche is getekend, valt uit elkaar als een vijfde van de accounts geen herkenbare waarde heeft.
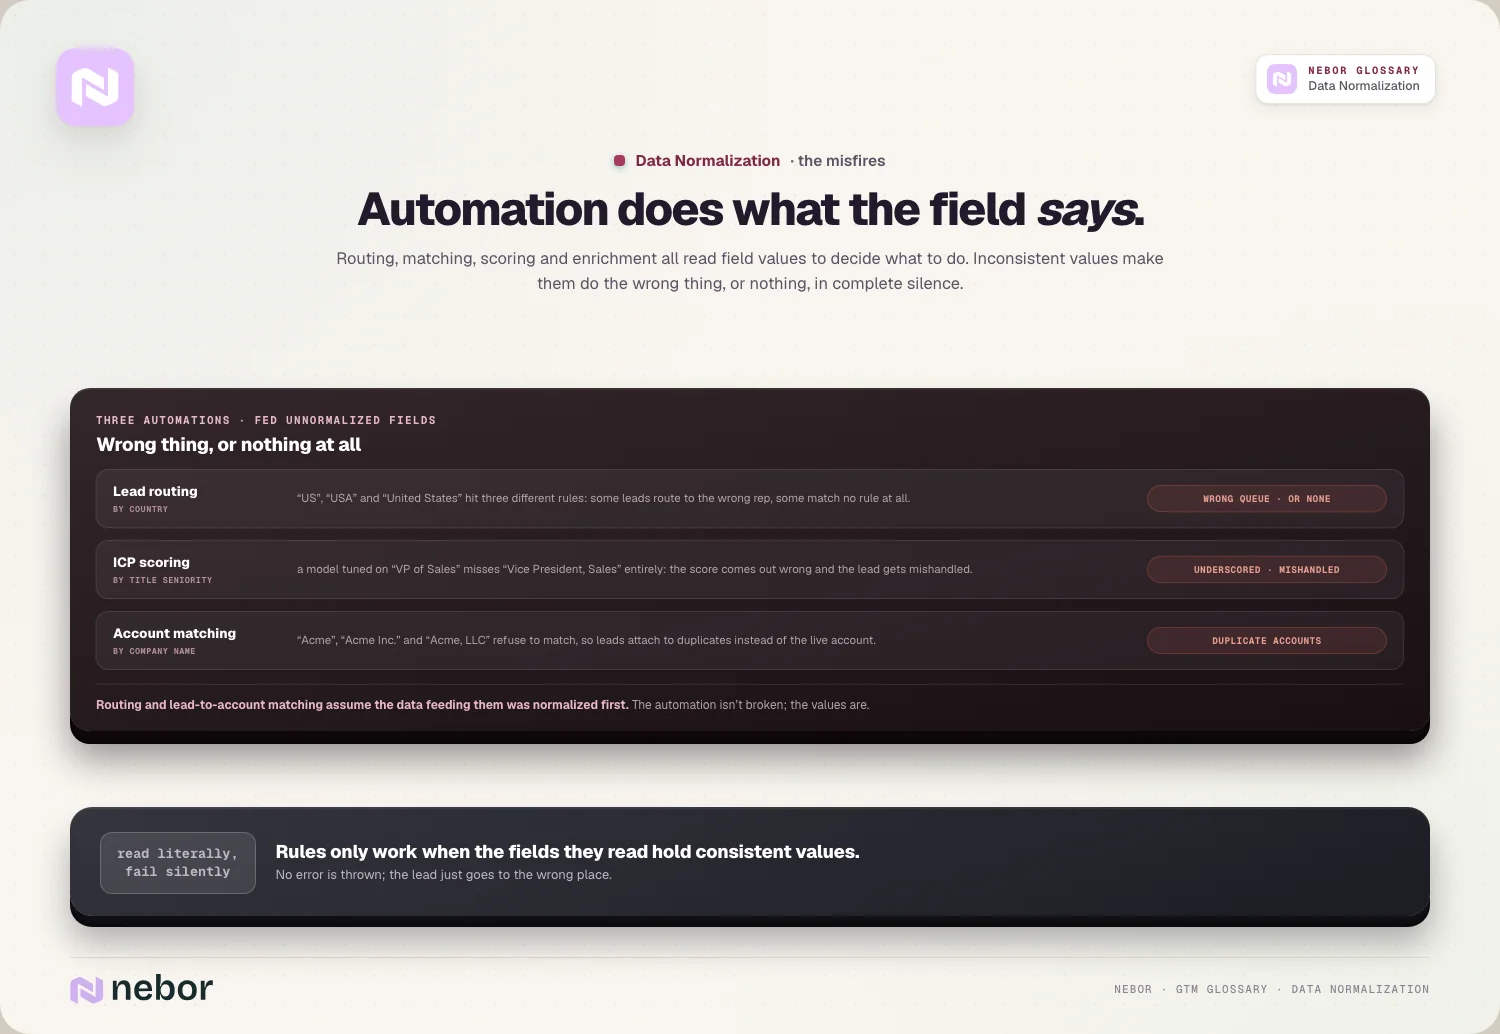
Scoring gaat op dezelfde manier stuk. Een ICP-scoringmodel dat punten geeft voor "VP of Sales", geeft er geen voor "Vice President, Sales". Een lead met een perfecte fit scoort dan laag en blijft in nurture hangen.
Rapporten en forecasts
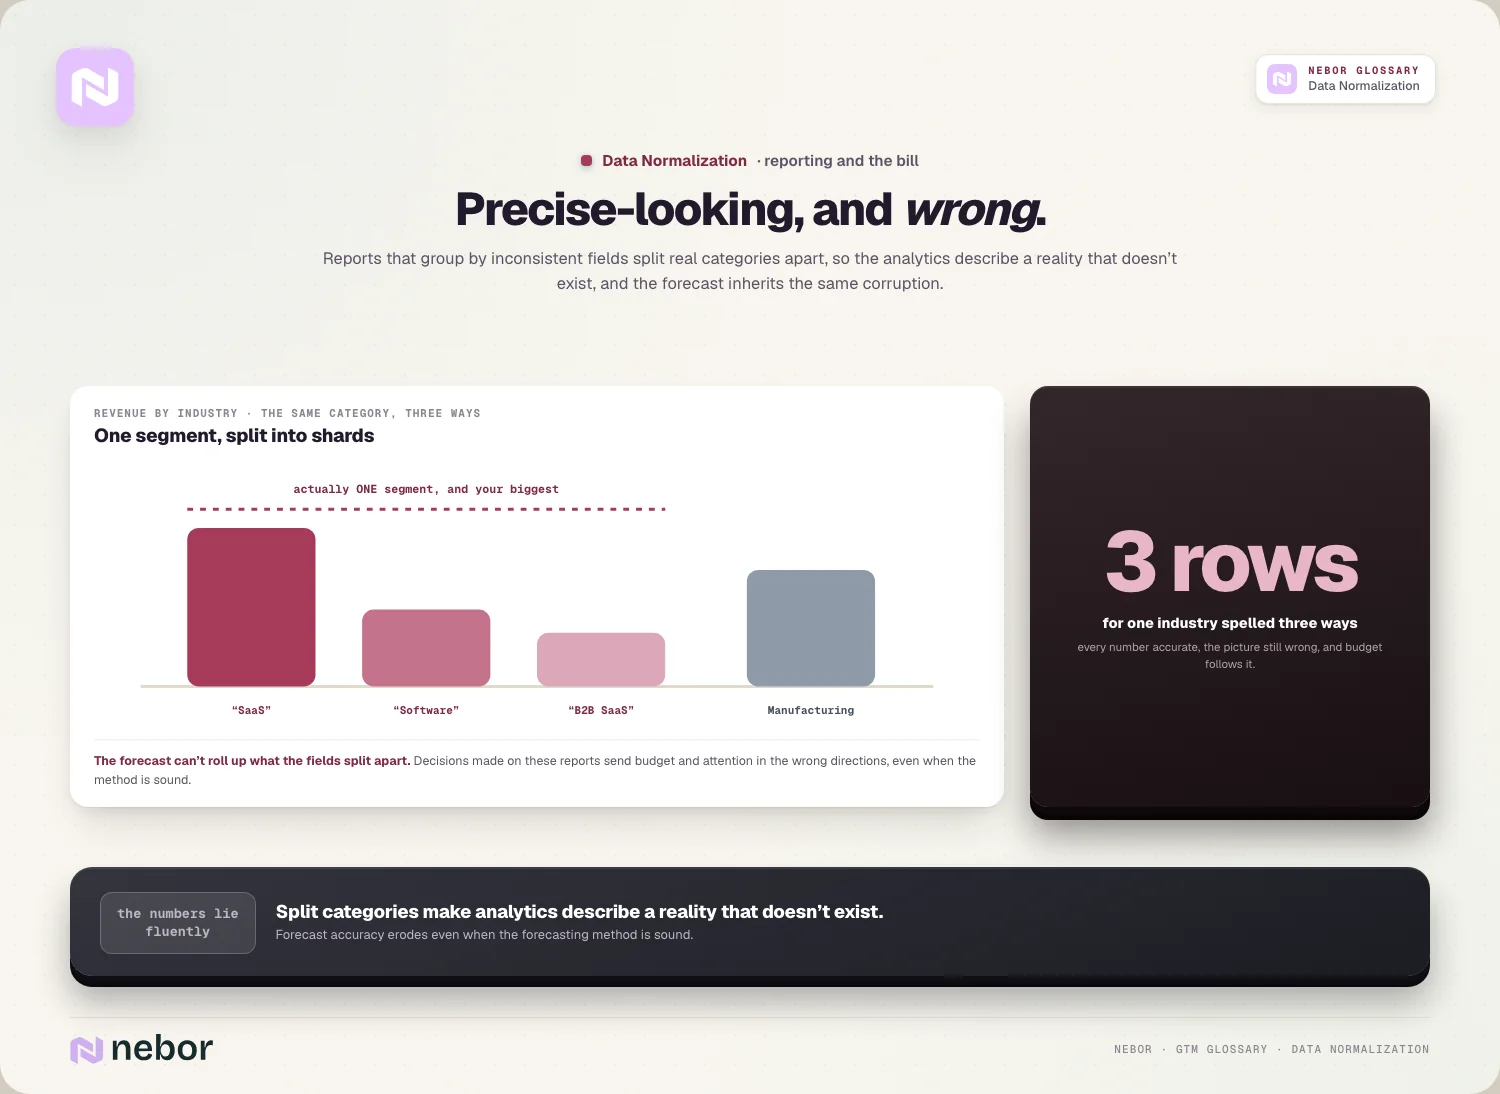
Een rapport dat op branche groepeert, toont één branche als drie rijen als het veld drie schrijfwijzen bevat, elk met een derde van de omzet. Elk getal op de pagina klopt, en toch is het beeld fout. Neem dat mee in een forecast per segment en je forecast accuracy lijdt eronder, ook als de forecastmethode prima is, omdat de categorieën eronder zijn opgesplitst.
Data normalization komt vóór ontdubbelen en enrichment
Data normalization duikt meestal op naast twee andere opschoonklussen, en de volgorde doet ertoe. Deduplicatie voegt records samen die hetzelfde bedrijf of dezelfde persoon beschrijven. Enrichment vult aan wat ontbreekt. Normalisatie zorgt dat de waarden die er al staan met elkaar overeenstemmen. Alle drie vallen onder CRM hygiene, en normalisatie moet als eerste.
Deduplicatie hangt ervan af, omdat matchingregels velden vergelijken. Twee records voor "Acme Inc." en "ACME" met hetzelfde domein worden samengevoegd. Twee records zonder domein en met een andere schrijfwijze blijven los staan, en dan jagen twee accounteigenaren op één bedrijf.
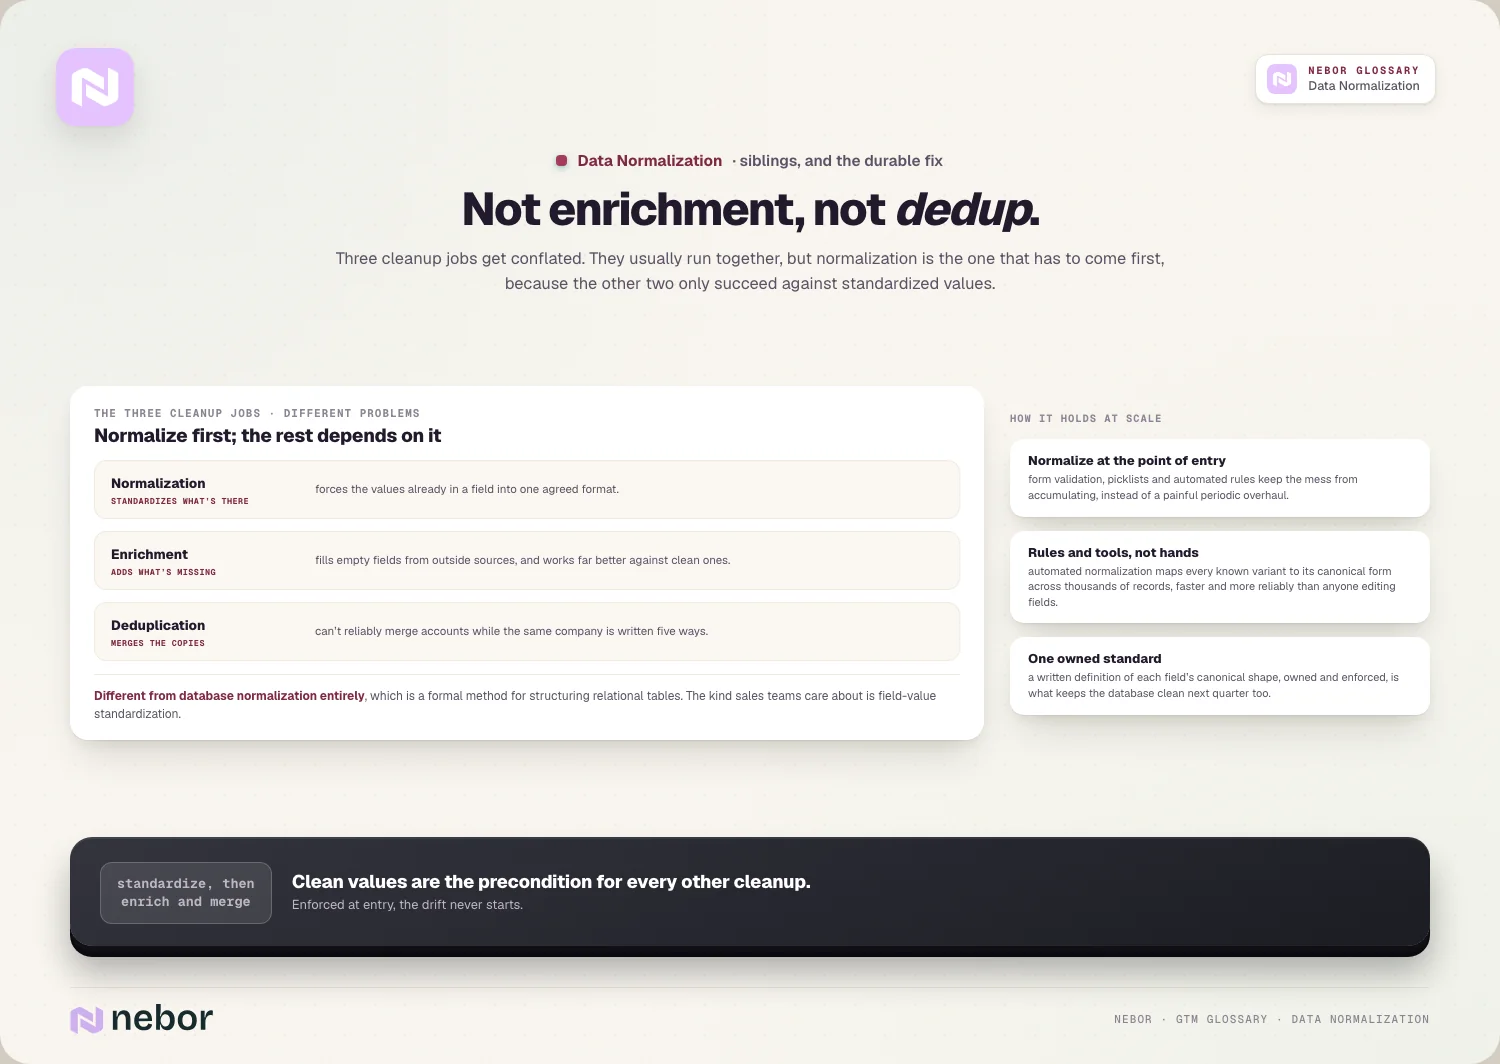
Data enrichment hangt er op twee manieren van af. Providers matchen beter op schone bedrijfsnamen en domeinen, en wat ze terugsturen, komt binnen in hun eigen format. De ene provider schrijft "United States", de andere "US", een derde geeft een senioriteitslabel terug dat met niets in je keuzelijst overeenkomt. Elk enrichment-veld dat in je CRM schrijft, heeft een koppelstap nodig tussen de waarden van de provider en die van jou. Anders wordt enrichment de grootste bron van afdrijven die je hebt.
Stap je over op een ander CRM, rond dit dan af vóór de overstap. De volgorde behandelen we in onze gids over CRM-data opschonen vóór een migratie.
De standaard per veld vastleggen
Tools passen standaarden toe. Kiezen doen ze niet, en een team dat deze stap overslaat, eindigt met twee mensen die naar twee verschillende doelen normaliseren. Wij schrijven de standaard veld voor veld uit, in deze volgorde:
Maak een lijst van de velden die een beslissing sturen. Alles wat in een filter, een routingregel, een score, een territory of een rapport wordt gebruikt. Laat de rest voorlopig met rust.
Kies de waarden door te vragen wat elke waarde beslist. Worden senior VP's anders gerouteerd dan VP's, dan kan "SVP Sales" niet opgaan in "VP Sales". Segmenteer je alleen op functie, dan kan dat wel. Het gebruik bepaalt hoeveel detail je bewaart. Netheid speelt daarbij geen rol.
Bewaar de ruwe waarde. Sla de oorspronkelijke titel of bron op in een eigen veld. Blijkt de koppeling verkeerd, dan kun je hem opnieuw doen zonder iemand te vragen iets opnieuw in te voeren.
Schrijf de koppeling uit als lijst. Een gewoonte in iemands hoofd is niet genoeg. Variant links, standaardwaarde rechts, opgeslagen op een plek waar de automatisering hem kan lezen.
Wijs een eigenaar aan. Meestal iemand in revenue operations, die bepaalt wanneer er een nieuwe waarde bij komt en wie dat te horen krijgt.
De makkelijkste manier om dit fout te doen, is te hard normaliseren. Vouw elke senior titel samen tot "Executive" en de data ziet er netjes uit, maar je hebt het verschil gewist tussen wie tekent en wie evalueert. Precies dat moet lead qualification kunnen zien. Standaardiseer de spelling en de voor de hand liggende synoniemen. Bewaar de verschillen waar mensen op handelen.
Afdrijven tegenhouden bij de invoer
Een opschoonsprint voelt een kwartaal lang goed. Daarna brengen nieuwe formulieren, imports en integraties hun eigen schrijfwijzen weer mee, en drijft de database terug naar waar hij begon. De blijvende oplossing is slechte waarden tegenhouden voordat ze worden opgeslagen, en de rest automatisch corrigeren.
De eerste laag is structuur. Maak van elk veld waarop je filtert een dropdown, want een tekstvak laat elke spelling toe. Formulieren horen dezelfde opties te bieden als de CRM-property erachter, zodat een bezoeker geen land kan typen waarvoor je geen regel hebt.
De tweede is validatie. De validatieregels voor properties in HubSpot voorkomen dat gebruikers waarden opslaan die een format breken, en ze gelden ook voor imports. Twee beperkingen zijn goed om te kennen: bestaande waarden worden niet opnieuw opgemaakt als je een regel toevoegt, en de regels gelden niet voor waarden die workflows wegschrijven. Een automatisering kan er dus nog steeds rommel langs schrijven.
De derde is automatische correctie. De workflowactie Format data van HubSpot, onderdeel van Data Hub Professional en Enterprise, kan hoofdletters aanpassen, title case toepassen of een eigen formule op een waarde loslaten en het resultaat terugschrijven. Buiten het CRM draaien we dezelfde logica in Clay of n8n voordat records erin gaan, als onderdeel van de workflow orchestration van de klant. Een taalmodel is handig om rommelige functietitels in te delen in een lijst met functies en senioriteit, zolang de lijst van jou is en het model er alleen uit kan kiezen. We laten het nooit nieuwe waarden verzinnen.
Zo wordt normalisatie van een project tot leidingwerk. Data komt in de juiste vorm binnen, zodat de geautomatiseerde sales prospecting die erop is gebouwd, de mensen bereikt voor wie hij bedoeld was.
Kort gezegd
Data normalization is eerst een beslissing en pas daarna een taak. Iemand moet afspreken hoe een land, een functie of een branche er in je CRM uitziet, dat opschrijven en er eigenaar van zijn. Daarna is het werk vooral mechanisch, en daar zijn machines goed in.
De opbrengst verschijnt zelden als aparte regel. Je ziet hem in segmenten die iedereen bevatten die erin hoort, routingregels die geen leads meer naar de fallback-wachtrij sturen, en rapporten waarin één branche ook één rij is. Een go-to-market-systeem is maar zo betrouwbaar als de waarden die zijn regels lezen, en genormaliseerde velden zorgen dat die regels betekenen wat ze zeggen.
Als we het CRM van een klant opschonen, schrijven we de veldstandaarden samen met hun team uit, bouwen we de keuzelijsten, validatie en opmaakautomatiseringen direct in dat systeem, en laten we de koppellijsten achter op een plek waar hun ops-mensen ze kunnen aanpassen nadat we alles hebben overgedragen.
Veelgestelde vragen
Wat is het verschil tussen data normalization en datastandaardisatie?
In CRM- en GTM-werk worden de twee termen bijna door elkaar gebruikt. Allebei betekenen ze dat de waarden in een veld één afgesproken format volgen. Sommige teams gebruiken standaardisatie voor opmaakregels, zoals hoofdletters of het format van telefoonnummers, en normalisatie voor het koppelen van varianten aan één waarde, zoals elke schrijfwijze van een functietitel omzetten in één functie. In databaseontwerp betekent normalisatie iets heel anders: tabellen opbouwen volgens normaalvormen.
Wat zijn de eerste, tweede en derde normaalvorm?
Het zijn regels uit het ontwerp van relationele databases. De eerste normaalvorm haalt herhalende groepen weg, zodat een tabel geen kolommen heeft als Class1, Class2 en Class3. De tweede normaalvorm verplaatst data die voor veel records geldt naar een eigen tabel, gekoppeld via een sleutel. De derde normaalvorm haalt velden weg die niet van de sleutel van de tabel afhangen. Ze bepalen hoe een database wordt gebouwd. Hoe je de waarden in een CRM-veld schrijft, valt erbuiten.
Is data normalization hetzelfde als ontdubbelen?
Nee. Ontdubbelen zoekt records die hetzelfde bedrijf of dezelfde persoon beschrijven en voegt ze samen. Normalisatie maakt de waarden binnen velden consistent, zoals één schrijfwijze van een bedrijfsnaam of één format voor een land. De twee hangen nauw samen, omdat matchingregels veldwaarden vergelijken. Dubbelingen zijn dus veel makkelijker te vinden zodra namen, domeinen en landen zijn genormaliseerd. Daarom gaat normalisatie meestal eerst.
Hoe verschilt data normalization van data enrichment?
Enrichment voegt informatie toe die een record mist, zoals bedrijfsgrootte, branche of een direct telefoonnummer, meestal van een externe dataprovider. Normalisatie verandert hoe bestaande informatie is geschreven, zodat die bij je standaard past. De twee komen samen als enrichment in je CRM schrijft, omdat elke provider waarden in zijn eigen format teruggeeft. Die waarden moet je aan je standaard koppelen voordat ze worden opgeslagen.
Overschrijf je de oorspronkelijke waarde als je een veld normaliseert?
Bij velden die mensen zelf hebben ingevuld, zoals functietitel, bewaar je het origineel en schrijf je de genormaliseerde versie naar een apart veld, zoals functie en senioriteit. Zo kun je een verkeerde koppeling later herstellen zonder informatie kwijt te raken. Bij velden die puur over opmaak gaan, zoals een land of telefoonnummer, is overschrijven meestal prima, omdat de standaardversie alles bevat wat het origineel bevatte.
Kan AI functietitels normaliseren?
Ja, en het gaat veel beter om met rommelige titels dan regels op basis van trefwoorden. De veilige aanpak: geef het model een vaste lijst met functies en senioriteitsniveaus en vraag het om voor elke titel er één van elk te kiezen, met een optie onbekend voor alles wat onduidelijk is. Controleer een steekproef voordat je resultaten naar het CRM schrijft, en laat het model nooit zelf nieuwe waarden aanmaken.
Hoort in een landveld een volledige naam of een code?
Sla het een of het ander op, en meng ze nooit in hetzelfde veld. ISO 3166-codes van twee letters, zoals US, DE en NL, zijn compact en makkelijk te matchen voor integraties. Volledige namen lezen prettiger voor mensen die records bekijken. Veel teams slaan de code op en tonen de naam. Het belangrijkste is dat formulieren, imports en enrichment allemaal hetzelfde format in het veld schrijven.
Normaliseer je data bij de import of als het al in het CRM staat?
Allebei, al telt de invoer zwaarder. Waarden koppelen tijdens een import, het verzenden van een formulier of enrichment houdt slechte data helemaal buiten de deur, en dat is goedkoper dan later opschonen. Een geplande ronde over bestaande records vangt nog steeds op wat erdoorheen glipt, zoals handmatige aanpassingen, oude imports en waarden van integraties die je validatieregels omzeilen.
Hoe normaliseer je data in HubSpot?
Zet eerst de open tekstvelden waarop je filtert om in dropdown-properties met een vaste set opties. Voeg validatieregels voor properties toe, zodat gebruikers geen waarden in het verkeerde format kunnen opslaan. Gebruik voor bestaande records en automatische updates de actie Format data in workflows, beschikbaar in Data Hub Professional en Enterprise, om hoofdletters te herstellen of een eigen formule toe te passen en het resultaat terug te schrijven.
Deel dit bericht
Data
RevOps
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen

Klaar om je pipeline te bouwen