In this post:
Waterfall enrichment is een methode die elk record in een vaste volgorde langs meerdere dataproviders stuurt. Je gaat pas naar de volgende provider als de vorige geen goede data teruggeeft. Zo combineer je de sterke punten van veel bronnen en hoef je niet te leven met de gaten van één provider.
Je merkt dat je het nodig hebt zodra je voor het eerst een lijst door één provider haalt. Zelfs de beste komt terug met een flink deel van de records leeg, fout of onvolledig, want geen enkele provider weet alles over elk bedrijf.
Providers hebben verschillende sterke punten, en dat zien we steeds weer in ons werk voor klanten. De een is goed in e-mailadressen, de ander in telefoonnummers, een derde in een bepaalde regio. Zet je ze achter elkaar, dan vang je veel meer dan een van hen alleen.
TL;DR
Elk record gaat naar je eerste provider en valt pas door naar de volgende als die provider niets vindt. Denk aan een estafette in plaats van een stemming: geen provider krijgt een record voorgelegd dat een andere al heeft opgelost.
Geen enkele provider dekt je hele lijst. De meeste extra dekking komt van de tweede en derde bron, en hoe groot de winst is, hangt af van je markt. Haal daarom een sample van je eigen lijst door beide setups en vergelijk de fill rates per veld.
Zakelijke e-mailadressen zijn de klassieke toepassing, maar directe nummers en bedrijfsdata zitten net zo vol gaten. Elk belangrijk veld krijgt dus een eigen cascade en een eigen volgorde van providers.
De kosten blijven laag, omdat de cascade stopt bij het eerste goede antwoord. Clay geeft credits terug als een provider geen e-mailadres vindt. En zet je goedkope bronnen of bronnen met een hoge hit rate vooraan, dan zien de duurdere alleen de lastige records.
Kies providers waarvan de dekking zo min mogelijk overlapt, en zie de volgorde, stopregels en vertakkingen (de enrichment waterfall logic) als het echte werk. Platforms zoals Clay maken een contract met elke bron overbodig. Zelf nadenken blijft nodig.
Contactdata blijft in beweging (de mediane diensttijd van werknemers in de VS was 4,1 jaar in januari 2026), dus draai de waterfall volgens schema opnieuw en verifieer wat hij vindt. De gebruikelijke fouten zijn een slechte volgorde, te veel providers, geen verificatie en hem maar één keer draaien.
Nebor bouwt en tunet deze cascades voor klanten in hun eigen Clay-workspace, veld voor veld. Een kort gesprek is meestal genoeg om te zien of jouw setup dekking laat liggen.
Een zakelijk e-mailadres volgen door de cascade van waterfall enrichment
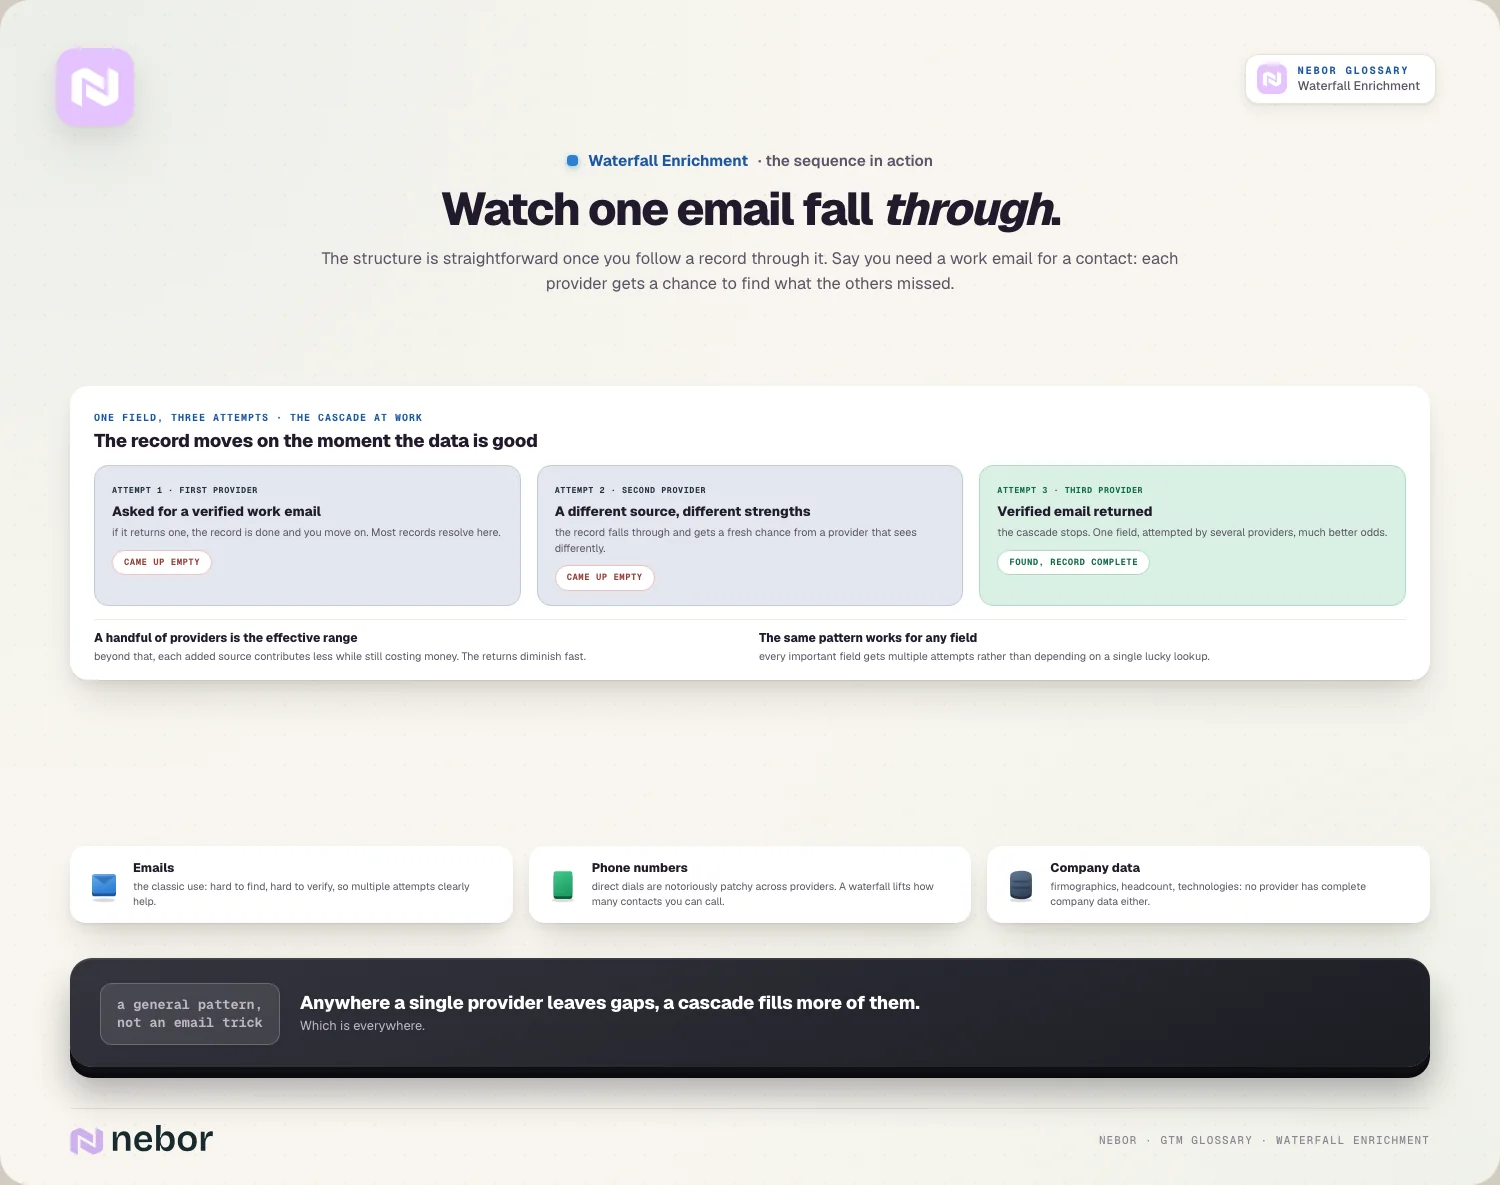
In plaats van op één bron te vertrouwen, zet je voor elk stuk data dat je nodig hebt een cascade van bronnen op. Stel dat je voor een contact een zakelijk e-mailadres mist:
De waterfall vraagt het aan je eerste provider. Geeft die een geverifieerd e-mailadres terug, dan is het record klaar en ga je door.
Vindt de eerste niets, dan valt het record door naar de tweede provider.
Het blijft doorvallen naar de derde provider en verder. Elke provider krijgt de kans te vinden wat de anderen misten, tot het e-mailadres gevonden is of elke bron is geprobeerd.
Wat er gevonden is, wordt gevalideerd voordat het in je CRM of sequencer belandt.
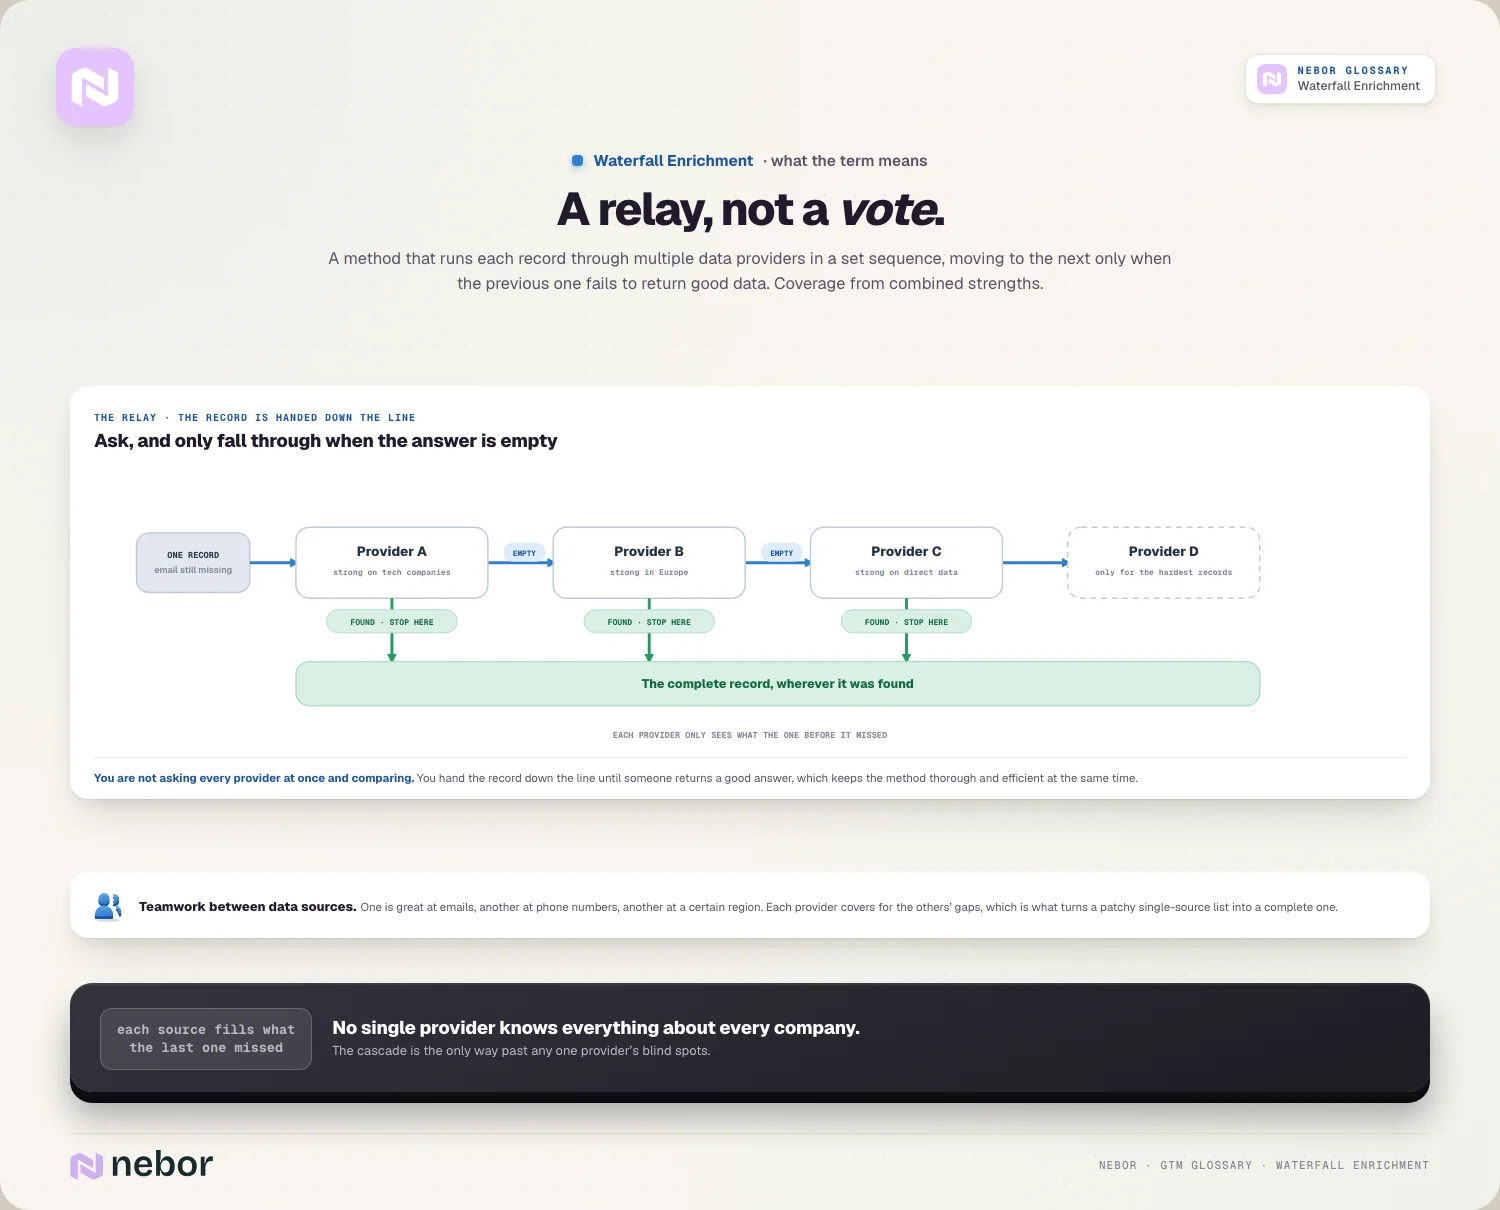
Het heet een waterfall omdat records naar beneden vallen. Een record zakt pas naar de volgende bron als de bron erboven faalt. Aan het eind hebben misschien meerdere providers een poging gedaan voor één veld, zoals een e-mailadres, en dat vergroot de kans dat je het hebt.
Denk aan een estafette in plaats van een stemming. Je vraagt niet alle providers tegelijk om de antwoorden daarna te vergelijken. Je geeft het record door tot iemand een goed antwoord geeft, en zo blijft het grondig en efficiënt.
Geen enkele provider dekt je hele lijst
Het probleem is structureel, dus een betere tool kiezen lost het nooit op. Elke provider verzamelt data op zijn eigen manier. Daardoor is elke provider sterk in sommige branches, regio's en datatypes en zwak in andere, met echte gaten overal. Haal een echte lijst door één bron en een deel van de records komt leeg of fout terug.
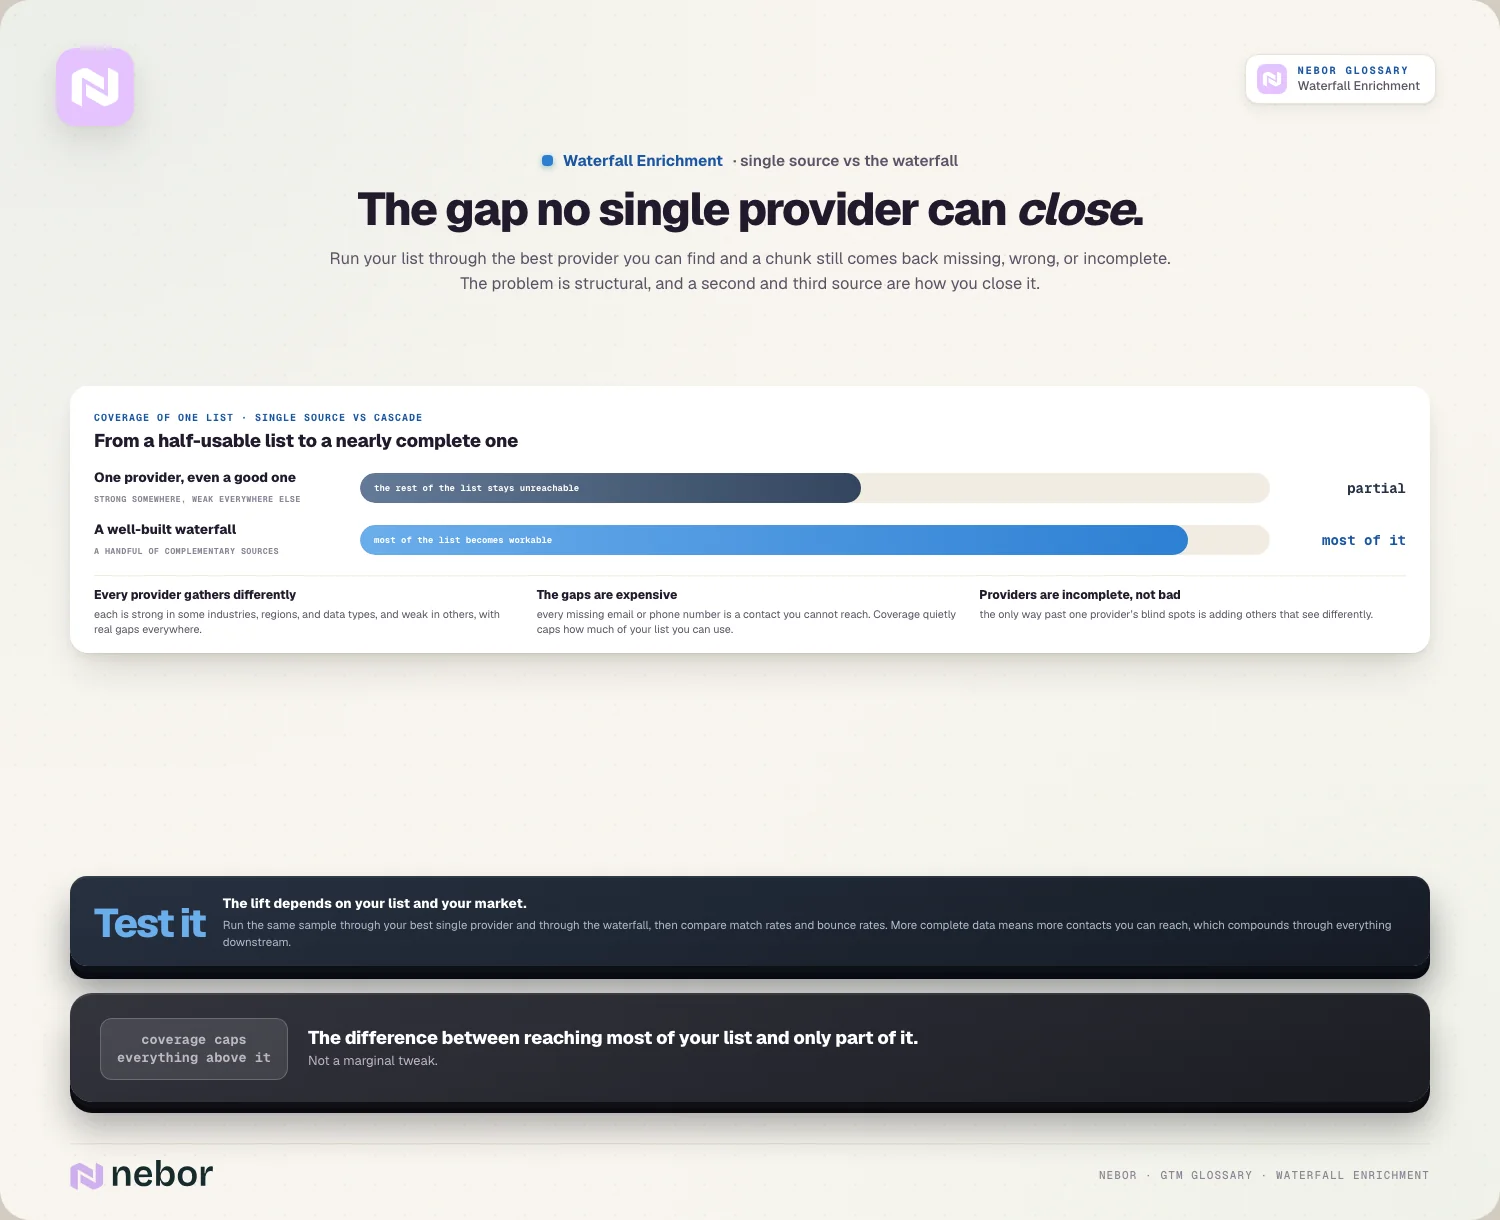
Die gaten kosten je elke week pipeline. Elk ontbrekend e-mailadres of telefoonnummer is een contact dat je niet kunt bereiken, dus dekking uit één bron zet een harde grens op hoeveel van je lijst je kunt gebruiken. Het probleem is onvolledigheid, en dat ligt zelden aan slechte providers. Je komt alleen voorbij de blinde vlekken van één provider door er andere bij te zetten die anders kijken.
Hoeveel een waterfall toevoegt, hangt af van je lijst, je markt en welke providers je koppelt, maar het patroon is steeds hetzelfde. De meeste winst komt van de tweede en derde provider, die records oppikken die de eerste miste. Daarna vindt elke extra bron minder nieuwe records, terwijl hij wel geld blijft kosten.
Aspect | Eén provider | Waterfall |
|---|---|---|
Dekking | Begrensd door wat één database bevat | Elke extra provider vult een deel van de gaten die de anderen lieten |
Blinde vlekken | Elke zwakke regio, branche of elk zwak veld blijft leeg | Bronnen met verschillende sterke punten vangen elkaar op |
Kostenbeheersing | Eén abonnement, voor elk record op dezelfde manier gebruikt | Goedkope providers of providers met een hoge hit rate gaan eerst, duurdere zien alleen de lastige records |
Setup | Eén integratie, weinig configuratie | Vraagt per veld een volgorde van providers, stopregels en validatie |
Onderhoud | Eén bron opnieuw draaien als data veroudert | De cascade opnieuw draaien en de volgorde herzien als de resultaten veranderen |
De betrouwbare manier om de winst te bepalen: haal een sample van je eigen lijst door je huidige provider en daarna door de volledige waterfall, en vergelijk de fill rates per veld. Meestal is het het verschil tussen het grootste deel van je doellijst bereiken en maar een deel ervan.
Meer dan e-mailadressen: een cascade voor elk veld
Mensen koppelen waterfall enrichment vaak aan het vinden van e-mailadressen, maar de cascade is een algemene techniek. Hij loont overal waar providers moeite hebben:
Zakelijke e-mailadressen zijn de meest voorkomende toepassing, omdat ze lastig te vinden en te verifiëren zijn. Meerdere pogingen helpen daar duidelijk.
Telefoonnummers zijn een extra sterk voorbeeld. Directe nummers zijn bij providers berucht onvolledig, dus een waterfall vergroot het aantal contacten dat je kunt bellen.
Bedrijfsdata profiteert net zo goed. Firmografische data, aantal medewerkers en technologieën worden allemaal beter met een cascade van bronnen, want ook voor bedrijfsdata heeft geen enkele provider alles.
Omdat bronnen zich specialiseren, verschilt de beste volgorde per veld. Sommige blinken uit in e-mailadressen, andere in telefoonnummers, weer andere in firmografische data. De pagina over waterfall enrichment van Clay laat dat zien, met aparte lijsten van providers voor zakelijke e-mailadressen, persoonlijke e-mailadressen en mobiele nummers. Overal waar één provider gaten laat, en dat is overal, vult een cascade van bronnen er meer van.
Waar het geld naartoe gaat
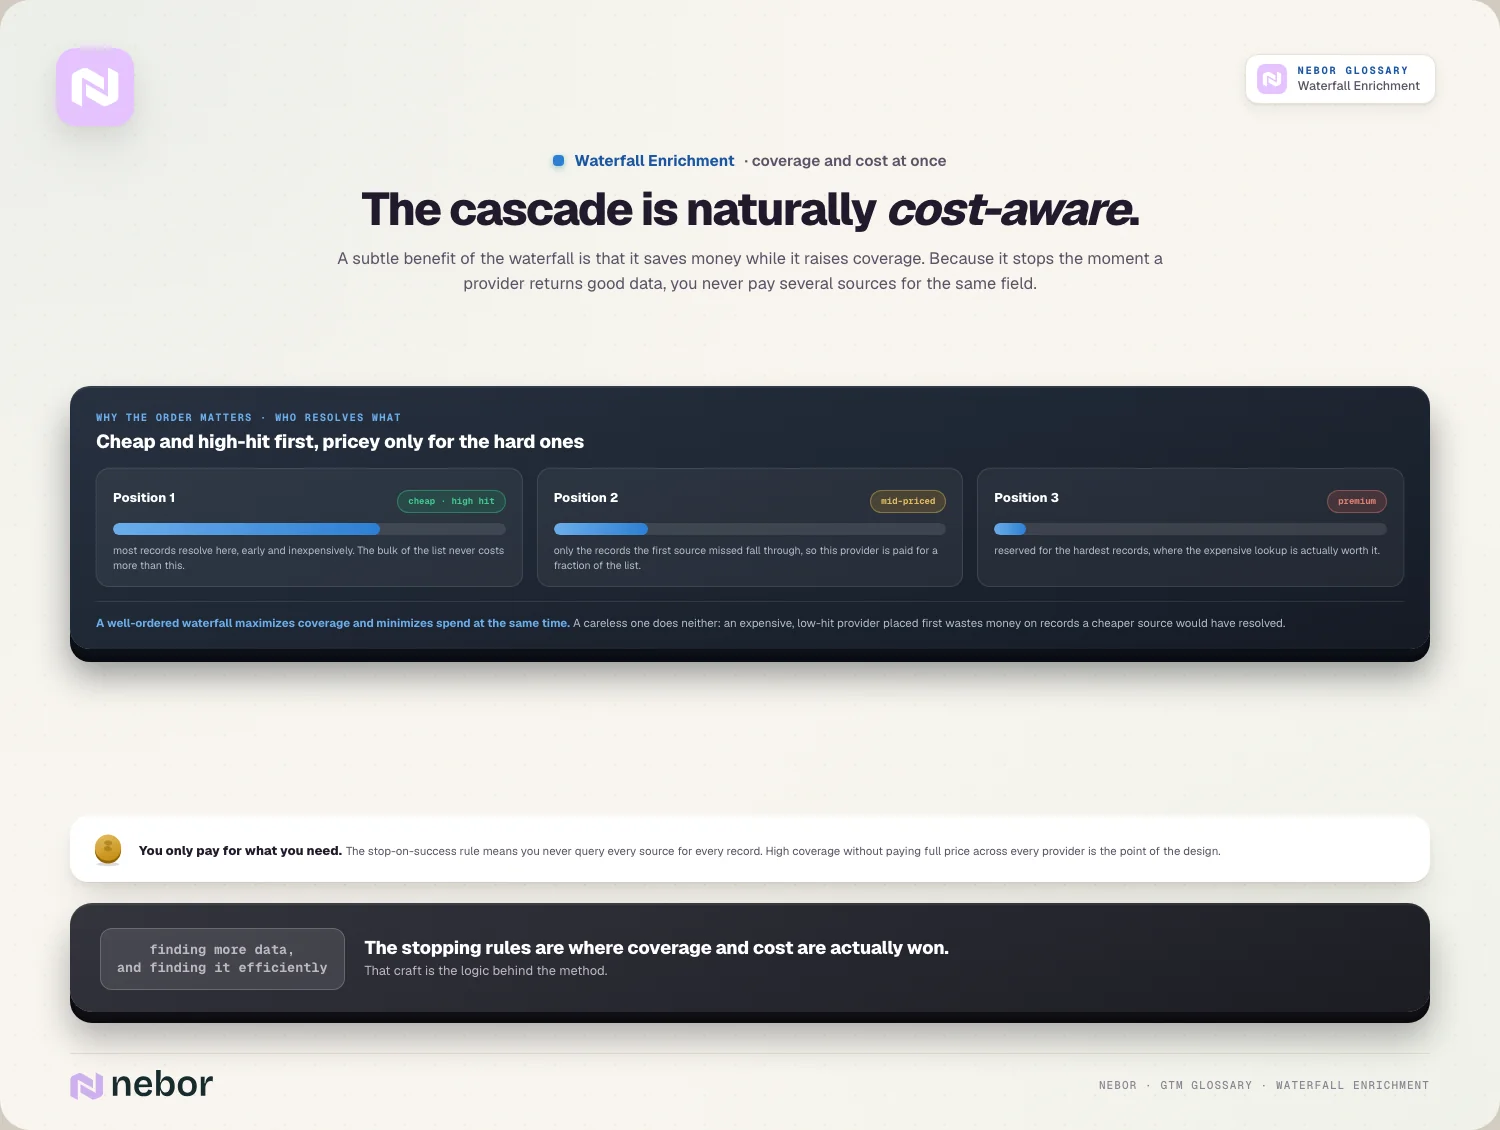
Een minder voor de hand liggend voordeel van de waterfall is dat hij geld bespaart terwijl hij de dekking verbetert. De cascade stopt zodra een provider goede data teruggeeft, dus je bevraagt niet elke bron voor elk record. Zo betaal je niet meerdere providers voor hetzelfde veld.
De e-mailwaterfall van Clay is een concreet voorbeeld. Vindt een provider een geldig e-mailadres, dan stopt het proces voor dat contact. Vindt een provider niets, dan krijg je de credits terug en gaat het record naar de volgende. Niet elke provider rekent lege lookups zo af, dus check dat voordat je een volgorde vastlegt.
Volgorde telt voor de kosten net zo zwaar als voor de dekking. Zet je een goedkopere provider of een met een hogere hit rate vooraan, dan worden de meeste records vroeg opgelost en val je alleen voor de lastige door naar duurdere bronnen. Een goed geordende waterfall haalt de hoogste dekking en houdt tegelijk de uitgaven laag. Een slordige, met een dure provider of een met een lage hit rate bovenaan, doet geen van beide.
Providers kiezen die op verschillende records falen
Waterfall enrichment en enrichment waterfall logic klinken uitwisselbaar, en ze beschrijven ook hetzelfde systeem, op twee niveaus. Waterfall enrichment is de methode: providers achter elkaar zetten om de dekking te verhogen. De logic is de configuratie die bepaalt hoe de cascade zich gedraagt, met volgorde, stopvoorwaarden en vertakkingen. Besluiten om een waterfall te draaien is makkelijk. In de logic zit het vakmanschap, want een slecht geconfigureerde waterfall verspilt geld.
De keuze van providers staat centraal in die logic. Wij streven naar dekking die zo min mogelijk overlapt. Twee providers met dezelfde sterke punten voegen weinig toe, terwijl providers die sterk zijn in verschillende regio's, branches of datatypes elk echte gaten vullen. Kies bronnen die op een nuttige manier van elkaar verschillen. Aan vergelijkbare bronnen die allemaal op dezelfde records falen, heb je weinig.
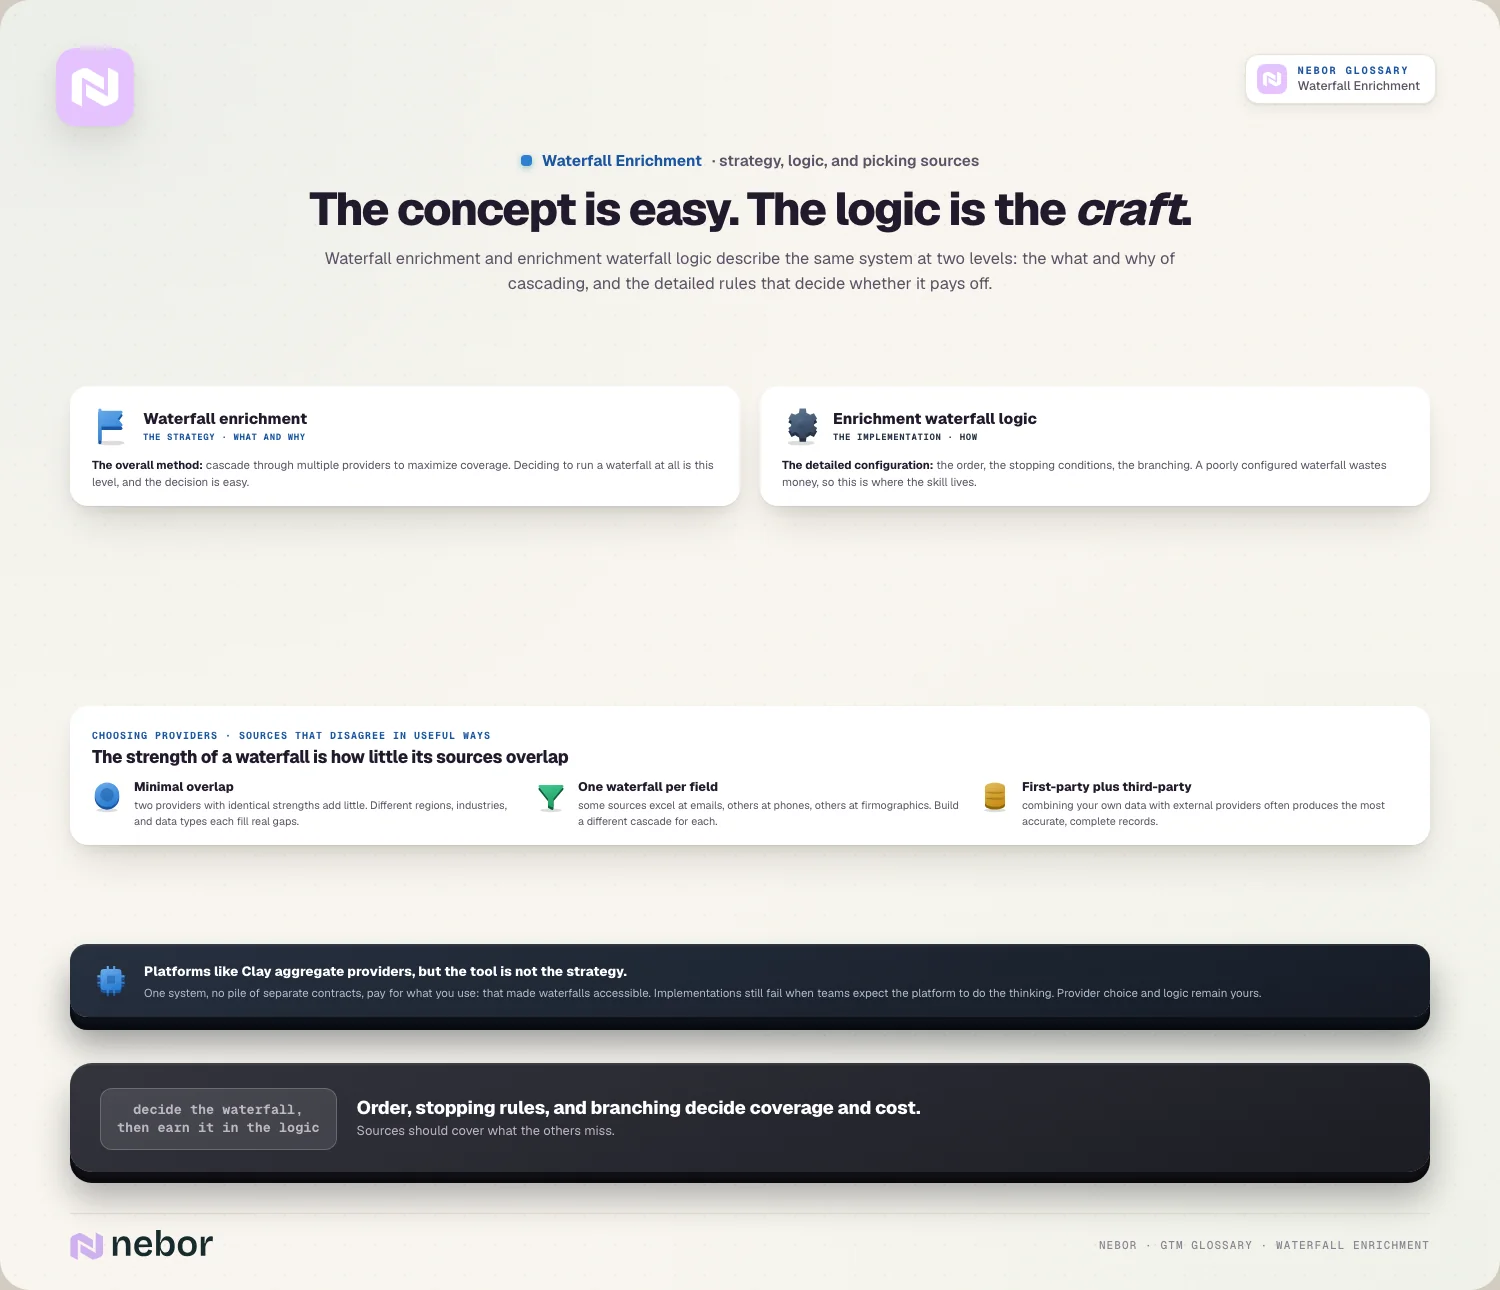
Je eigen records horen er ook bij. Het loont om first-party en third-party data tegen elkaar af te wegen, want wat je al hebt combineren met externe providers levert vaak de meest juiste en complete records op.
Heb je een contract nodig met elke dataprovider?
Niet meer. Vroeger betekende het aparte abonnementen en integraties voor elke provider. Dat was zo duur en ingewikkeld dat veel teams het opgaven en één bron gebruikten.
Platforms bundelen de providers nu voor je. Tools zoals Clay brengen veel databronnen samen op één plek, zodat je betaalt voor wat je gebruikt en de cascade in één systeem inricht, zonder een stapel contracten te beheren. Door die verschuiving werd waterfall enrichment haalbaar voor kleinere teams.
De tool is nog steeds niet de strategie. Verwachten dat het platform het denkwerk doet, is een van de redenen dat de meeste Clay-implementaties mislukken, want de keuze van providers en de logic bepalen nog steeds het resultaat.
Waterfall enrichment op een vast ritme draaien
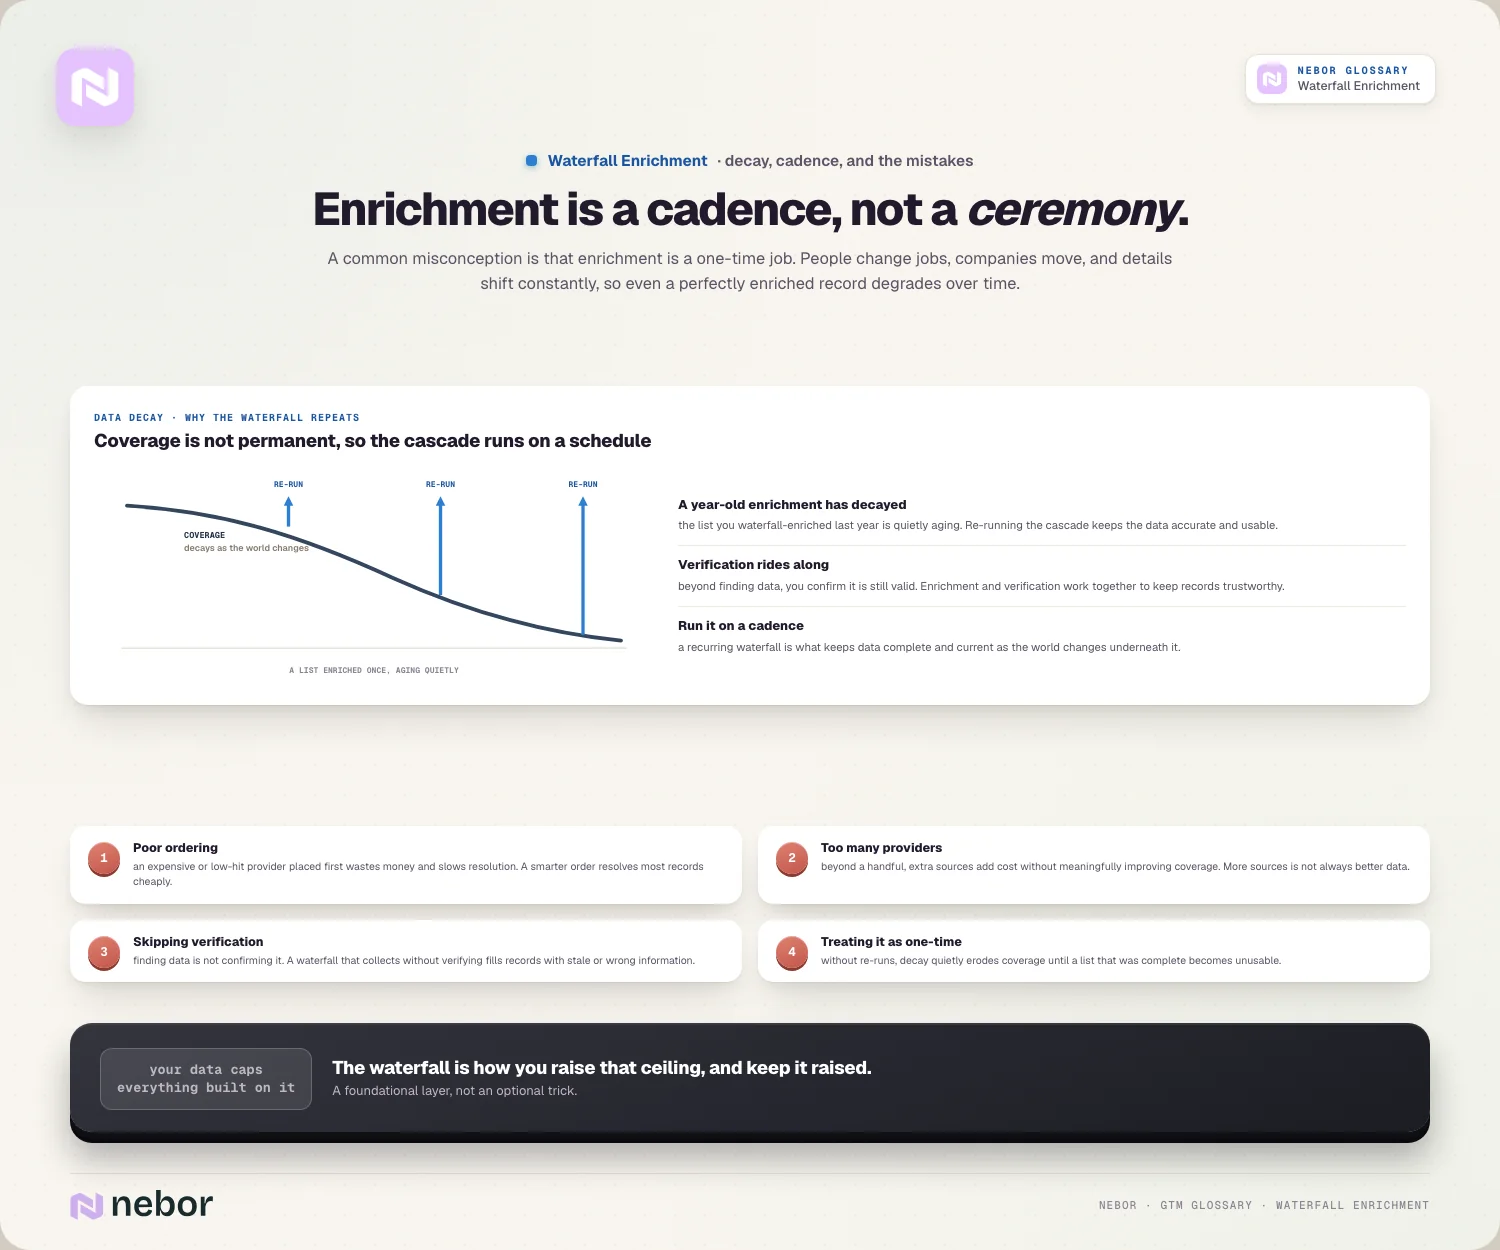
Een veelvoorkomend misverstand is dat enrichment een eenmalige klus is. Data decay laat zien dat het anders zit: mensen wisselen van baan, bedrijven verhuizen en gegevens verschuiven voortdurend, dus zelfs een perfect verrijkt record gaat na verloop van tijd achteruit.
Alleen al baanwissels houden die klok draaiende. Volgens cijfers van het Bureau of Labor Statistics lag de mediane diensttijd van werknemers in de VS in januari 2026 op 4,1 jaar, dus elk jaar vertrekt een flink deel van elke contactlijst naar een andere baan.
Data vinden is iets anders dan bevestigen dat die nog klopt, dus enrichment en verificatie werken samen. De cascade op een vast ritme herhalen, in plaats van één keer, houdt records volledig en actueel naarmate ze ouder worden.
De meeste waterfalls die tegenvallen, zijn opgezet met een van deze fouten, en we komen ze steeds weer tegen in de builds die we overnemen:
Een slechte volgorde verspilt het meeste geld. Een dure provider of een met een lage hit rate vooraan vertraagt het oplossen, terwijl een slimmere volgorde de meeste records goedkoop oplost.
Te veel providers komt daarna. Boven een handvol voegen extra bronnen kosten toe zonder de dekking echt te verbeteren, dus meer bronnen betekent niet altijd betere data.
Verificatie overslaan ondermijnt wat je hebt verzameld. Een waterfall die verzamelt zonder te verifiëren, kan records vullen met verouderde of foute informatie.
Het als eenmalig behandelen laat de winst wegrotten. Zonder herhaalde runs vreet verval je dekking aan, tot een lijst die compleet was onbruikbaar wordt.
Samenvatting
Geen enkele B2B-dataprovider heeft alles, en dat gaat niet veranderen. Bronnen achter elkaar zetten is de enige manier om voorbij de blinde vlekken van één provider te komen. Goed gedaan verhoog je de dekking en houd je de prijs per gevuld veld laag.
Het concept past in één zin. De resultaten komen uit de configuratie: welke providers je per veld kiest, in welke volgorde ze draaien, wanneer de cascade stopt en of wat hij vindt wordt geverifieerd en ververst.
De opbrengst merk je in alles wat data gebruikt. Een waterfall maakt data enrichment met firmografische data of technografische data bijna compleet. Hij maakt van list building een lijst die je echt kunt bereiken. En hij laat lead scoring en filteren op je ideal customer profile werken met volledige records, zonder te gokken op basis van gaten. Het is een basislaag van elk go-to-market-systeem, zeker zodra je sales prospecting op schaal automatiseert.
Zoek je de juiste volgorde van providers liever niet uit met vallen en opstaan? Dan zetten we de cascade op in het Clay-account dat je al hebt, testen we hem op een sample van je lijst en laten we tabellen achter die je team kan lezen en aanpassen.
Veelgestelde vragen
Wat is het verschil tussen waterfall enrichment en data enrichment?
Data enrichment is het aanvullen van ontbrekende gegevens, zoals e-mailadressen, telefoonnummers, functietitels of bedrijfsgrootte, in records die je al hebt. Waterfall enrichment is één manier om dat te doen. In plaats van die gegevens uit één provider te halen, bevraag je meerdere providers in een vaste volgorde en ga je pas naar de volgende als de vorige niets vindt. Het doel is hetzelfde, maar met meer bronnen en een hogere dekking.
Welke gegevens heb je nodig om met waterfall enrichment te beginnen?
Voor een zakelijk e-mailadres begin je meestal met de volledige naam van de persoon en het domein van het bedrijf. Een LinkedIn-profiel-URL maakt de match betrouwbaarder. De e-mailwaterfall van Clay gebruikt bijvoorbeeld het bedrijfsdomein als belangrijkste input, raadt aan persoonlijke LinkedIn-URL's toe te voegen en noemt volledige naam plus bedrijfsnaam als alternatief. Voor bedrijfsdata is een schoon domein meestal genoeg. Hoe schoner je input, hoe meer elke provider in de keten kan vinden.
Welke tools bieden waterfall enrichment?
Data-orchestratieplatforms zoals Clay zijn de bekendste optie. Ze koppelen veel providers in één workspace, laten je per veld de volgorde bepalen en rekenen af in credits in plaats van met losse contracten. Salesdatabases zoals Apollo hebben ook een waterfall die gekoppelde externe bronnen afgaat, in een volgorde die jij bepaalt, tot er een e-mailadres of telefoonnummer terugkomt. Je kunt er ook zelf een bouwen met provider-API's en een automatiseringstool, maar dat vraagt meer onderhoud.
Hoe wordt waterfall enrichment afgerekend?
Er is geen vaste prijs. De meeste platforms rekenen in credits, en lastige velden kosten meer: bij FullEnrich kost een zakelijk e-mailadres 1 credit en een mobiel nummer 10. De belangrijkere vraag is of een lookup zonder resultaat geld kost. Clay geeft credits terug als een provider geen e-mailadres vindt. Volgens de documentatie van Apollo rekenen sommige gekoppelde bronnen alleen bij resultaat en andere ook als ze niets vinden. Check dat per provider voordat je de volgorde bepaalt.
Wat is het verschil tussen waterfall en parallelle enrichment?
Bij parallelle enrichment stuur je elk record tegelijk naar alle providers en kies of combineer je daarna de antwoorden. Bij waterfall enrichment vraag je providers één voor één en stop je zodra een provider goede data teruggeeft. Parallel kan sneller zijn en laat je bronnen met elkaar vergelijken, maar je bevraagt elke provider voor elk record, en dat kost meestal meer. Een waterfall is doorgaans goedkoper, omdat de latere, duurdere providers alleen de records zien die eerder gemist zijn.
Mag waterfall enrichment onder de AVG?
De methode zelf is neutraal, maar de data die je verzamelt zijn persoonsgegevens, dus de gewone regels gelden. Je hebt een grondslag nodig, bij B2B-outreach vaak gerechtvaardigd belang, en je moet mensen laten weten dat je hun gegevens hebt. De Britse toezichthouder ICO schrijft in zijn richtlijn over databrokers dat de verzekering van een broker dat zijn data compliant is niet genoeg is. Controleer dus elke provider in je keten.
Wat gebeurt er met records die de waterfall niet kan verrijken?
Die blijven leeg, en die markeer je als niet gevonden in plaats van ze blanco te laten, zodat niemand ze aanziet voor records die nooit verwerkt zijn. Bepaal daarna wat een nieuwe poging waard is. Opnieuw proberen met andere input, zoals een LinkedIn-URL in plaats van naam en bedrijf, kan alsnog een match opleveren. Belangrijke accounts kun je handmatig uitzoeken. De rest neem je mee in de volgende geplande run, want providers werken hun data steeds bij.
Hoe beïnvloeden catch-all-adressen waterfall enrichment?
Een catch-all-domein accepteert mail voor elk adres, dus een validator kan niet bevestigen dat een specifieke mailbox bestaat. In een waterfall telt dat, omdat de cascade stopt zodra een e-mailadres als geldig geldt. In de e-mailwaterfall van Clay worden catch-all-adressen standaard als geldig behandeld. Weegt deliverability zwaarder dan volume, zet die instelling dan om, zodat catch-alls als ongeldig tellen en de waterfall verder zoekt naar een veiliger adres.
Kan waterfall enrichment automatisch draaien op nieuwe inbound leads?
Ja. Je kunt de cascade laten starten bij een formulierinzending, een nieuw record in je CRM of een webhook, zodat niemand op een knop hoeft te drukken. Twee dingen veranderen ten opzichte van batchwerk. Providers worden één voor één geprobeerd, dus het resultaat duurt langer dan één lookup, en je routing moet wachten tot de waterfall klaar is. Je hebt ook toegangsregels nodig, zoals gratis e-maildomeinen of bestaande klanten overslaan, zodat automatische runs geen credits verspillen.
Mogen resultaten uit de waterfall bestaande data in je CRM overschrijven?
Standaard liever niet. Laat enrichment alleen lege velden vullen en sta overschrijven per veld toe waar nieuwere data duidelijk beter is, zoals een functietitel na een baanwissel. Bescherm velden die sales met de hand bijwerkt en alles wat met toestemming te maken heeft. Check ook elke route waarlangs data je CRM binnenkomt. In HubSpot kan de workflowactie Enrich record bijvoorbeeld eigenschappen overschrijven, ongeacht de overschrijfregels die je per eigenschap hebt ingesteld.
Deel dit bericht
Enrichment
Data
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen

Klaar om je pipeline te bouwen