In this post:
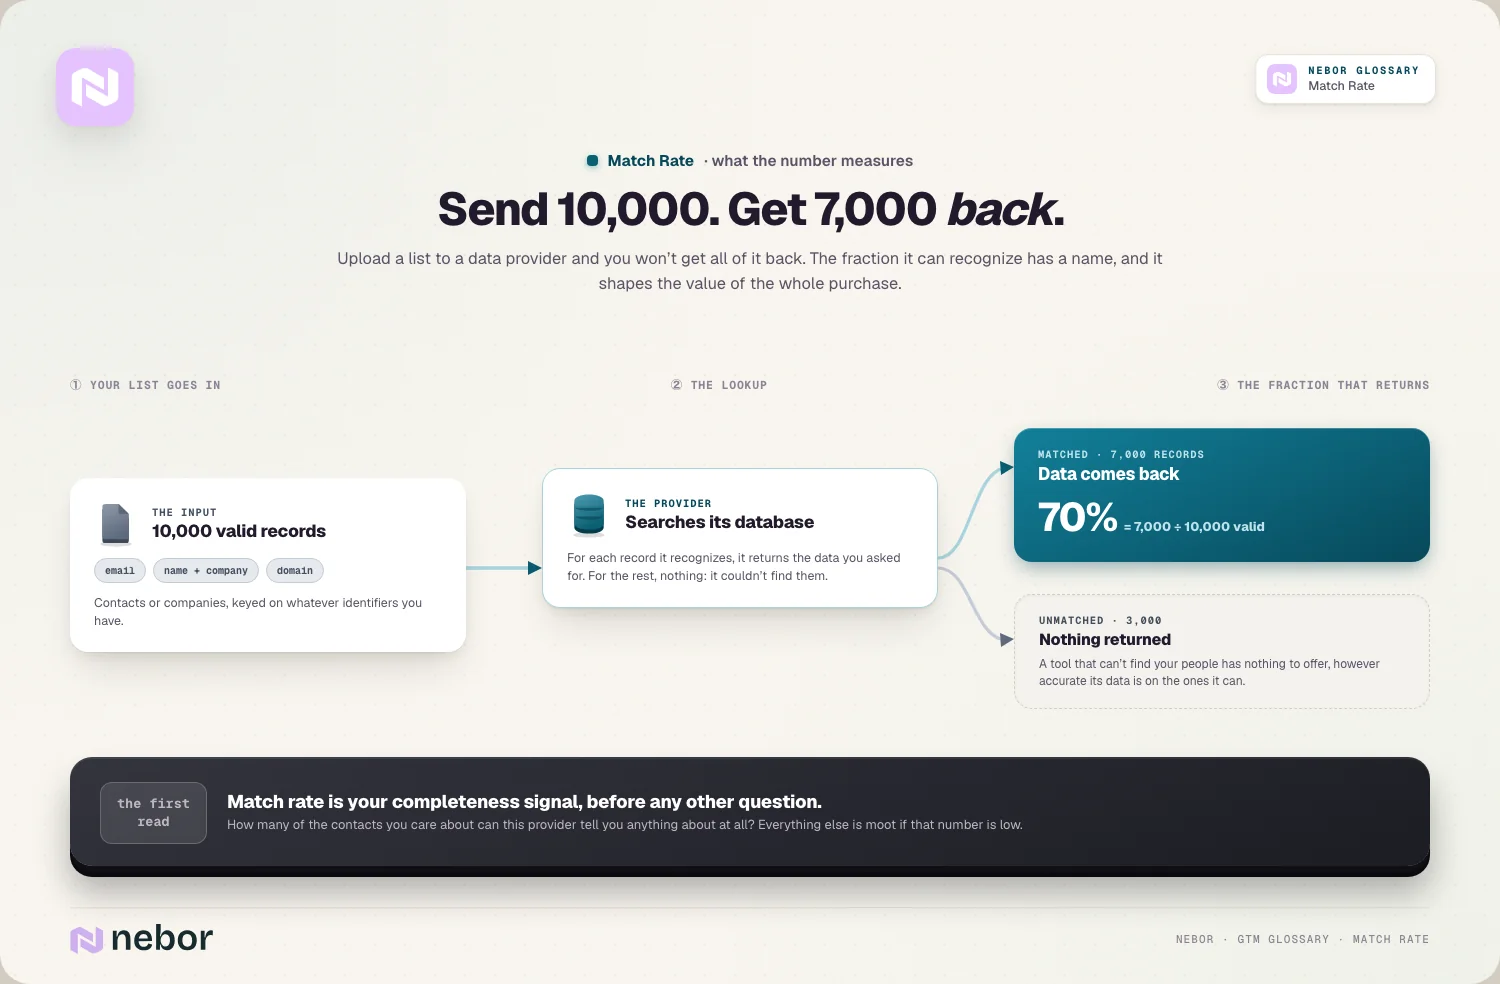
Match rate is het percentage van de records die je naar een dataprovider of advertentieplatform stuurt dat die partij aan een eigen record kan koppelen en waarvoor ze iets teruggeeft. Stuur je 10.000 geldige contacten naar een enrichmenttool en krijg je voor 7.000 daarvan data terug, dan is je match rate 70%.
Twee groepen gebruiken het woord, en ze bedoelen er iets anders mee. Wie met data enrichment werkt, bedoelt hoeveel van een lijst een provider herkende. Paid-mediateams bedoelen het aandeel van een geüploade klantenlijst dat LinkedIn, Meta of Google aan hun eigen gebruikers kon koppelen. De rekensom is precies dezelfde. Wat het getal je vertelt, en wat je aan een lage uitkomst kunt doen, verschilt.
In beide gevallen krijgt het getal meer vertrouwen dan het verdient. Een match zegt alleen dat de provider een record vond waarvan hij denkt dat het bij jouw record hoort. Het zegt niet of dat record actueel is, of zelfs of het om de juiste persoon gaat. En de match rate op de salesdeck van een leverancier is gemeten op een lijst die niet van jou was.
TL;DR
Match rate is het aantal gematchte records gedeeld door het aantal geldige records dat je stuurde. Bepaal vóór de upload wat als geldig telt, want duplicaten en rijen zonder bruikbare identifier drukken het getal zonder dat je iets over de provider leert.
Fill rate is een apart getal. Een gematcht contact kan terugkomen zonder het telefoonnummer of de functietitel die je nodig had. Houd daarom naast de match rate ook de rate bij voor het veld waar je play op draait.
Advertentieplatforms hanteren hun eigen regels. LinkedIn matcht alleen leden met een geverifieerd e-mailadres en toont "minder dan 5%" tot er 300 leden matchen. Google toont pas een rate als er minstens 100 rijen matchen. Meta en Google vergelijken allebei identifiers die met SHA-256 zijn gehasht, en dus geen ruwe gegevens.
Je input bepaalt het grootste deel van de uitkomst. Een bedrijfsdomein of een zakelijk e-mailadres matcht veel betrouwbaarder dan een naam. Daarom werkt de ingebouwde enrichment van HubSpot alleen vanaf voornaam, achternaam, zakelijk e-mailadres en bedrijfsdomein.
Gematcht is nog niet juist. Een provider die 90% van een lijst matcht met 60% accuratesse, laat je 54% bruikbare records over. Een provider die 70% matcht met 92% accuratesse, laat je ongeveer 64% over.
Zie de match rate van een leverancier als een claim die op de lijst van iemand anders is gemeten. Het cijfer waarop je kunt plannen, komt uit een test op records die je al kent, uitgesplitst per segment.
Een waterfall van providers tilt de gecombineerde rate omhoog, omdat elke bron een deel van het gat dicht dat de vorige liet. Elke extra bron voegt wel minder toe dan de bron ervoor.
Match rate berekenen zonder de provider te flatteren of tekort te doen
De formule is het aantal gematchte records gedeeld door het aantal aangeleverde geldige records, maal 100. De meeste discussies over een match rate gaan over de onderkant van die breuk.
Een Rotterdams bedrijf dat software voor vrachtvervoer maakt, exporteert 10.600 contacten uit zijn CRM om een nieuwe provider te testen. Vierhonderd rijen zijn duplicaten, en nog eens 200 hebben geen e-mailadres en geen bedrijfsdomein, dus die kan geen enkele provider ooit vinden. Er blijven 10.000 geldige records over. De provider geeft voor 7.000 daarvan data terug, een match rate van 70%. Deel je door de ruwe export, dan kom je op 66%. Dat lagere getal meet alleen hoe rommelig de export was.
De omgekeerde fout flatteert de provider. Gooi je vóór de test elk record zonder zakelijk e-mailadres eruit, dan komen de lastige gevallen nooit in de noemer terecht en ziet de rate er beter uit dan hij op een echte lijst zal zijn. Leg dus vóór de eerste upload vast wat "geldig" betekent, pas die regel op dezelfde manier toe op elke provider die je vergelijkt, en doe eerst de voor de hand liggende data hygiene (duplicaten, lege rijen, testrecords).
Spreek daarna af wat als match telt. Sommige tools melden een record als gematcht als ze het bedrijf vonden en de persoon niet, of als ze één veld teruggaven waar je niet om vroeg. Bij een contactlijst zouden wij een record pas als match tellen als de provider de persoon zelf teruggaf. Alleen de werkgever is te weinig.
Match rate, fill rate en het veld dat je echt nodig had
Een gematcht record is nog geen compleet record. De provider kan Anna bij Nordwind herkennen en toch geen telefoonnummer van haar hebben, en daar komt fill rate om de hoek kijken. Match rate telt de records die met iets terugkwamen. Fill rate telt per veld hoe vaak datgene waar je naar zocht erin stond.
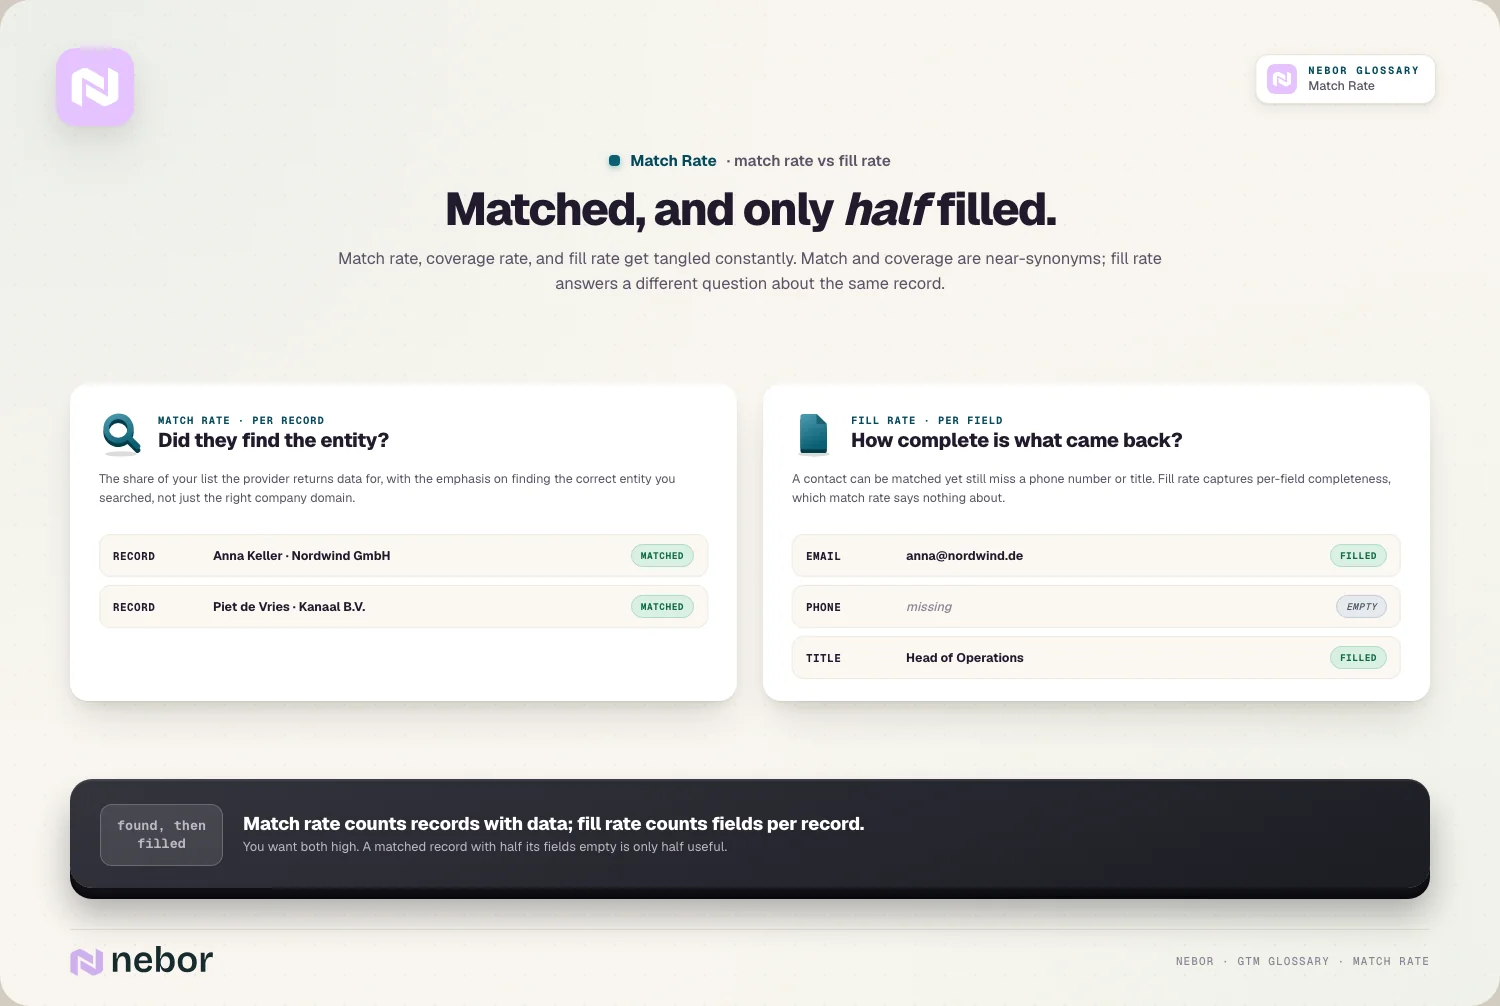
Terug naar Rotterdam. Stel dat 2.900 van de 7.000 gematchte contacten terugkwamen met een direct nummer. De match rate is nog steeds 70%, maar de fill rate voor telefoonnummers is ongeveer 41% op de gematchte records en 29% op de hele geldige lijst. Leunt het team achter die test op bellen, dan is 29% het getal dat bepaalt of de provider zijn geld waard is.
Je ziet ook coverage rate gebruikt worden voor ongeveer hetzelfde idee als match rate. Leveranciers wisselen de twee vrij uit. Vraag dus op welke van de twee een cijfer slaat en hoe het is geteld, in plaats van het aan te nemen.
Match rates op advertentieplatforms volgen andere regels
Uploadt marketing een klantenlijst of een lijst met doelaccounts naar een advertentieplatform, dan matcht het platform je rijen tegen zijn eigen gebruikers. Een B2B-database komt er niet aan te pas. Elk platform doet het anders, en de rapportage zet mensen die aan enrichmenttools gewend zijn makkelijk op het verkeerde been.
Waar je uploadt | Waartegen het matcht | Welke match keys het accepteert | De regel om te onthouden |
|---|---|---|---|
Een enrichmentprovider, Clay of HubSpot | De eigen database van de provider met mensen en bedrijven | Wat de tool ondersteunt, meestal e-mailadres, domein, naam en bedrijf, LinkedIn-URL | De ingebouwde enrichment van HubSpot werkt alleen vanaf voornaam, achternaam, zakelijk e-mailadres en bedrijfsdomein |
LinkedIn Matched Audiences (contactlijst) | Leden met een geverifieerd e-mailadres | E-mailadressen, of een bedrijfslijst voor targeting op accounts | De rate staat op minder dan 5% tot er minstens 300 ledenaccounts matchen |
Meta Custom Audiences op basis van een klantenlijst | Mensen op Facebook en Instagram | E-mailadres, telefoonnummer, naam, locatie, geboortedatum en je eigen klant-ID | Persoonsgegevens moeten met SHA-256 worden gehasht, en e-mailadressen moeten vóór het hashen zonder spaties en in kleine letters staan |
Google Customer Match | Google-gebruikers | E-mailadres, telefoonnummer, voor- en achternaam, land en postcode | Een match rate verschijnt pas als minstens 100 rijen aan unieke gebruikers zijn gekoppeld |
De details komen uit de eigen documentatie van de platforms. De helppagina van LinkedIn over match rates definieert de rate als het aandeel regels dat in de afgelopen zeven dagen aan ledenaccounts is gematcht, en waarschuwt dat contacttargeting alleen leden met een geverifieerd e-mailadres matcht. De documentatie van Meta over Custom Audiences beschrijft de regels voor hashen en normaliseren, en zegt dat meerdere keys per record de match rate verhogen. De pagina van Google over match rates in Customer Match voegt een zin toe die je moet onthouden: de rate is geen indicatie van hoe de lijst gaat presteren.
B2B-lijsten hebben het op de consumentenplatforms meestal moeilijk. Een bestand met zakelijke adressen wordt gematcht tegen accounts die veel mensen met een privé-e-mailadres of een telefoonnummer hebben aangemaakt. Een prima CRM-export kan dus laag uitkomen op Meta of Google en een stuk beter op LinkedIn. Voeg telefoonnummers en namen toe die je al hebt, dan heeft het platform meer om mee te werken. Privé-e-mailadressen kopen om een match rate voor advertenties op te krikken, is een andere beslissing met juridisch gewicht in Europa, en zelden de moeite waard.
Het getal 300 duikt weer op als je op een lijst verder bouwt. De predictive audiences van LinkedIn hebben minstens 300 gematchte ledenaccounts achter de seed nodig. Een kleine, strak afgebakende accountlijst kan dus te dun zijn om op te bouwen, ook als elke persoon erop precies klopt. Wat LinkedIn doet met een seed die over die lat komt, lees je bij B2B lookalike audiences.
Wat je instuurt, bepaalt het grootste deel van je match rate
Elke lookup begint bij de identifiers die je aanlevert, en sommige zijn veel makkelijker te vinden dan andere. Een bedrijfsdomein wijst naar precies één bedrijf. Een zakelijk e-mailadres wijst meestal naar precies één persoon. Een voornaam plus een bedrijfsnaam wijst naar een shortlist, en een naam alleen naar zo ongeveer iedereen. Hoeveel zekerheid elk soort key je kan geven, lees je uitgebreider bij identity resolution. Voor match rate komt het hierop neer: dezelfde provider haalt heel verschillende cijfers op twee lijsten, afhankelijk van welke keys erin zitten.
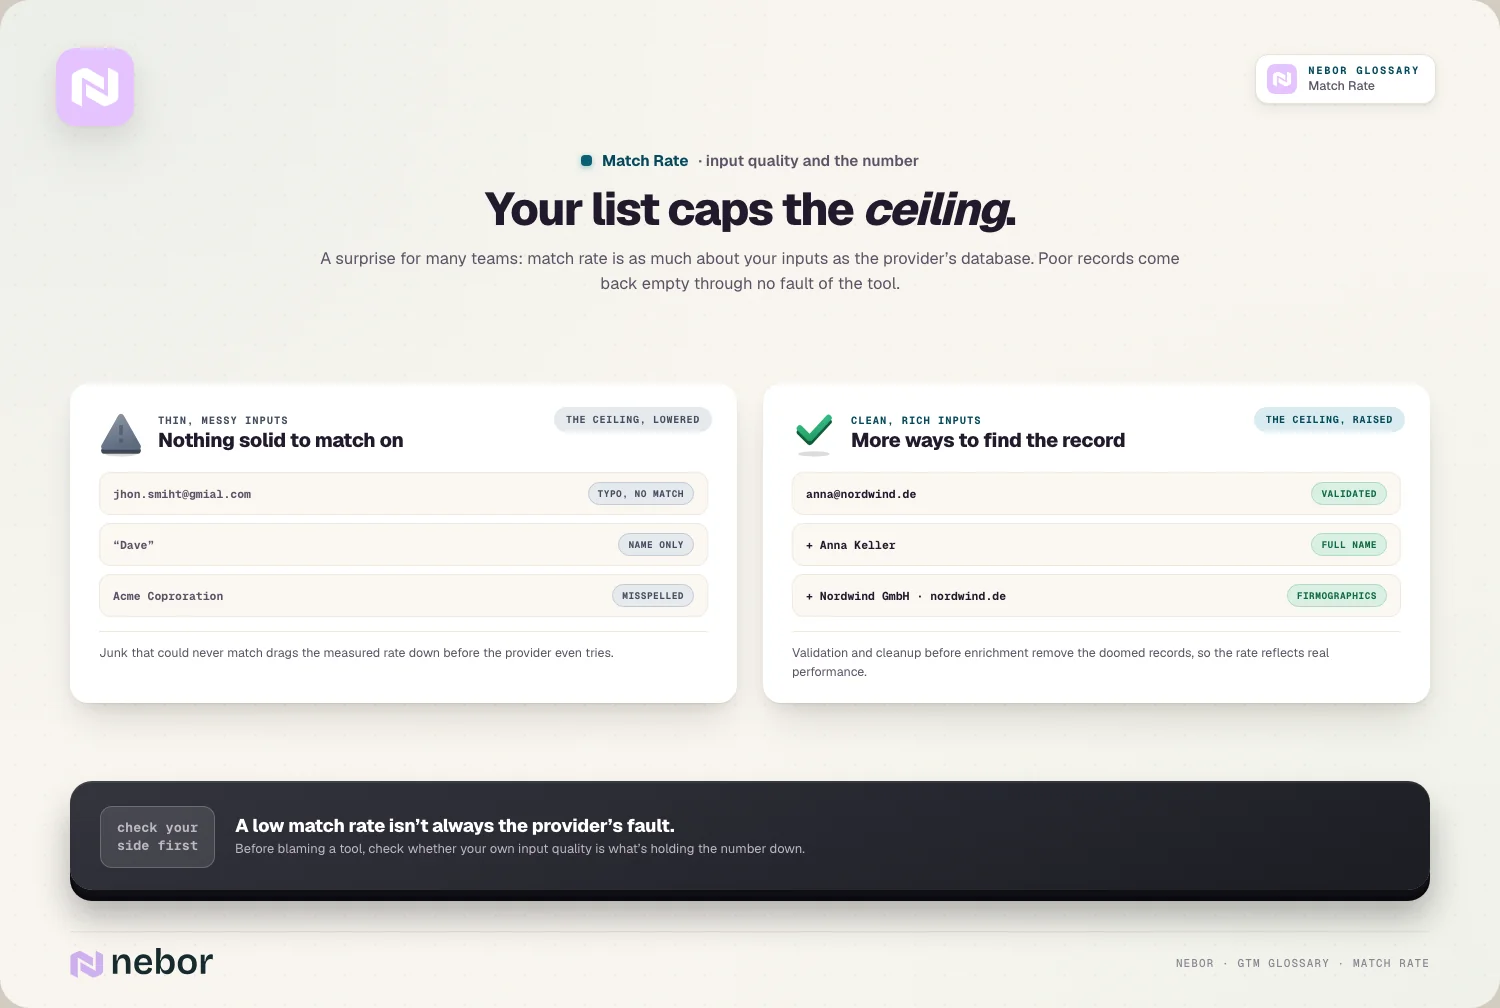
Typfouten richten meer schade aan dan mensen denken. Een verkeerd gespeld e-mailadres, een bedrijfsnaam met een losse rechtsvorm erachter ("Nordwind GmbH" in het ene systeem, "Nordwind" in het andere) of een freemailadres op de plek van een zakelijk adres komen allemaal leeg terug, en niets daarvan ligt aan de provider. Velden gelijktrekken met data normalization en adressen vóór een test door e-mailvalidatie halen, ruimt het meeste daarvan op. Een domein aanvullen vanuit je firmografische data waar je alleen een bedrijfsnaam hebt, helpt vaak meer dan van provider wisselen.
Bedrijven en contacten gedragen zich ook anders, dus rapporteer ze apart. Bedrijfsmatching op basis van een domein ligt meestal ruim voor op contactmatching, omdat een bedrijf zijn domein jarenlang houdt terwijl mensen van baan, functie en adres wisselen. Een provider kan uitblinken in firmografische en technografische data en middelmatig zijn in het vinden van de juiste persoon binnen elk account. Eén gemengd cijfer verbergt welk van de twee het is.
Een gematcht record kan nog steeds het verkeerde record zijn
Een match is de overtuiging van de provider dat zijn record en het jouwe dezelfde entiteit beschrijven. Soms klopt die overtuiging niet. Twee mensen met dezelfde naam werken bij hetzelfde bedrijf. Het contact is twee jaar geleden vertrokken en de provider heeft het nooit gemerkt. Medewerkers van een dochterbedrijf worden gekoppeld aan het domein van het moederbedrijf. Elk van die gevallen telt mee in de match rate, en elk ervan stuurt een rep naar de verkeerde persoon.
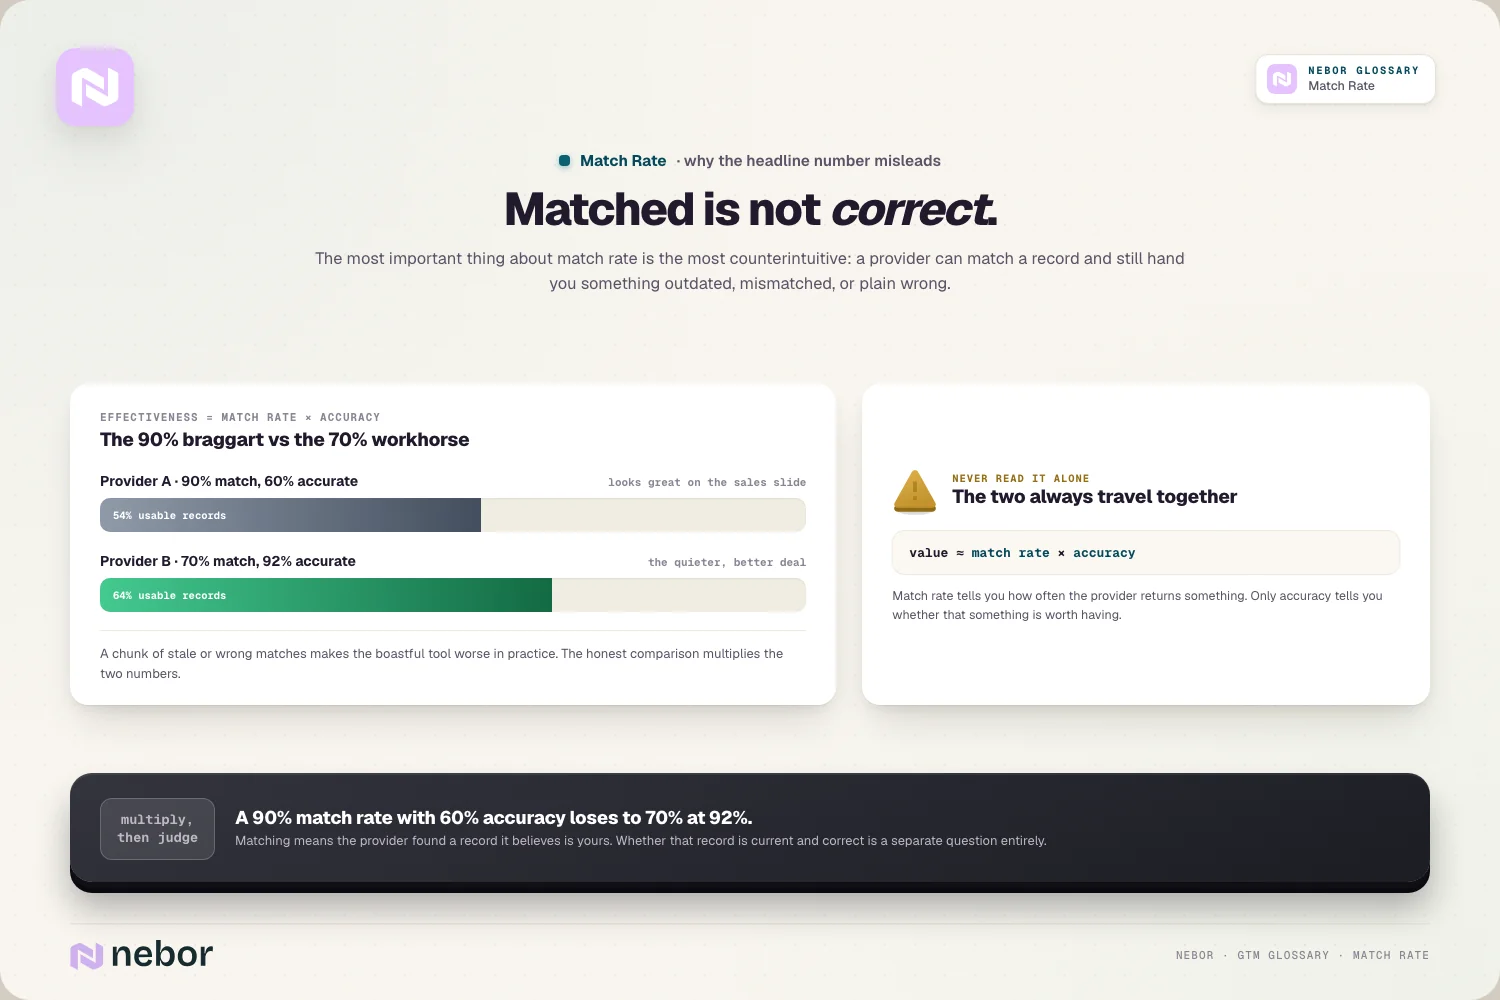
De oplossing is match rate naast accuratesse te lezen. Op 10.000 geldige records laat een provider die 90% matcht, waarvan 60% juist, je 5.400 bruikbare records over. Een provider die 70% matcht met 92% accuratesse laat er 6.440 over, ongeveer 64% van de lijst. Rekenen ze allebei €0,20 per lookup, dan kost de test van €2.000 bij de eerste provider ongeveer €0,37 per bruikbaar record en bij de tweede €0,31. De provider met het kleinere kopcijfer is de betere koop, en dezelfde vergelijking staat centraal in elke test als je een data provider kiest.
Accuratesse vraagt om eigen controles, los van het matchen. Haal teruggegeven e-mailadressen door contact verification, controleer een handvol teruggegeven functietitels met de hand, en onthoud dat zelfs een juiste match vanaf de dag dat hij binnenkomt veroudert door data decay. Een match rate die vorig jaar is gemeten, zegt weinig over de records die je deze maand mailt.
Hoe je de match rate van een leverancier leest
De meeste gepubliceerde match rates komen van leveranciers, en ze zijn gemeten zoals de leverancier dat wilde: op een lijst die de leverancier koos, met keys die de leverancier koos, volgens een definitie van "match" die de leverancier koos. Ze kunnen best kloppen. Het blijft marketing. Stel een paar vragen voordat zo'n cijfer in een business case belandt.
Op wiens lijst is het gemeten, en lijkt die op de jouwe qua land, bedrijfsgrootte en senioriteit?
Welke keys gingen erin? Een test op schone zakelijke e-mailadressen wint het elke keer van een test op namen en bedrijfsnamen.
Wat was de noemer: alles wat is geüpload, of alleen de records die de leverancier geldig vond?
Telt een resultaat met alleen het bedrijf als match op een contactlijst?
Gaat het om de rate voor elk teruggegeven veld, of voor het veld dat je koopt (een geverifieerd e-mailadres, een mobiel nummer)?
Zijn de matches gecontroleerd op accuratesse, en wanneer is de test gedraaid?
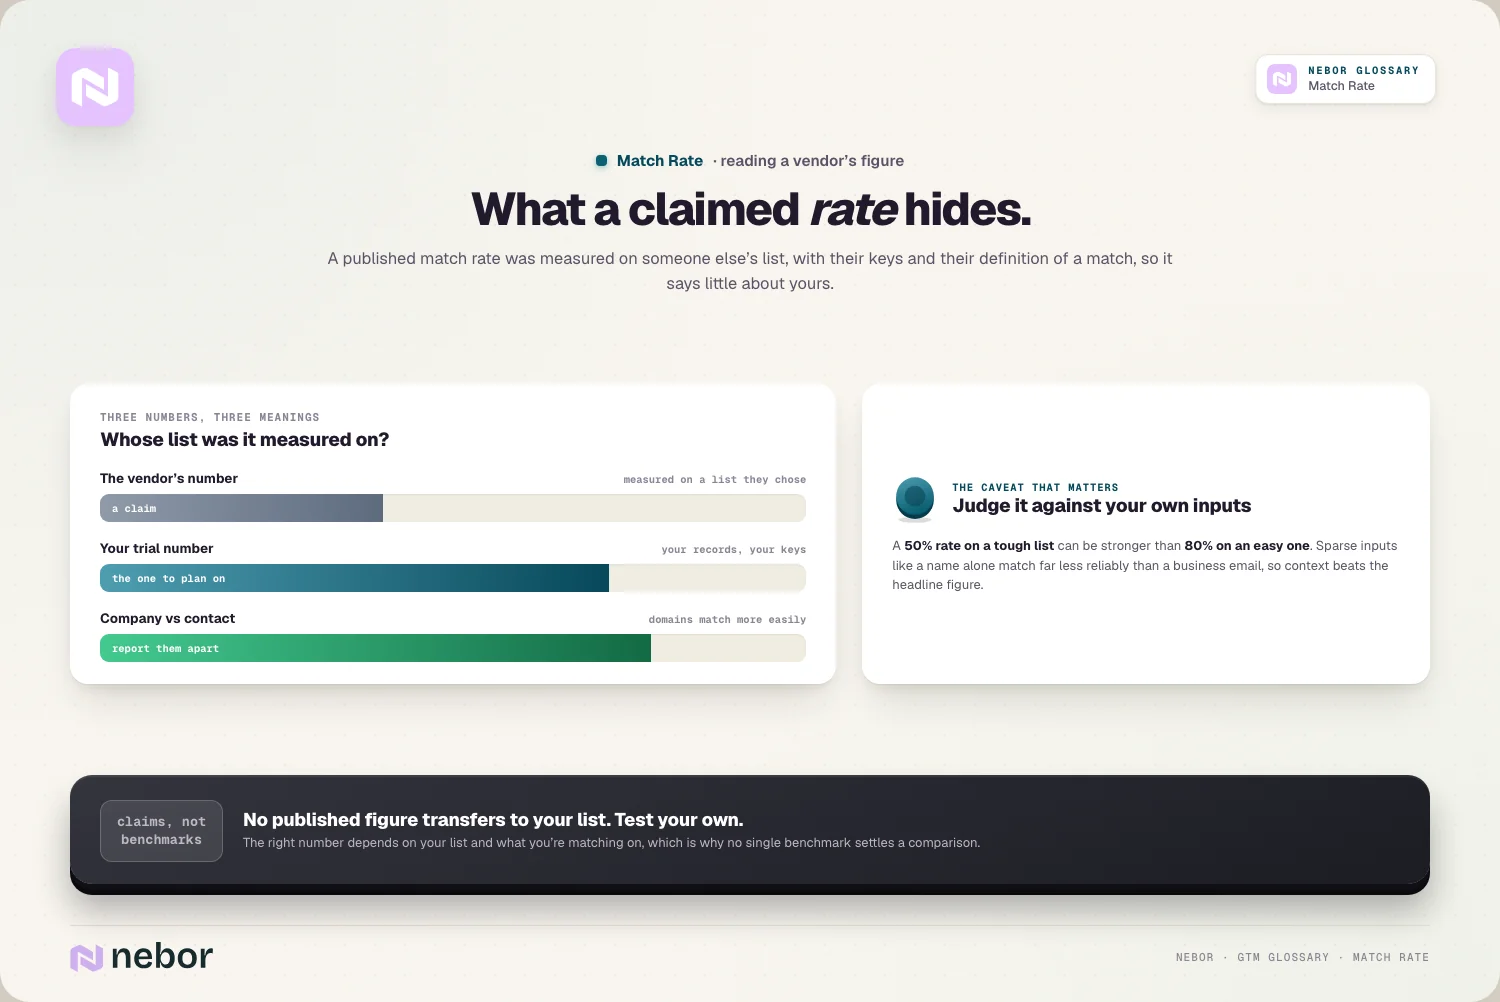
Meet het daarna zelf. Neem een paar honderd records waarvan je weet dat ze kloppen, verspreid over de segmenten waaraan je verkoopt, kort ze in tot de identifiers die je normaal zou hebben, en haal dat ene bestand door elke kandidaat. Lees de resultaten per segment, want een match rate van 50% op een lastig segment kan sterker zijn dan 80% op een makkelijk segment. Wij publiceren geen "goede" match rate voor B2B, omdat geen enkel cijfer dat we vonden was gemeten op lijsten die met die van iemand anders te vergelijken zijn.
Je match rate opkrikken met een tweede en derde bron
Geen enkele database dekt een hele markt, en de gaten verschillen per provider. Daarom zet je ze achter elkaar. Bij waterfall enrichment gaat elk record naar de eerste provider, en alleen de missers schuiven door naar de volgende bron.
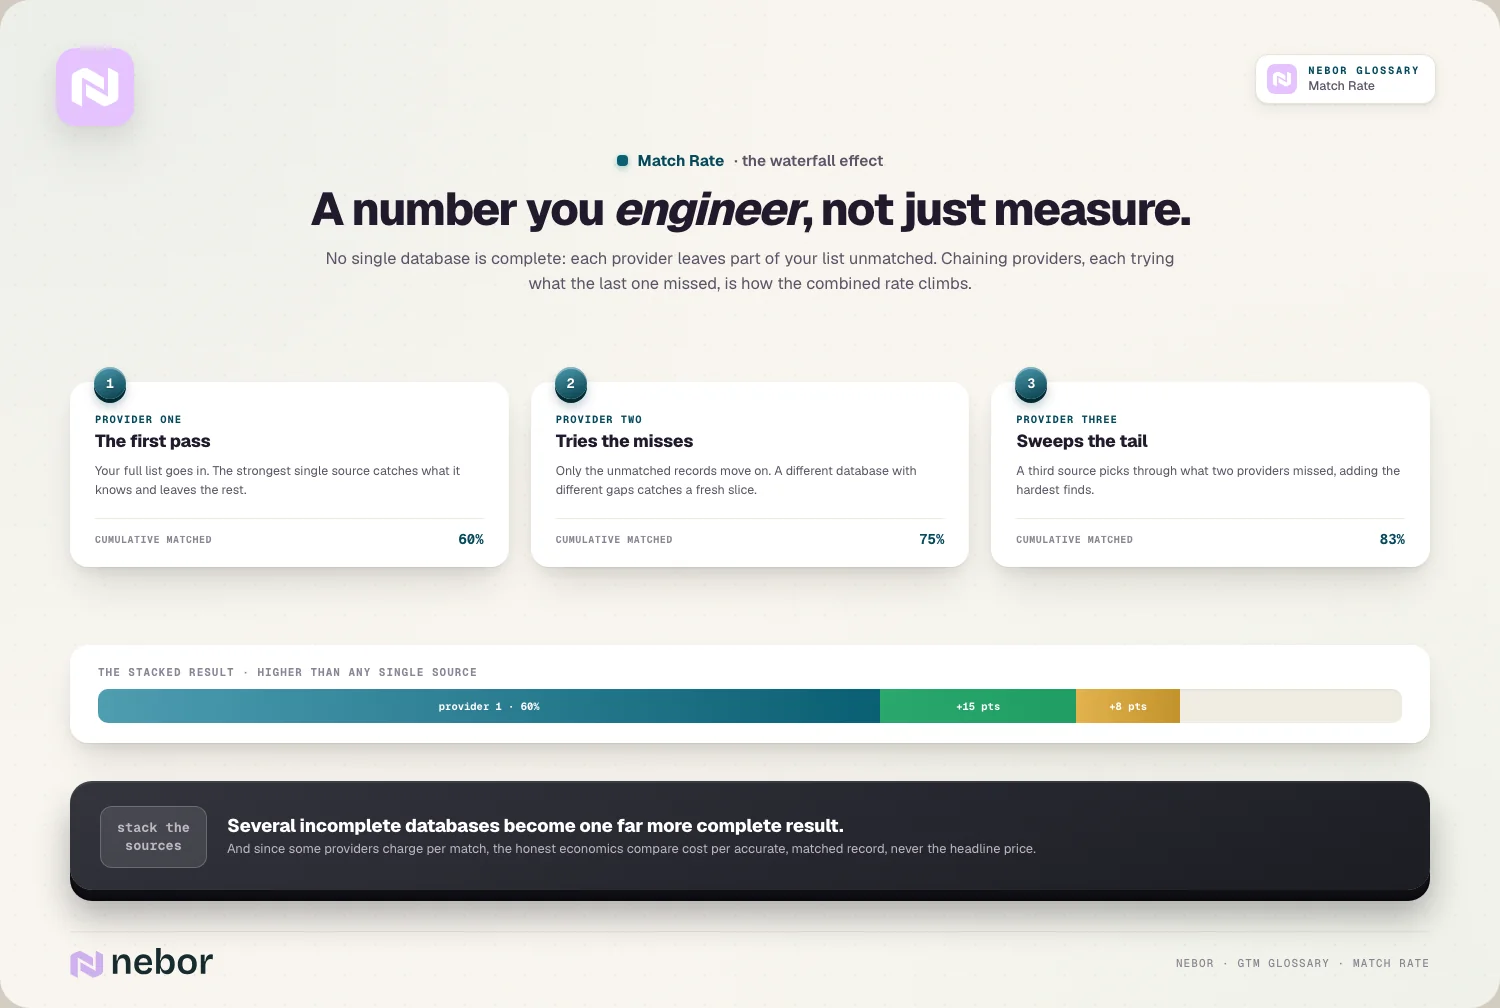
Stel je een lijst voor waarvan de eerste provider 60% matcht. De tweede pikt uit de rest nog 15 procentpunten op, waarmee de gecombineerde match rate op 75% komt, en de derde voegt er 8 aan toe voor 83%. Het patroon in dat voorbeeld is wat je mag verwachten: elke bron voegt minder toe dan de vorige, terwijl het vragen wel geld blijft kosten. Na een handvol bronnen verdienen de extra records de lookups niet meer terug.
Hoe er wordt afgerekend, telt hier mee. Sommige providers rekenen elke lookup af, gevonden of niet, andere alleen als ze iets teruggeven. Voor een e-mailwaterfall schrijft Clay in zijn les over waterfalls dat het credits teruggeeft als een provider geen e-mailadres vindt, en dat het stopt zodra er een geldig adres is gevonden. Zet de goedkope bronnen die veel vinden vooraan, dan krijgen de dure alleen de restjes voorgelegd.
Een hogere gecombineerde rate laat ook alles wat op enrichment voortbouwt op volle kracht werken, van list building tot routing en scoring. En zodra je prospecting op een vast schema laat draaien, tellen een paar procentpunten match rate elke maand op tot een flink aantal extra bereikbare contacten, zonder extra werk voor het team.
Tot slot
Match rate is een nuttige eerste vraag en een slecht eindantwoord. Het vertelt je of een provider of platform de mensen die je belangrijk vindt überhaupt kan zien. Kan dat niet, dan doet de rest van die bron er weinig toe.
Het gaat mis zodra het getal los wordt gelezen. Een rate hangt af van hoe je de noemer telde, welke keys je stuurde, of de matches klopten en op wiens lijst hij is gemeten. Houd die gelijk en het getal wordt vergelijkbaar. Laat je ze verschuiven, dan vergelijk je de beste dag van een leverancier met je eigen rommelige export.
De gewoontes die het meeste oplossen, zijn weinig glamoureus. Maak de lijst schoon voordat je test, tel bedrijven en contacten apart, zet accuratesse en fill rate naast elke match rate, en vertrouw je eigen sample meer dan de slide van wie dan ook. Die records voeden daarna de scoring, routing en outreach die op je data draaien, dus de zorg die je hier besteedt, zie je overal verderop terug.
Nebor draait zulke matchtests op records die een klant al vertrouwt, en bouwt de gekozen volgorde van providers daarna in de Clay-workspace en het CRM van de klant. Het testbestand, de resultaten en de redenering blijven bij de klant, klaar om opnieuw te draaien als een provider zijn data of zijn prijzen verandert.
Veelgestelde vragen
Is match rate hetzelfde als coverage rate?
Bijna, en veel leveranciers gebruiken de twee woorden door elkaar. Allebei beschrijven ze het aandeel van je lijst waarvoor een provider data teruggeeft. Als er een verschil is, legt match rate meestal de nadruk op de vraag of het teruggegeven record de juiste entiteit is, terwijl coverage rate vaak wordt genoemd voor één specifiek veld, zoals gevonden e-mailadressen. Omdat de definities per tool verschuiven, vraag je altijd hoe een cijfer is geteld voordat je er twee vergelijkt.
Wat is een goede match rate voor B2B data enrichment?
Er bestaat geen betrouwbaar universeel cijfer. De ranges die online rondgaan, komen van leveranciers en bureaus die meten op lijsten die in niets op de jouwe lijken. De rate die je haalt, hangt af van je landen, bedrijfsgroottes, de mix van senioriteit en welke identifiers je meestuurt. Een betere vraag is of de rate van een provider op je eigen sample, vermenigvuldigd met de accuratesse, genoeg bruikbare records oplevert tegen een prijs per record waar je mee kunt leven.
Waarom is de match rate van mijn contactlijst op LinkedIn zo laag?
LinkedIn matcht contactlijsten alleen tegen leden met een geverifieerd e-mailadres, en toont de rate als minder dan 5% tot er minstens 300 ledenaccounts matchen. Kleine lijsten zien er daardoor slechter uit dan ze zijn. Opmaak is de andere veelvoorkomende oorzaak, dus leg de kolomkoppen en de indeling van je bestand naast de uploadrichtlijnen van LinkedIn. Dubbele rijen verklaren ook waarom de gematchte audience kleiner kan uitvallen dan de rate doet vermoeden.
Waarom matchen B2B-e-maillijsten slecht op Meta en Google?
Die platforms matchen tegen de gegevens waarmee mensen hun persoonlijke account hebben aangemaakt, en dat is vaak een privé-e-mailadres of een telefoonnummer in plaats van een zakelijk adres. Een lijst met zakelijke adressen vindt daar dus minder mensen dan op LinkedIn. Stuur je elke identifier mee die je rechtmatig hebt, zoals telefoonnummer, voor- en achternaam en land, dan heeft het platform meer manieren om elke persoon te vinden.
Wordt een klantenlijst anoniem onder de AVG (GDPR) als je hem hasht?
Nee. Hashen zet een e-mailadres vóór de upload om in een code. Dat beschermt het onderweg, maar de code wijst nog steeds naar één persoon en kan weer aan die persoon worden gekoppeld. Dat is precies wat het advertentieplatform ermee doet. Onder de AVG blijven het persoonsgegevens, dus je hebt nog steeds een rechtsgrond nodig om de lijst te uploaden, en je checkt de voorwaarden van het platform het best met degene die privacy regelt.
Wat doe je met records die niet matchen?
Kijk eerst waarom, voordat je iets verwijdert. Records zonder match hebben vaak een typfout, een freemailadres of een ontbrekend domein, en als je dat herstelt, kunnen ze alsnog matchen. Andere horen bij kleine of heel jonge bedrijven die providers nauwelijks dekken, en die vindt een tweede bron in een waterfall misschien wel. Wat daarna overblijft, komt in aanmerking om te archiveren, zeker als er al lange tijd niemand op heeft gereageerd.
Waarom rapporteren twee providers een andere match rate op dezelfde lijst?
Ze hebben hun databases uit verschillende bronnen opgebouwd, dus hun dekking is sterk in verschillende landen, branches en senioriteitsniveaus. Ze tellen ook anders. De een rekent een resultaat met alleen het bedrijf als match, de ander telt alleen een gevonden persoon. En de een deelt door elke rij die je uploadde, terwijl de ander rijen negeert die hij als ongeldig afwees. Vergelijk ze op hetzelfde bestand met dezelfde telregels.
Betaal je voor enrichment beter per lookup of per match?
Per match betalen is meestal gunstiger voor een lijst met gaten, omdat je niet betaalt voor records die de provider niet kan vinden. Per lookup betalen kan alsnog goedkoper uitvallen als de prijs per lookup laag is en de match rate op je lijst hoog. Reken voor beide modellen de kosten per bruikbaar record uit, met een sample van je eigen data in plaats van het voorbeeld van de leverancier.
Wat is een match key?
Een match key is het stukje informatie dat een provider of advertentieplatform gebruikt om je record in zijn eigen data op te zoeken, zoals een e-mailadres, een bedrijfsdomein, een telefoonnummer of een LinkedIn-URL. Sommige keys wijzen met bijna volledige zekerheid naar één entiteit, zoals een domein. Andere, zoals een voornaam, wijzen naar veel entiteiten. De keys die je meestuurt, bepalen het plafond van je match rate.
Deel dit bericht
Data
Enrichment
Begrippenlijst
Gerelateerde begrippen
De basis GTM-concepten begrijpen
Klaar om je pipeline te bouwen